别再把群聊当废数据了:群体智能技术正在悄悄替你做决策
上周在南京的产学研对接会,我蹲在茶歇区啃包子,旁边坐了个穿迷彩服的老板,面前摊着个磨掉漆的笔记本,翻得哗哗响。他说自己是做果园的,攒了三年的微信群聊天记录,还有几百张糊得看不清的病害照片,存在两块移动硬盘里,之前找过两拨做AI的团队,人来了翻了翻他的硬盘,摇着头说数据太脏,标注成本太高,做不了病害识别模型,给他报了个二十万的预算,他听完就跑了。
你以为的"七嘴八舌",其实是能换钱的生产资料
我当时把包子咽下去,跟他说,你找错方向了。别找那种要把数据洗得跟纯净水一样的传统AI,试试群体智能技术啊。
这东西根本不要求你先把所有聊天记录、模糊照片整理得规规矩矩,也不需要你花大价钱请专业的标注团队,把每一条内容标得明明白白。你就把这些乱糟糟的内容,分给本来就在一线跟这些事打交道的人,让他们对着内容做个三秒钟的小判断就行——比如看到一张树干流红水的照片,旁边配了"掉叶子"的文字,你就点一下"匹配溃疡病",点一下就完事,不需要写长篇大论的分析。
 南京农业产学研对接会现场农户病害上报聊天记录截图
他当时眼睛一下子就亮了,说那我这硬盘里攒了三年的东西,终于不用当废品卖了?
说实话,我太懂这种感觉了。之前我们总觉得,有价值的数据必须是结构化的,是从专业系统里导出来的,是带着精准标签的,那些散在微信群里的、带着口语化表达的、糊得不行的照片,都是没价值的垃圾。但群体智能技术最妙的地方,就是把这些垃圾捡起来,变成能解决实际问题的东西。
别把它当成人形标注机,核心是"没人是专家但凑一起就比专家准"
很多人对这东西有误解,觉得不就是找一堆人来标数据吗?那跟之前的众包标注有啥区别?
真不是。
我之前参与过一个城市内涝点排查的项目,之前市政部门要排查全城的易涝点,得开着工程车沿着主干道转,转整整半个月,还漏了好多小区门口的小巷子,一到下雨就淹,等老百姓打热线反映过来,路面积水已经把停在路边的车泡了半轮。
后来我们换了个思路,用群体智能技术搭了个特别简单的上报入口,住在各个小区的居民,只要碰到下雨积水,就拍个照,报个位置,连积水有多深都不用精准量,就写个"没过脚脖子""堵了井盖"就行。系统根本不需要等测绘专家来挨个核实这些上报点,就把同一个位置的不同人的判断交叉比对——比如同一个小区门口,有三个人分别在两次降雨里报了积水过脚踝,有两个人说上次下雨堵了排水口,系统就自动把这个点标记成高风险易涝点,根本不需要专人跑现场。
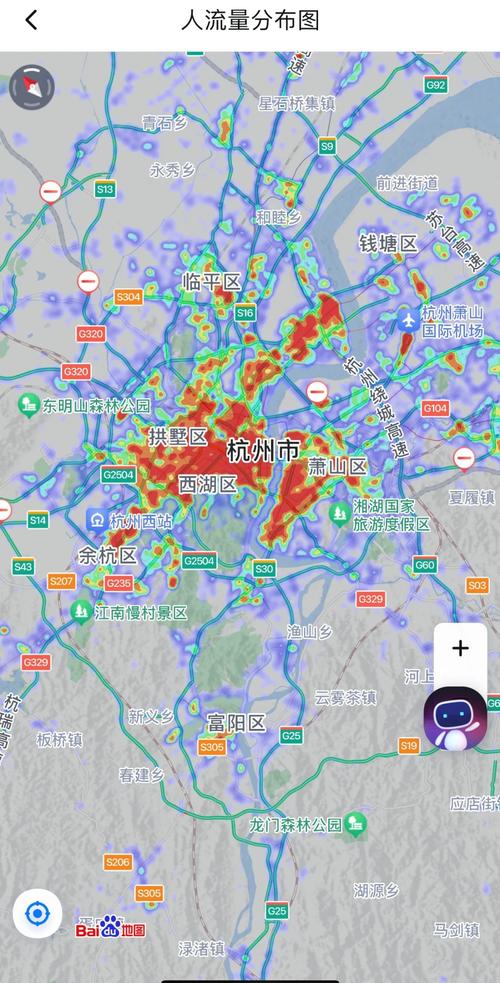 城市社区内涝点群众上报位置热力分布示意图
当时我们测这个系统的准确率,最后算出来,比之前市政团队跑了半个月排查出来的结果,多找出了40%的易涝点。更有意思的是,我们后来找了二十个在果园做收购的员工作为参与群体,没一个是正经植保专业毕业的,对着之前攒的那些病害照片做判断,最后整体的判断准确率,比我们找的那个有十年经验的驻点农艺师还高两个百分点。
我当时盯着测试报告愣了五分钟。
之前我们总迷信专家的判断,总觉得只有经过专业训练的人才能输出靠谱的结果,结果被一群连植物病理学教材都没翻过的一线收购员上了一课。群体智能技术最核心的逻辑,从来不是"找一群人来当廉价标注工",而是承认"没有任何一个个体能掌握全部的一线信息"——专家一年去果园的次数,可能还不如收购员一个月去的多;市政部门的工作人员不可能把每个小区的小巷子都走到,但是住在那里的居民,天天都在那走,他们看到的东西,比任何专家的调研都真实。
它不是万能的,这些坑踩一次就够你赔半年钱
 它不是万能的,这些坑踩一次就够你赔半年钱
我见过太多人把这东西吹得神乎其神,说这是下一代技术的核心,能解决所有问题。真的,听着就想笑。
这东西有非常明确的适用边界。它绝对不适合用来做需要绝对严谨、容不得半分偏差的判断——比如你不能让一群网友投票判断一个药物的副作用有多大,不能让一群普通用户判断一个桥梁的结构是不是安全,这种事一旦错了,是要出人命的。
之前有个做电商的团队找我聊,说他们想靠群体智能来判断用户评价的情感倾向,找了一堆兼职的人,两毛钱一条让人家标"好评""差评",结果最后攒了十万条数据,全是错的。为啥?因为他们连最基本的判断标准都没跟参与的人说清楚——你要的"好评"是指愿意复购,还是指夸物流快,还是指觉得产品性价比高?那些兼职的人根本不知道你要啥,标出来的东西全是凭感觉来的,最后白扔了二十多万,啥用没有。
还有个坑,就是很多人以为群体智能就是大家随便投票,少数服从多数。根本不是。真正能用的群体智能系统,一定有内置的校验机制——比如如果某个人对同一类问题的判断,错的概率比其他人高很多,系统就会自动降低他的判断权重,甚至把他的结果过滤掉。之前那个内涝点的项目,我们就碰到过一个人,连着报了五个根本不存在的积水点,系统比对了一下,他报的位置要么是没下雨的时间点,要么是他自己家车库门口,就自动把他的权重降到零,根本不会像网上的公开投票那样,找一堆水军刷票就能把结果带偏。
不过话说回来,这东西要是用对了地方,真的能把之前根本算不过来账的事给跑通。就像之前碰到的那个南京的果园老板,他之前算过,请专门的植保团队把他那三千亩果园的病害排查一遍,得花十几万,还得等半个月,赶上病害扩散,一年的收成就没了。用群体智能的方法,他就让手下二十个天天在园子里转的收购员,每天巡园的时候,花十分钟对着之前攒的那些聊天记录和照片做个小判断,三天就把所有的高风险病害点找出来了,最后花了不到两千块钱的茶水钱,就把事办了。
上周他给我发消息,说今年的溃疡病防控比去年早了半个月,算下来能多收二十多万的果子。他说之前总觉得技术是离自己很远的东西,是大学实验室里的论文,是互联网大厂的黑科技,没想到最后帮他省钱的,就是他自己攒了三年的那些乱糟糟的聊天记录,还有手下那二十个连智能手机都玩不太溜的收购员。
我当时盯着这条消息看了半天。
哪有什么神乎其神的黑科技啊。
不过是把之前被我们当成垃圾的、散在各个角落的普通人的小判断,认认真真攒到一起,罢了。