别再把隐私计算技术当玄学了,普通人也能搞懂的落地真相
上周跟某城商行的科技负责人喝咖啡,他吐槽说今年IT预算砍了三分之一,唯独隐私计算技术的采购款没砍,还涨了40%。
我当时愣了下。
毕竟前两年这东西还在行业里飘着,一堆厂商开个发布会,PPT上写满“数据可用不可见”“数字经济新基建”,底下坐的听众一半是来凑数的媒体,一半是来蹭人脉的销售,真正掏钱落地的没几个。
这才过了多久?
别再吹“数据不出域”的概念了,真正跑通的科研落地是什么样
之前大家对隐私计算的印象,基本停留在厂商的宣传册上。好像只要上了这个技术,所有数据都能锁在本地,谁也拿不走,还能随便跨域算东西。
真不是。
今年上半年清华、浙大联合信通院发的跨域医疗数据隐私计算测试报告,我翻了三遍。他们拉了北京、杭州、广州三家三甲医院的信息科一起做测试,目标是联合训练一个针对罕见肺动脉高压的风险预测模型。搁以前这事根本做不成——每家医院每年碰到的符合研究标准的病例也就三四十例,样本量小到连统计显著性都凑不出来,硬要做研究的话,要么是把患者数据脱敏了传到统一的科研平台,要么是各家医院自己算自己的,最后出来的模型误差大到根本没法用于临床。
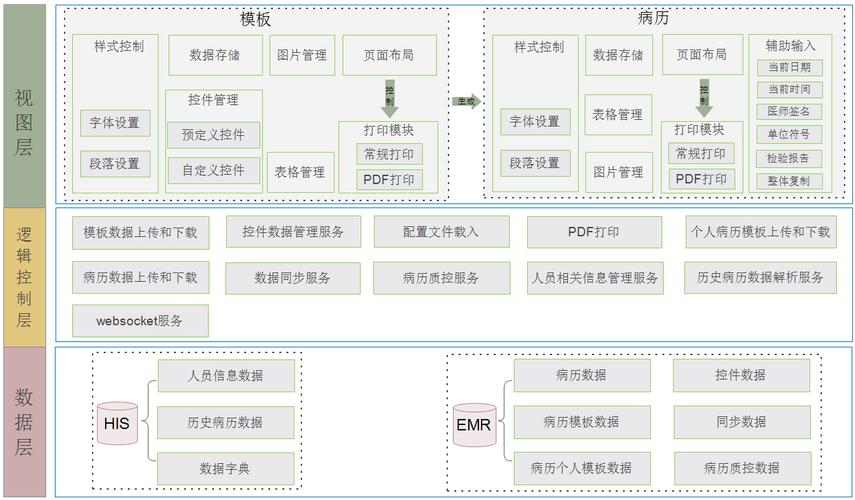 三家三甲医院跨域电子病历隐私计算联合建模流程示意图
这次的测试不一样。他们用的是优化后的纵向联邦学习框架,整个测试周期里,没有任何一条包含患者姓名、身份证号、就诊记录的原始字段离开过医院的本地机房。每轮训练的时候,各家医院只把自己算出来的、经过同态加密处理的模型梯度参数传给中立的协调节点,哪怕传输链路被截获,拿到的也只是一堆没有实际语义的加密乱码,根本反推不出来具体的患者信息。
最后跑出来的结果挺惊喜的。联合训练的模型准确率,比单家医院用自己的病例训出来的模型高了52%,而且因为加了差分隐私的噪声扰动,就算有人故意攻击梯度传输链路,反推出单条病历信息的概率不到百万分之一。
说真的,我去年去某省级三甲医院调研的时候,信息科主任还跟我倒苦水,说之前有厂商来推隐私计算,吹得天花乱坠,结果跑个100条样本的测试都要半小时,还经常断连,最后钱花了几十万,连个能用于科研的模型都没跑出来。
这次的测试成果能落地,核心原因根本不是什么“技术突破了天”,而是这帮做科研的人终于不盯着炫技了——他们把之前冗余的加密计算环节做了裁剪,把原来需要跨域传输的特征对齐步骤拆到了本地做,硬生生把整个训练过程的性能损耗压到了18%以内。搁三年前,这个损耗率少说也要60%。
大家都在踩的坑,其实都是没摸透技术的适用边界
我见过最离谱的隐私计算落地案例,是某连锁超市的采购部门。
他们要做的事特别简单:算一下不同门店的日用品销量关联,用来调整每个门店的备货结构。就这么个事,居然花了两百万上了一套企业级隐私计算平台。说白了就是把几个门店的本地销售表加了个密同步到总部,用原来的普通数据库同步功能,十分钟就能把所有数据拉完算完的事,非要套个隐私计算的壳。最后算出来的结果误差率比原来的老办法高了18%,系统维护费每年还要交20万。
你说这是技术的问题吗?根本不是。
信通院今年发的《隐私计算技术应用落地白皮书》里有个数据,目前国内真正能实现端到端性能损耗控制在20%以内的隐私计算落地项目,占比还不到总项目数的17%。剩下的那些项目,要么是为了凑政策补贴硬上的,要么是被销售忽悠了根本没搞清楚自己的业务需求。
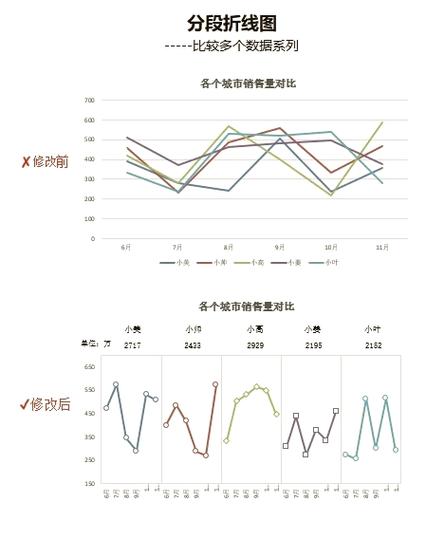 隐私计算项目性能损耗与业务场景适配度对比折线图
很多人对隐私计算的认知有个误区:觉得只要用了加密技术,不管什么场景都能往上套。
错得离谱。
比如你做金融领域的实时反欺诈,要求单条交易的特征计算必须在20毫秒以内出结果,你非要选全同态加密的技术路线——光解密就要花几百毫秒,用户点个贷款申请等半分钟,早就划走了。之前某股份行做反欺诈隐私计算项目,最开始选了全同态加密的方案,跑了三个月才发现,每笔交易的特征计算耗时是原来的3倍多,根本满足不了每秒上万笔交易的处理要求。
你算啊。
原来的中心化方案每秒能处理1.2万笔交易,换了全同态加密之后,每秒只能处理3000多笔,赶上促销的流量高峰,系统直接就崩了。最后他们换了基于秘密分享的轻量隐私计算框架,才把单条交易的处理耗时压到了15毫秒以内,整体性能损耗不到9%,完全能满足业务要求。
不过话说回来,也不能因为有这些坑就把隐私计算技术一棍子打死。它本质上就是个工具,跟你手里的Excel、收银系统没区别。用对了地方,能帮你解决原来解决不了的问题;用错了地方,就是花几百万买一堆在机房积灰的服务器。
接下来3年,这个技术的爆发点根本不是大家想的那样
之前行业里的主流判断是,隐私计算技术的主要客户就是银行、医院、政府这些有强数据合规需求的大B端。毕竟这些机构手里的数据多,合规要求严,有钱也有动力上系统。
但今年上半年我跑了一圈市场才发现,真正被忽略的大需求,其实在中小商家那边。
啥意思?比如本地开连锁烧烤店的老板,他想跟本地的生活服务平台做联合营销,把自己店里的会员用户拉出来,给那些最近在搜“烧烤”“夜宵”的用户发优惠券。搁以前的做法是什么?商家把自己的会员手机号导出来传给平台,平台帮着圈选人群发券。之前有好几家连锁餐饮品牌就因为这么干,把会员的手机号漏了,被监管罚了好几万。
我上次跟一个在杭州开了6家烧烤店的老板聊起这事,他拍大腿说早知道有更稳妥的办法,去年就不会因为传了3000个会员的手机号给平台,被监管罚了8万块。
真的。
浙大今年发在《计算机研究与发展》上的一篇论文,做了个面向中小商家的轻量隐私计算组件。这个组件根本不需要商家搭专门的机房,只要在原来的收银系统里插个几百KB的插件,就能实现商家和流量平台的联合用户画像计算——整个过程不需要传输任何原始的用户标识信息,两边只需要交换加密后的用户标签,就能精准圈出符合要求的目标人群,部署成本比原来的企业级方案低了90%以上。
还有个容易被忽略的安全问题,我得提一句。
今年信通院做的隐私计算安全测评,测了国内27款主流的隐私计算平台,发现有将近三分之一的平台,在模型梯度传输的过程中没有做足够的差分隐私噪声添加。学术圈早就有公开的论文证明,哪怕你传的是加密后的模型梯度,只要攻击者拿到足够多的梯度样本,完全可以反推出某一个训练样本里的具体特征——比如某张人脸的像素信息,某段病历里的用药记录,甚至是某个用户的消费习惯。
这不是小事。
之前有个做隐私计算的创业公司,因为没加差分隐私的噪声,被安全团队测出来能通过梯度反推出平台上的用户手机号,最后整个项目被叫停整改,损失了近千万的合同。
说实话,我刚接触隐私计算技术的时候,也觉得这是个离普通人特别远的、飘在天上的技术。好像只有顶尖的科研人员、大厂的技术团队才能碰,跟开烧烤店的老板、社区医院的医生根本没关系。
结果这两年跑了几十家落地的企业才发现,这东西根本不是什么用来凑项目预算的噱头。它就是个能帮你省麻烦的工具——合规的时候不用怕因为传数据被罚,做科研的时候不用因为样本不够凑不出结果,做营销的时候不用把自己的用户信息漏给合作方。
至于那些吹得天花乱坠的概念?听听就好。能实实在在解决问题的技术,才是真的有用。