别再吹大模型了:知识图谱构建才是企业落地的隐形护城河
上周帮一个做医疗合规的客户做项目复盘,对方CTO盯着屏幕骂了半小时——去年砸了两百万训练的垂域大模型,遇到跨科室的合规条款关联问题,还是会瞎编。
问题出在哪?
不是大模型不行,是它缺了能锚定事实的“知识骨架”。说白了,没有经过结构化校验的知识支撑,再大的参数规模,也架不住幻觉乱飘。
先拆穿个行业骗局:90%的“知识图谱”根本不是真的图谱
我见过太多团队把知识图谱构建想得太简单了——找个开源的图数据库,把业务系统里的文本数据导进去,给几个实体拉上线,就算大功告成。
最离谱的一个案例,某金融机构的风控知识图谱,把“企业注册时间”和“法人手机号归属地”硬连了条边,理由是“两者有统计相关性”。这种连法,除了在汇报PPT上看着花里胡哨,半毛钱业务价值都没有。
真正的知识图谱构建,核心从来不是存数据,是给每一条边加可追溯的语义约束。比如“企业注册时间”和“经营异常风险”之间的边,要明确标注关联的规则——注册时间不满3年且存在连续6个月零报税记录的企业,才会触发这条边的关联逻辑,而不是凭着统计相关性瞎连线。
很多人搞反了构建顺序:先攒几百万个节点再说,等数据导完了才发现,一半的边都是乱连的,查个关联关系还要人工翻半天数据校验,最后整个系统就成了个带连线的豪华Excel。
 企业风控知识图谱节点语义关联示意图
说真的,这种假图谱我见一次骂一次。你攒的数据再多,关联逻辑站不住脚,最后用的时候全是坑。
2024年了,别再靠人工敲节点了
前几年做知识图谱构建,流程说起来都让人头疼:先请领域专家花一两个月定义本体,再招十几个标注员对着文本逐句标实体、标关系,标完了还要做实体对齐,把不同来源的同名实体归并到一起。一套流程跑下来,半年时间都算快的,钱烧得哗哗的。
现在不一样了。
去年ACL上那篇用小参数开源模型做远程监督实体抽取的论文,我带着团队在三个垂直场景测了小半年,准确率比之前用的传统BERT模型高了37%,标注成本直接砍到原来的1/10。现在的知识图谱构建,已经从“人工定义关系”转向“大模型先做粗筛,专家只做边界校验”的模式。
之前传统的实体关系抽取,要靠专家先定义好几十类关系,比如“属于”、“位于”、“关联风险”,然后标注员对着文本一句句标,标出来的语料还经常有标注不一致的问题——两个标注员对着同一段文本,能把同一条关系标成完全不同的类型,最后模型训练出来的效果自然打折扣。现在用大模型做粗筛的话,只要把本体的定义prompt给模型,它能先把文本里的实体和关系全部抽出来,然后系统自动把置信度低于0.8的条目扔给专家审核,专家根本不用从头标,只要判断对错就行。我之前算过一笔账,传统流程下,每一千条实体关系的标注成本大概是120块,现在这套流程下,成本大概是8块,差了15倍。
上个月在制造业的客户那边测这套流程,之前3个工程师干3个月的本体对齐工作,现在1个工程师抽时间盯一周就搞定了。真的爽。
不过话说回来,别迷信那种吹得天花乱坠的“全自动化知识图谱构建系统”。之前有个创业团队找过来,说他们的系统能零人工干预搭全行业通用图谱,结果我拿一段医疗文本测了下,系统直接把“阿司匹林”和“新冠疫苗”连了个“可治疗”的边,给旁边坐的临床主任吓得差点把水杯砸了。
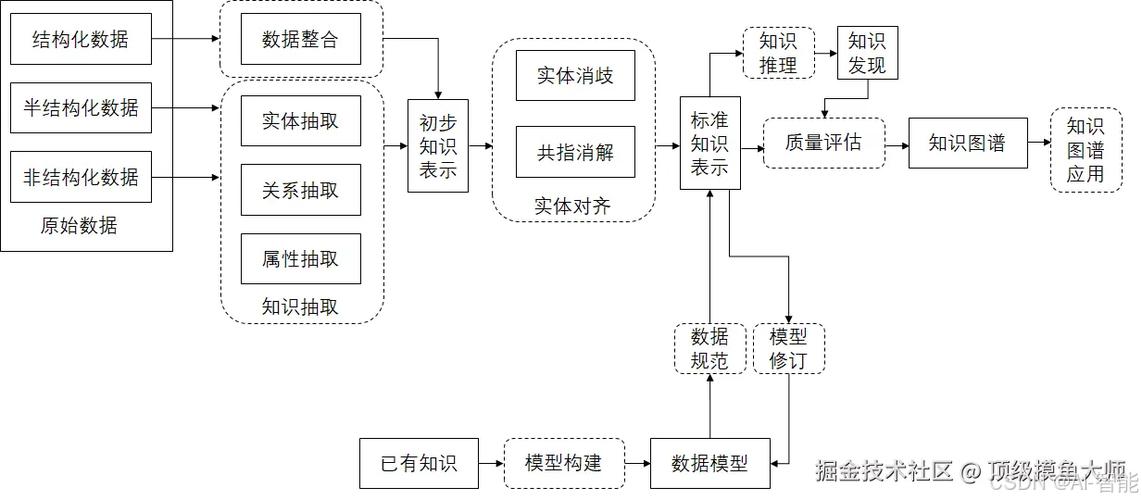 大模型辅助知识图谱构建流程对比图
工具是提效的,不是替代人的。尤其是涉及专业领域的语义校验,没有懂业务的专家把着关,最后做出来的东西迟早要出问题。
别追热点:能落地的知识图谱,从来都不是“大而全”的
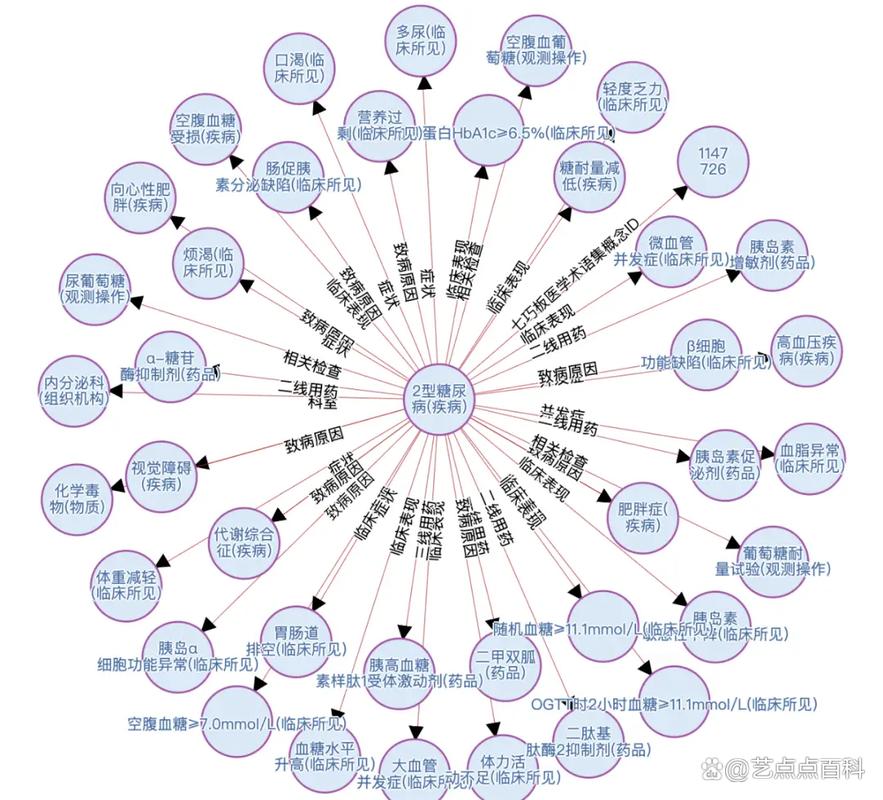 别追热点:能落地的知识图谱,从来都不是“大而全”的
我见过最离谱的一个消费领域客户,一开始拍板要做全行业的通用知识图谱——要把所有消费品、品牌、KOL、渠道、供应链节点全连进去,算下来要录入1200万个节点。结果做了一年,真要查个“这个品牌去年在抖音投的达人有没有带过竞品的货”,系统跑一次要40秒。
钱烧了几百万,业务部门根本没人用。
能落地的知识图谱构建,第一步永远是先锚定3个以内的核心业务问题。就拿之前那个医疗合规的客户来说,一开始他们也想做大而全的图谱,后来聊了三次,干脆把范围砍到只剩三个核心场景:跨科室条款关联校验、合规风险点预警、历史相似案例匹配。其他无关的实体,比如药品的分子式、医院的食堂位置这类信息,一概不录。最后整个图谱算下来才12万个节点,查一次跨科室的合规关联只要200毫秒,上个月帮客户拦了三起因为条款冲突导致的合规风险,算下来省的罚款都够把图谱的整体成本赚回来三回。
很多老板总觉得知识图谱越大越厉害,跟攒硬盘似的,容量越大越有面儿。
根本不是。
那些天天说“知识图谱没用,大模型能替代一切”的人,要么是自己做的是个连语义逻辑都没有的假图谱,要么是根本没真的在业务场景里跑过落地项目。OpenAI上个月更新的RAG技术报告里写得明明白白:如果在检索环节接入经过语义校验的知识图谱,大模型的事实幻觉率能从18%直接降到2.3%。这哪是替代关系,明明是互相成就。
上周跟那个医疗客户的CTO吃饭,他现在逢人就吹自己家的图谱系统——上次大模型遇到跨科室的合规问题,直接从图谱里拉关联条款,连半句瞎话都没有。
说白了,哪有什么技术高低。
能解决真问题的,就是好东西。