深度学习技术落地真相:那些论文里不会写的工业级细节
上周跟某新能源车企的算法中心负责人在路边摊吃烤串,他攥着半杯冰啤酒跟我吐槽,去年团队砸了200多万,跟着顶刊论文复刻了一套号称“零样本缺陷检测”的深度学习模型,拉到动力电池模组的产线上跑了3天,直接因为镜头起雾、传送带抖动带来的角度偏差,把30%的合格电池判成了有划痕的残次品,产线主管直接把他们的服务器电源拔了,说别耽误我们干活。
我当时听到这话差点把嘴里的烤茄子喷出来。就这?200万的模型,连车间夏天的潮气都扛不住?
说穿了,大部分人看到的深度学习技术,都是论文滤镜下的样子。
那些发表在NeurIPS、CVPR上的顶会论文,训练用的数据集是什么样的?是实验室里严格控好光照、固定好拍摄距离、甚至特意把背景擦得一尘不染的标准化样本。比如做电池表面缺陷检测的论文,训练集里的划痕,都是实验员用固定力度的美工刀刻意划出来的标准形状,连划痕的长度误差都控制在2毫米以内。
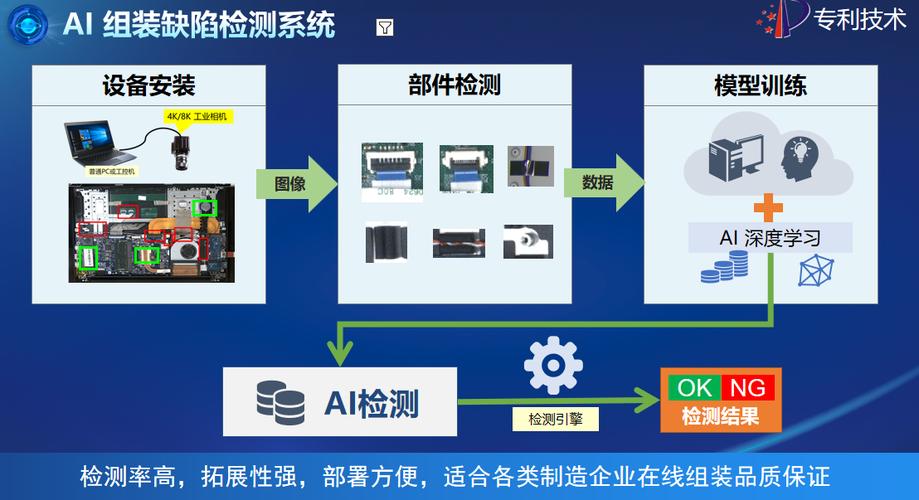 工业产线深度学习缺陷检测模型现场部署图
可真实的产线是什么样的?夏天车间温度冲到38度,摄像头镜头起一层薄雾;传送带因为长期磨损,运行的时候会带个15度左右的随机倾斜;原材料批次换了供应商,表面的反光度比原来的训练样本高了30%;甚至还有工人打扫卫生的时候不小心在镜头上蹭了点洗洁精残留。
这些变量,论文里根本不会写。
90%的公开论文里的深度学习模型,放到不受控的真实场景下,泛化性能会出现30%以上的折损。去年接触的一个做光伏背板检测的团队,一开始把原论文里的ResNet50模型直接拉到产线跑,准确率从论文里的98.7%直接掉到56%,折腾了3个月才发现,根本不是模型结构有问题,是产线的实际光照波动幅度,比论文数据集里的数值大了17倍。
谁在乎呢?产线不在乎这些论文里的漂亮数字。你模型准确率再高,只要漏判一个有安全隐患的电池,后续出了问题的损失,比你整个算法团队一年的工资都高。
别迷信“大参数堆料”,小模型反而更能打
现在一提到深度学习技术,很多人第一反应就是“堆参数”,好像模型参数越大,技术就越先进。
真不是。
去年跟一个做消费电子的朋友聊天,他们一开始想在新出的手机上套一个10亿参数的通用视觉大模型做人脸解锁,结果实测下来,手机端跑一次推理要1.2秒——用户把手机举到脸前面,等了快两秒才解锁,都以为手机卡死机了。后来他们的算法团队干脆把大模型扔了,从头训了一个只有120M参数的轻量化小模型,专门针对不同肤色、不同光照角度、甚至不同戴口罩状态下的人脸特征做了针对性训练,最后把推理速度压到了180毫秒,准确率还比原来的大模型高了2个百分点。
说实话,我见过太多团队为了凑论文指标,把模型参数堆得越高越好,根本不管实际跑起来要占多少内存,要耗多少算力。上次在某行业展会上,看到一个创业公司的展台,把一个70亿参数的大模型摆在边缘计算盒子上演示,我凑过去问他们这个盒子的显存是多少,他们支支吾吾半天说,演示的时候是用云端算力跑的,现场只是放个预录的画面。
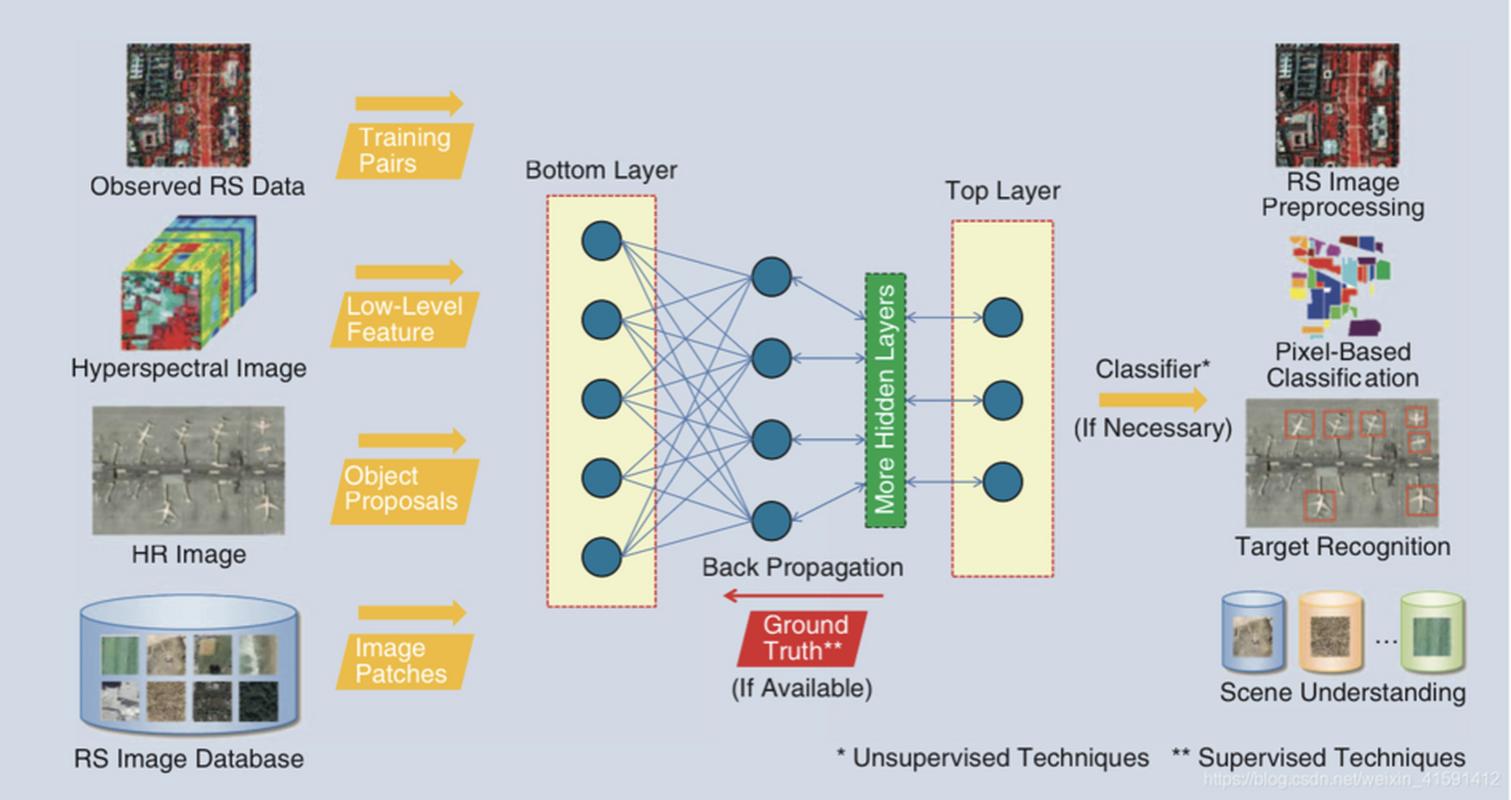 移动端轻量化深度学习人脸解锁模型结构示意图
这不是纯纯的忽悠吗?
在算力受限的边缘场景,参数量超过设备显存1/3的深度学习模型,本质上就是无法落地的空中楼阁。你想啊,工厂里的质检摄像头、汽车上的自动驾驶域控制器、用户手里的手机,这些设备的算力都是卡死的,根本不可能给你留足够的资源跑一个几百亿参数的大模型。之前有个做工业视觉的工程师跟我吐槽,最烦的就是甲方上来就说“我们要用上最先进的大模型”,你跟他说边缘设备的算力扛不住,他还觉得你技术不行,不肯下功夫。
我倒想问问,你连设备的算力上限都没摸清楚,上来就要堆参数,这是做产品还是搞行为艺术?
深度学习技术的真正护城河,从来不是算法本身
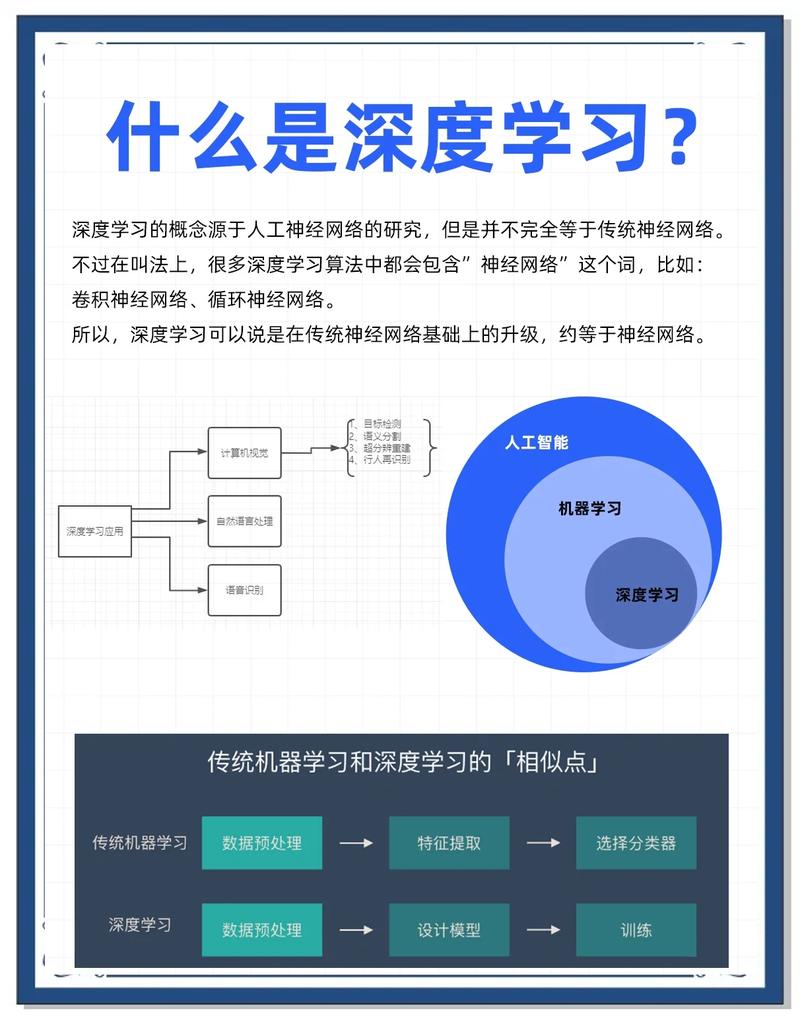 深度学习技术的真正护城河,从来不是算法本身
很多人觉得,深度学习的核心竞争力是模型结构,是Transformer,是CNN,是那些顶会论文里最新提出的网络架构。
错得离谱。
我接触过的做工业质检的头部团队,人家根本没天天泡在arXiv上追最新的论文改模型结构,而是花了整整2年时间,攒了12T的真实产线缺陷样本。这里面有不同批次原材料的色差,有不同班次工人操作的动作偏差,有不同季节车间温湿度变化带来的成像差异,甚至还有下雨天空气湿度高的时候,镜头上凝的小水珠的图像。
这些数据,是那些在实验室里用公开数据集刷榜的团队,花多少钱都买不到的。
你算笔账就知道了。别的团队花1年时间,改了8版模型结构,把公开数据集上的准确率从95%提到95.2%,人家只是把自己攒了2年的真实数据喂进一个最基础的ResNet18模型,准确率直接从82%跳到96%。这差距,是靠改模型结构能追回来的?
最近OpenAI的o1模型出来,大家都在吹它的推理能力有多强,能做多难的数学题,能写多复杂的代码,但很少有人提,他们为了训练这个模型,攒的人类高质量推理样本的规模,是之前GPT-4的7倍。
哦对,上次去某高校的实验室参观,看到几个博士生在那对着屏幕调模型,曲线画得漂亮得很,全是公开数据集上的准确率变化。我问他们有没有拿真实场景的数据测过,他们愣了半天,说等论文发了再说。
害。
真当深度学习技术是抄抄模型结构就能做出来的?那些在论文附录里用小字号标注的“数据集采集于无自然光干扰的恒温实验室”的备注,往往就是决定一个模型能不能从论文走到真实场景的最核心门槛,只是大部分读论文的人,根本不会把这行小字当回事。
你说现在的深度学习应用,到底缺的是更好的算法吗?根本不是。缺的是能真实反映场景问题的高质量数据,缺的是愿意蹲在产线上跟工人聊3个月,摸清楚所有实际变量的耐心,缺的是不迷信论文指标、不盲目堆参数的务实劲。
上次那个被产线主管拔了电源的算法负责人,后来带着团队在车间蹲了1个月,把所有影响成像的变量都列了出来,重新调整了训练集的样本分布,现在那个缺陷检测模型已经能稳定跑在产线上了。他说之前总觉得算法是万能的,现在才明白,深度学习技术从来不是什么魔法——你得真的扎到场景里去,它才能帮你解决问题。