破墙者:存算一体架构如何撕开冯诺依曼瓶颈
摩尔定律走到尽头的今天,芯片行业都在找新的出路。大多数方向都是在原有框架下缝缝补补,少数人选择直接掀桌子。
墙在哪里?旧架构的天生顽疾
1945年冯诺依曼提出的架构,统治了计算机行业快八十年。这套架构把存储和计算分开,设计简单,工程上容易实现,在很长一段时间里完美适配需求。
直到AI大模型起来。
当你跑一次7B参数的大模型推理,GPU要不停从显存里读参数、写结果,数据在存储和计算两个模块之间跑来跑去。存储的带宽增长速度,远远跟不上计算单元算力的增长速度,这就是所有人都在说的冯诺依曼瓶颈。
有实测数据显示,数据搬移的功耗是计算本身功耗的足足两个数量级。也就是说,你花一千瓦的电跑AI,九百多瓦都用来搬数据了,真正做计算的不到一百瓦。这太离谱了。
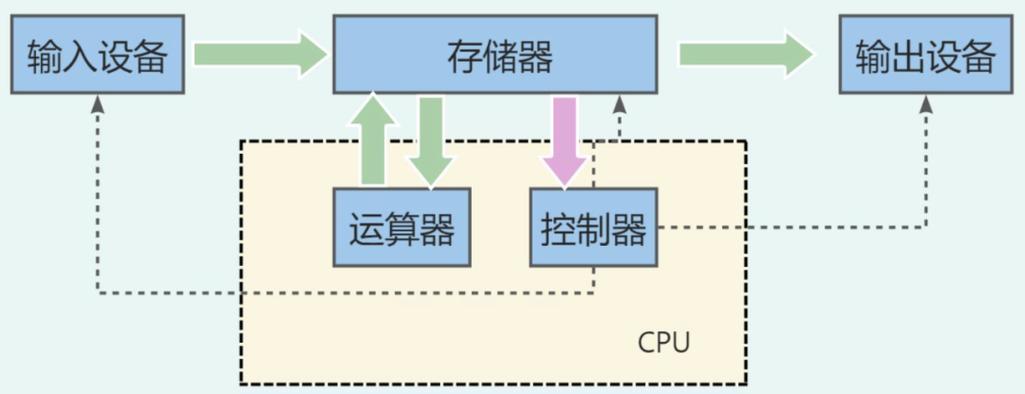 冯诺依曼架构存算分离功耗占比图
原来大家拼制程,拼主频,拼显存带宽,都是在绕着这个问题走。带宽提一倍,功耗涨几倍,成本更是涨得没边。高端GPU卖好几万一块,本质就是堆显存堆带宽,赚的就是辛苦钱。
这就是死结。不破墙,没出路。
不是堆一起,逻辑从根上变了
很多人听到这个概念,第一反应就是把存储颗粒和计算核心做在同一块封装里对吧?不对。那叫先进封装,不是一回事。
现在业内公认的路线分两条,近存计算和存内计算。近存计算还是原来的分离逻辑,只是把存储放得离计算单元更近,缩短传输距离,降低延迟和功耗。这个技术其实早就用在GPU的高带宽存储封装里了,确实缓解了带宽问题,但本质还是换汤不换药,墙还在,只是把通道拓宽了点。
真正革命性的是存内计算,核心逻辑就是直接在存储单元里面做计算。不用把数据搬出去,算完了直接存在原地。从根上拆掉了原来那堵墙。
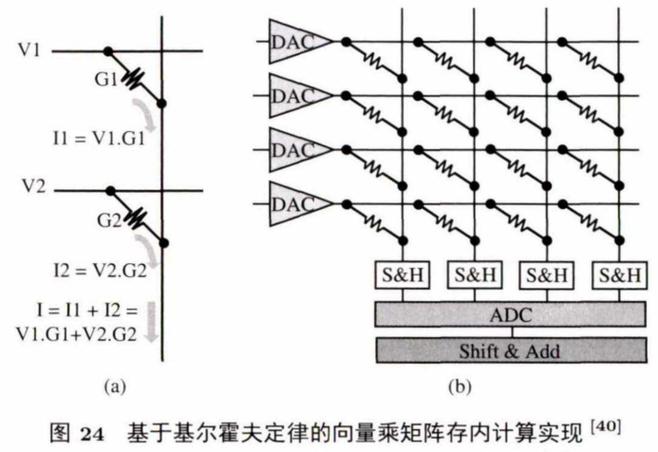 阻变RRAM存内计算单元结构剖面图
现在存内计算还分模拟和数字两条技术路线。模拟路线利用存储器件的物理特性直接做运算,比如用欧姆定律做乘法,基尔霍夫电流定律做加法,天生适合AI推理需要的矩阵乘加运算,面积小功耗低,缺点就是精度差,器件一致性差,容易有误差。数字路线更接近原来的设计习惯,精度高,好兼容,但是面积和功耗降不下来,优势不明显。
没有完美的路线。每条路都有自己的适用场景。
别吹神话,它能做的事有限
 别吹神话,它能做的事有限
说实话,现在这个概念被炒得太火了,什么“颠覆摩尔定律”“取代GPU”,听得人头晕。其实它的应用边界清晰得很,现在能落地的场景非常有限。
第一个绕不开的问题就是精度。模拟存内计算的精度一般也就做到8比特,好点能做到16比特,做端侧低精度AI推理没问题,做云端大规模模型训练?差得远。大模型训练需要32比特的浮点精度,至少也得16比特整数,现在没有哪个存算方案能稳定做到大规模的高精度运算。做出来的模型误差大到没法用,再好的功耗指标也没用。
第二个问题是生态。原来整个软件栈,从编译器到算子框架,都是给存算分离架构做的,全部重新做一遍?成本高得吓人,没有哪个公司能一口气吃下整个生态的转型。现在很多方案只能针对特定算子做优化,换个任务就得重新流片,通用性极差,根本没法做通用计算。
第三个问题是器件本身。现在做存内计算用的新兴存储,比如RRAM、相变存储器,良率一直上不去,做大容量芯片的时候,坏块率比传统的CMOS工艺高很多,一旦坏了怎么修复?现在还没有成熟的解决方案。一块芯片做出来,十分之一的单元是坏的,你怎么用?
不过话说回来,它也不是没用。现在端侧的AIoT设备,比如智能摄像头、可穿戴设备,需要低功耗的本地AI推理,对精度要求不高,这个场景存算方案简直是天生适配。现在已经有量产的产品出来了,功耗比传统GPU方案低一个数量级,体积也小得多。这才是它现在真实的价值。
至于取代GPU,颠覆整个计算行业?那还早得很。至少未来十年,云端的大规模计算还是存算分离的天下,它只是作为一个补充,在特定场景撕开一个口子,慢慢迭代。
技术革命从来不是一蹴而就的,今天的破墙者,可能还要走几十年的路,才能真正把墙拆掉。没人知道最后会不会成功,但总得有人试对吧?