数据不能动,模型怎么训?联邦学习技术告诉你答案
去年帮朋友做一个风控项目。碰到个离谱的要求。五家机构一起出钱出力,想要训个能识别欺诈用户的模型,但是五家谁都不肯出原始数据。
谁敢啊?现在《个人信息保护法》摆在这里,随便泄露共享用户数据,那是要吃官司蹲局子的事。以前我碰到这种需求,直接摆手说做不了。数据都凑不到一块,训个屁的模型。
那一次,就是我第一次真正碰联邦学习技术。说实话,当时我也觉得是炒概念,没想到做完项目,才品出点味道来。
为什么攥着数据还得求别人一起做模型?
其实这个问题,已经憋了行业快十年了。早年互联网跑马圈地,大家到处买数据爬数据,只要效果好,没人管合不合规。现在不行了,监管越来越严,用户隐私意识也上来了,随便动别人的数据,成本太高。
但是偏偏很多场景,你一家的数据根本不够用。比如银行做风控,你只能拿到自己行里用户的交易记录,很多欺诈用户在你这里没坏账,在别的行早就是黑名单了,你不联合,根本识别不出来。再比如医院做AI辅助诊断,单一家三甲医院一年的罕见病样本也就几十上百例,不够训模型,但是十家八家凑起来,样本量就够了,问题是谁敢把病历给别人?
这就是大家常说的数据孤岛。锁在各个机构柜子里,拿不出来,用不了,浪费了一堆价值。
联邦学习就是奔着这个问题来的。核心逻辑说穿了一点都不复杂:数据不动,模型动。原始数据永远存在你自己的服务器里,不用传给任何人,只把训练过程中模型更新的信息,加密之后传给其他参与方,最后大家一起训出一个能用的好模型。
 联邦学习数据不动模型动原理对比图
说人话,联邦学习到底怎么跑?
我给你举个做饭的例子,你一下子就懂了。现在有三个大厨,每个人都有一道独家的肉方子,谁都不肯把自己的方子给别人看,但是三个人想一起出一道更好的卤味,要结合三个人方子的优点,怎么办?
放在以前,只能让三个大厨把方子都交出来,给总厨揉到一起,才能出新品。这就是传统的集中式训练,数据必须集中。现在用联邦学习,不用交方子。
一开始,大家都用同一个基础配方。每个大厨拿自己的独家方子,试做一遍,试完之后记下自己改了啥:盐多放了5克,卤的时间多了10分钟,把这个改量记下来,加密之后发给总协调的人。协调的人把三个大厨的改量加起来,算出一个平均的改量,更新到基础配方上,再把新的基础配方发回给三个大厨。
来回重复十几轮,大家一起磨出来的配方,比任何一个大厨自己单独做的都好吃。从头到尾,没人看过别人的独家方子。完美。
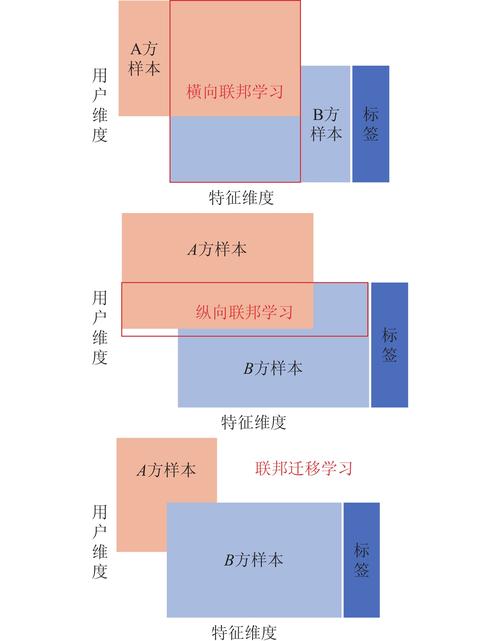
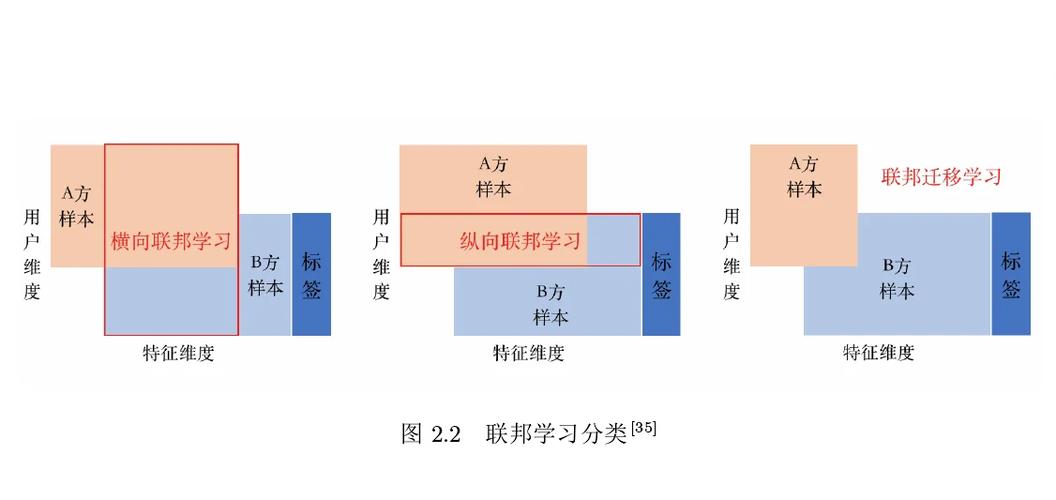
现在市面上常见的联邦学习,分两种场景。一种叫横向联邦,就是大家做的东西一样,样本不一样,比如不同省的银行,都是做风控,特征都是用户的交易、负债这些,但是用户群体不一样,联合起来就是扩大样本量。另一种叫纵向联邦,就是大家都有同一批用户的不同信息,比如银行有用户的交易数据,运营商有用户的行为数据,征信机构有用户的信贷记录,联合起来就是补全特征,训出来的模型更准。
 联邦学习横向纵向划分场景示意图
别被割韭菜,联邦学习不是万能银弹
 别被割韭菜,联邦学习不是万能银弹
这两年资本炒概念,很多公司把联邦学习吹上天,好像有了它,所有数据隐私问题都解决了,所有人都得赶紧上一套。我得给你泼盆冷水。
第一个误区,很多人说联邦学习天生绝对安全,原始数据不出去就不可能泄露。不对。之前已经有很多研究证明,如果不对梯度做加密处理,攻击者完全可以从模型更新的梯度信息里,反推出原始数据的内容。真要保证安全,联邦学习还得搭配差分隐私、同态加密这些隐私增强技术,才能把泄露的风险压到足够低。那成本一下子就上去了。
第二个坑,效果一定比单机构训的好?不一定。很多时候参与方的数据分布差别很大,你这边的用户都是高收入群体,我这边都是普通工薪阶层,分布差太远,训出来的模型,效果可能反而不如你自己用本地数据训的。还要做一堆分布对齐、正则化的工作,调参调到你头秃。
还有通信成本,你想啊,每一轮迭代都要在所有参与方之间传参数,十几个机构参与,节点网速跟不上的话,训一个模型要几周,够你喝好几壶茶了。
不过话说回来,这技术真的解决了很多之前解决不了的问题。现在金融行业做联合风控反欺诈,医疗行业做多中心临床AI研究,甚至互联网公司做跨平台推荐,都已经落地了。它不是用来取代原来的集中式训练的,就是给那些数据不能动,又必须联合建模的场景,多了一个可行的选项。
我之前碰过一个做糖尿病视网膜病变筛查的项目,五家三甲医院联合做,数据都不出院,最后训出来的模型,准确率比单家医院训的高了快十五个百分点。能早发现多少病人,这就是真真切切的价值。
技术从来都是解决问题的工具,不是用来吹泡泡的。联邦学习技术刚好卡在了隐私合规和数据价值的夹缝里,长出来的这么一棵树,至于能不能长成参天大树,还得走着瞧。但是至少,它给那些卡在进退两难里的项目,指了一条能走的路。