知识图谱构建:别被大厂神话忽悠,普通人也能看懂的落地逻辑
从零搭知识图谱,第一步90%的人都错了
你猜大部分人第一步做什么?爬数据。找开源数据集,爬虫跑维基百度百科,三天下来存了几百万条三元组,沾沾自喜觉得进度飞快。
错得离谱。
知识图谱构建的第一步,永远是定义业务边界和实体需求。你做这个图谱是用来干嘛?是做智能客服的问答匹配?还是电商的商品关联推荐?还是生物医药的靶点关系挖掘?需求不一样,整个构建逻辑天差地别。
举个例子,你做医美领域的知识图谱,目标是帮用户匹配符合需求的项目,那你需要的实体就是“项目名称”“适用肤质”“副作用”“价格区间”,不需要把整个医疗学科的解剖学知识都塞进来,对吧?
我之前碰过一个团队,做餐饮连锁的内部知识图谱,老板要求把所有和餐饮相关的行业标准、供应链资料、甚至农业养殖知识都加进去,结果光整理实体就花了三个月,图数据库跑个查询要十几秒,上线之后根本没人用。
纯粹是自找麻烦。
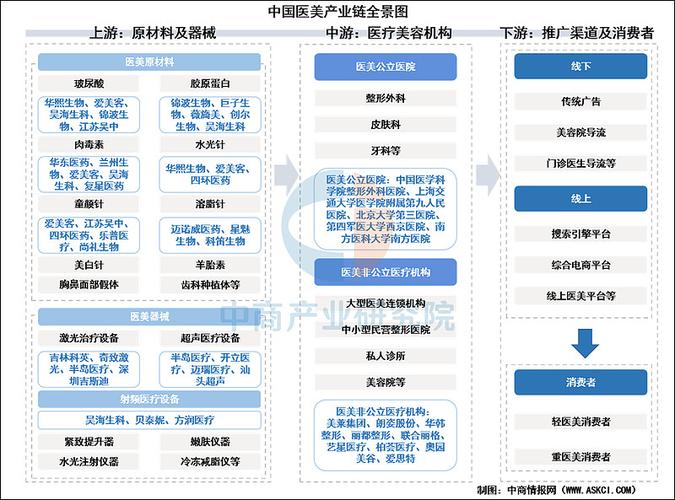 垂直医美领域知识图谱实体关系示例图
很多人追求大而全,觉得实体越多图谱越厉害,其实对大部分垂直场景来说,一千个精准对齐的实体,比十万个杂七杂八的无关实体有用一万倍。
你就想,用户搜“敏感肌能不能做光子嫩肤”,你得精准给出对应实体的属性,要是你的图谱里混进去十个叫“光子嫩肤”的其他实体,什么学术论文里的试验项目,仪器型号,出来的结果能对吗?
不对。
大模型时代,知识图谱构建的玩法早就变了
放在五年前,知识图谱构建就是人力堆出来的。实体抽取要人标,关系对齐要人校,属性整理也要人弄,一个十万实体的图谱做下来,光标注成本就得几十万,中小团队根本玩不起。
现在呢?大模型直接把这个门槛砸穿了。
说实话,现在做一个十万实体的垂直知识图谱,原来要三个月的活,现在一个熟手一周就能跑完流程。大模型帮你做实体抽取,帮你做初步关系对齐,甚至能帮你补全缺失的属性,效率翻了几十倍。
但话要说回来,坑也比以前多了。
最烦的就是大模型幻觉。你让大模型抽实体关系,它能给你瞎编,说“A品牌的XX防晒霜含有铅汞成分”,其实根本没有这回事,你要是直接把这种三元组存进去,那就是给产品埋雷。
还有就是实体对齐,大模型经常把不同的实体混在一起,比如把“玻色因”这个成分和“含玻色因的面霜”当成同一个实体,出来的关联全错。
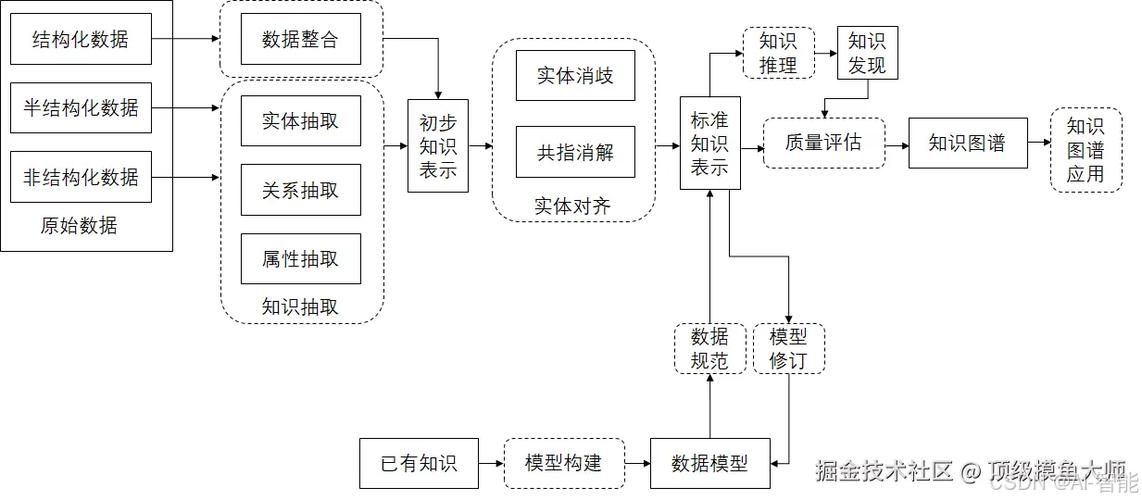 大模型辅助知识图谱构建流程示意图
那怎么解决这个问题?其实也不难,不用全人工校验,搞个“大模型跑粗,规则筛细,人工抽核”的三层流程就行。先用大模型把所有数据处理一遍,然后用规则把冲突的、明显错的内容筛出来,最后只抽10%的核心实体做人工校验,就能把错误率降到可用的范围,既省人力,又能保证质量。
不过话说回来,也别迷信大模型,一些专业度极高的领域,比如生物医药、法律,核心关系还是得靠领域专家把关,大模型只能做辅助,这个分寸得捏准。
落地避坑,三个血泪教训给你拎出来
 落地避坑,三个血泪教训给你拎出来
第一个坑,盲目追求大而全。刚才其实提过,还是得再说说,太多人死在这了。你一个做本地生活的创业公司,做什么全国通用的知识图谱?先把你所在城市的吃喝玩乐信息做精准,比什么都强。贪多嚼不烂,真的。
第二个坑,忽略实体对齐的细节。很多人把实体抽出来就完事了,同一个东西不同叫法,不管,直接存。比如“对乙酰氨基酚”“扑热息痛”“泰诺林”,明明是一个东西,分成三个实体,用户搜扑热息痛,出来只有一条信息,关联推荐全错,整个图谱就废了。这个活脏,累,不亮眼,但就是核心中的核心。
第三个坑,建完就扔,不做更新。知识图谱不是一锤子买卖。你做电商知识图谱,每个月都有新品上线,旧款下架,你一年不更新,图谱里全是下架商品,能好用吗?我见过不少项目,上线的时候吹得天花乱坠,半年之后没人维护,数据错得一塌糊涂,最后直接下线了,太可惜。
现在圈内都说知识图谱是大模型的外挂,能解决大模型胡说八道的问题,这话没错,但前提是你的知识图谱本身是对的,是准的,不然就是外挂带了错数据,比不用还糟。
很多小团队现在都在做垂直领域的知识图谱,其实机会真的很多,你把一个细分领域做深做透,比那些喊着做千亿级通用图谱的虚头巴脑的项目靠谱多了。
毕竟,能解决实际问题的技术,才是有用的技术。