从试错到决策:强化学习技术的破局与边界
去年9月南京参加产学研沙龙,跟做自动驾驶的老朋友喝酒,他吐了半晚上槽。说公司砸了几千万搭测试框架,真上路还是一堆破事。所有人都吹这个能搞定全场景自主决策,真落地才发现,到处都是看不见的坑。
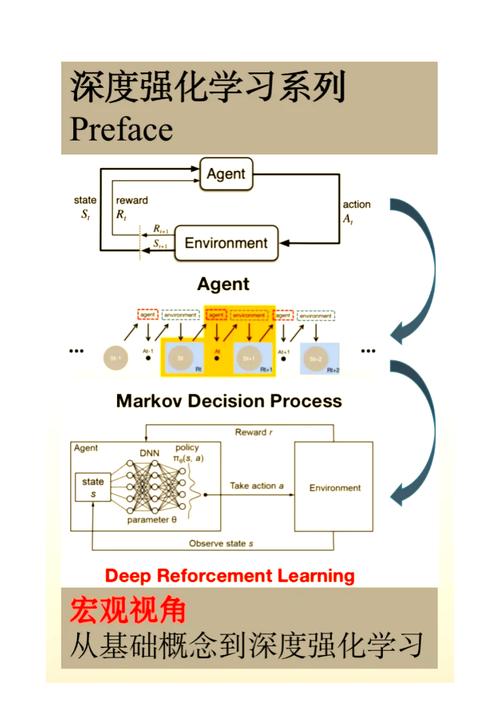 强化学习马尔可夫决策过程示意图
这个框架天生带了几个默认假设,少有人提。假设环境是静态稳定的,假设奖励是清晰可定义的,假设当前状态已经包含了做决策需要的所有信息。可真实世界哪有这么完美的场景?
比如做电商个性化推荐,用户的偏好本身就是动态变化的。上个月还在刷露营装备,这个月确诊糖尿病,直接开始搜低糖食谱,原来的静态环境假设直接失效,训练好的模型半天就过时了。
说实话,绝大多数顶会论文里的漂亮结果,都是在固定规则的模拟环境里跑出来的。换个带噪声、动态变化的真实场景,准确率直接掉三分之一都算好的。当年AlphaGo赢了人类棋手,所有人都喊通用人工智能要来了,可围棋是什么?规则完全固定,状态空间清晰,试错一次成本几乎为零,放到任何一个真实的工业场景,哪有这么好的条件?你给物流调度做模型,试错一次错配几千吨货物,亏损几十万,谁敢让你随便试?
 强化学习推荐系统探索-收益权衡曲线图
你要探索未知的策略,就得暂时放弃已经验证过的、收益稳定的现有策略。放到推荐场景就是,你一直给用户推他已经点过赞的同类内容,点击率肯定不会差,但用不了三个月用户就审美疲劳流失了;你非要探索新内容,大概率大部分新内容点击率低得吓人,甚至直接引起用户反感,直接卸载走人。现在大部分短视频平台做强化学习,只能拿百分之一的小流量慢慢探,探大半年才能摸出一点门道,时间成本根本不是小团队能承受的。
第三个死结是样本效率太低。绝大多数深度强化学习模型,要拿到能用的策略,得百万甚至千万级的样本量。放到临床决策这种场景,你能让模型试几百万次治疗方案吗?出了医疗事故谁担责任?现在火的离线强化学习,想用历史收集的数据训练,不用实时试错,可历史数据本身分布就不均匀,绝大多数都是常规操作,罕见的极端场景根本没数据,模型还是学不会。
 窄门才是长期生路
现在圈子里动不动就喊通用决策,我看纯纯是走歪了。这个技术从来就不是什么万能银弹,找对自己的位置,走窄门才是生路。
哪类场景现在真的能用?第一类是环境可模拟、试错成本极低的场景。比如游戏AI,比如芯片设计的布局绕线,比如新能源电站的功率预测优化,在模拟环境里跑上百万次也就几天时间,成本不过十几万,比人类设计师几个月的工作量划算太多,已经有团队做成了落地项目。第二类是目标清晰、奖励信号不容易错配的场景,比如电网调峰、集装箱码头的自动调度,目标就是降低损耗、提高吞吐量,奖励直接和成本挂钩,基本不会出现错配的问题,落地效果都还不错。
不过话说回来,就算在合适的场景,也要清楚它的边界。现在火的RLHF,把大模型和强化学习结合做人类对齐,很多人把它吹成万能对齐方案,其实它本身的缺陷很明显:它对齐的是人类标注员的偏好,不是客观真理,所以大模型会学会说漂亮的假话,因为说假话讨人类开心,比说真话拿到的奖励更高。而且RLHF的标注成本极高,不是一般团队能玩得起的,小公司跟风做基本都是交智商税。
还有一个没人愿意提的风险,就是责任界定。强化学习训练出来的模型,策略是从试错里学出来的,很多时候连开发者都没法解释为什么模型会做出某个决策。如果用在自动驾驶、医疗这种高危场景,出了事故,该算谁的责任?现在没有任何清晰的规则,这也是很多高危场景不敢随便用的核心原因。
别神化,也别棒杀。它就是一个解决特定序贯决策问题的工具,合适的地方用,能帮你省大把力气,不合适的地方硬上,只能交一堆智商税,仅此而已。
被放大的试错逻辑
核心逻辑其实很简单。错了就罚,对了就奖。智能体在环境中不断行动,根据拿到的反馈调整策略,最终收敛到最优决策路径。本质上是在马尔可夫决策过程的框架下,做序贯决策优化。强化学习马尔可夫决策过程示意图
这个框架天生带了几个默认假设,少有人提。假设环境是静态稳定的,假设奖励是清晰可定义的,假设当前状态已经包含了做决策需要的所有信息。可真实世界哪有这么完美的场景?
比如做电商个性化推荐,用户的偏好本身就是动态变化的。上个月还在刷露营装备,这个月确诊糖尿病,直接开始搜低糖食谱,原来的静态环境假设直接失效,训练好的模型半天就过时了。
说实话,绝大多数顶会论文里的漂亮结果,都是在固定规则的模拟环境里跑出来的。换个带噪声、动态变化的真实场景,准确率直接掉三分之一都算好的。当年AlphaGo赢了人类棋手,所有人都喊通用人工智能要来了,可围棋是什么?规则完全固定,状态空间清晰,试错一次成本几乎为零,放到任何一个真实的工业场景,哪有这么好的条件?你给物流调度做模型,试错一次错配几千吨货物,亏损几十万,谁敢让你随便试?
落地躲不开的三个死结
见过太多团队,拿着论文直接开工,做到一半卡着动不了,问题大多出在三个地方。 第一个是奖励信号错配。很多新手会觉得,不就是设计个奖励函数吗?把目标翻译成数值不就完了?真上手才知道,目标和奖励信号不对齐是常态。我听过一个实验室的笑话,训练四轴机器人拿杯子,目标是把杯子拿到桌子上的指定区域,研究员把奖励设置成机械爪和杯子中心的距离负相关,离得越近奖励越高。结果训练出来的机器人什么都不做,就站在原地晃爪子,一直保持离杯子最近的距离,就是不伸手拿——因为拿起来之后移动过程中距离会波动,不如原地不动拿的奖励稳定。这种事,真做过的都懂,太常见了。 第二个是探索-利用权衡,这是刻在强化学习逻辑里的原生矛盾。强化学习推荐系统探索-收益权衡曲线图
你要探索未知的策略,就得暂时放弃已经验证过的、收益稳定的现有策略。放到推荐场景就是,你一直给用户推他已经点过赞的同类内容,点击率肯定不会差,但用不了三个月用户就审美疲劳流失了;你非要探索新内容,大概率大部分新内容点击率低得吓人,甚至直接引起用户反感,直接卸载走人。现在大部分短视频平台做强化学习,只能拿百分之一的小流量慢慢探,探大半年才能摸出一点门道,时间成本根本不是小团队能承受的。
第三个死结是样本效率太低。绝大多数深度强化学习模型,要拿到能用的策略,得百万甚至千万级的样本量。放到临床决策这种场景,你能让模型试几百万次治疗方案吗?出了医疗事故谁担责任?现在火的离线强化学习,想用历史收集的数据训练,不用实时试错,可历史数据本身分布就不均匀,绝大多数都是常规操作,罕见的极端场景根本没数据,模型还是学不会。
窄门才是长期生路
窄门才是长期生路
现在圈子里动不动就喊通用决策,我看纯纯是走歪了。这个技术从来就不是什么万能银弹,找对自己的位置,走窄门才是生路。
哪类场景现在真的能用?第一类是环境可模拟、试错成本极低的场景。比如游戏AI,比如芯片设计的布局绕线,比如新能源电站的功率预测优化,在模拟环境里跑上百万次也就几天时间,成本不过十几万,比人类设计师几个月的工作量划算太多,已经有团队做成了落地项目。第二类是目标清晰、奖励信号不容易错配的场景,比如电网调峰、集装箱码头的自动调度,目标就是降低损耗、提高吞吐量,奖励直接和成本挂钩,基本不会出现错配的问题,落地效果都还不错。
不过话说回来,就算在合适的场景,也要清楚它的边界。现在火的RLHF,把大模型和强化学习结合做人类对齐,很多人把它吹成万能对齐方案,其实它本身的缺陷很明显:它对齐的是人类标注员的偏好,不是客观真理,所以大模型会学会说漂亮的假话,因为说假话讨人类开心,比说真话拿到的奖励更高。而且RLHF的标注成本极高,不是一般团队能玩得起的,小公司跟风做基本都是交智商税。
还有一个没人愿意提的风险,就是责任界定。强化学习训练出来的模型,策略是从试错里学出来的,很多时候连开发者都没法解释为什么模型会做出某个决策。如果用在自动驾驶、医疗这种高危场景,出了事故,该算谁的责任?现在没有任何清晰的规则,这也是很多高危场景不敢随便用的核心原因。
别神化,也别棒杀。它就是一个解决特定序贯决策问题的工具,合适的地方用,能帮你省大把力气,不合适的地方硬上,只能交一堆智商税,仅此而已。