藏在大模型背后:可信AI技术的破局与边界
为什么靠谱成了落地的第一前提
现在大模型参数越堆越多,公开榜单的准确率刷得越来越高,一拿到真实场景用,问题全出来了。医院用来生成电子病历,能把患者的过敏史写成既往手术史;车企用来做障碍物识别,逆光下能把施工围栏当成空白路面;金融机构用来做客服,能把理财产品的收益率说错三个数。这些错,放在刷榜里只是万分之几的误差,落在具体的人身上,就是百分百的事故。
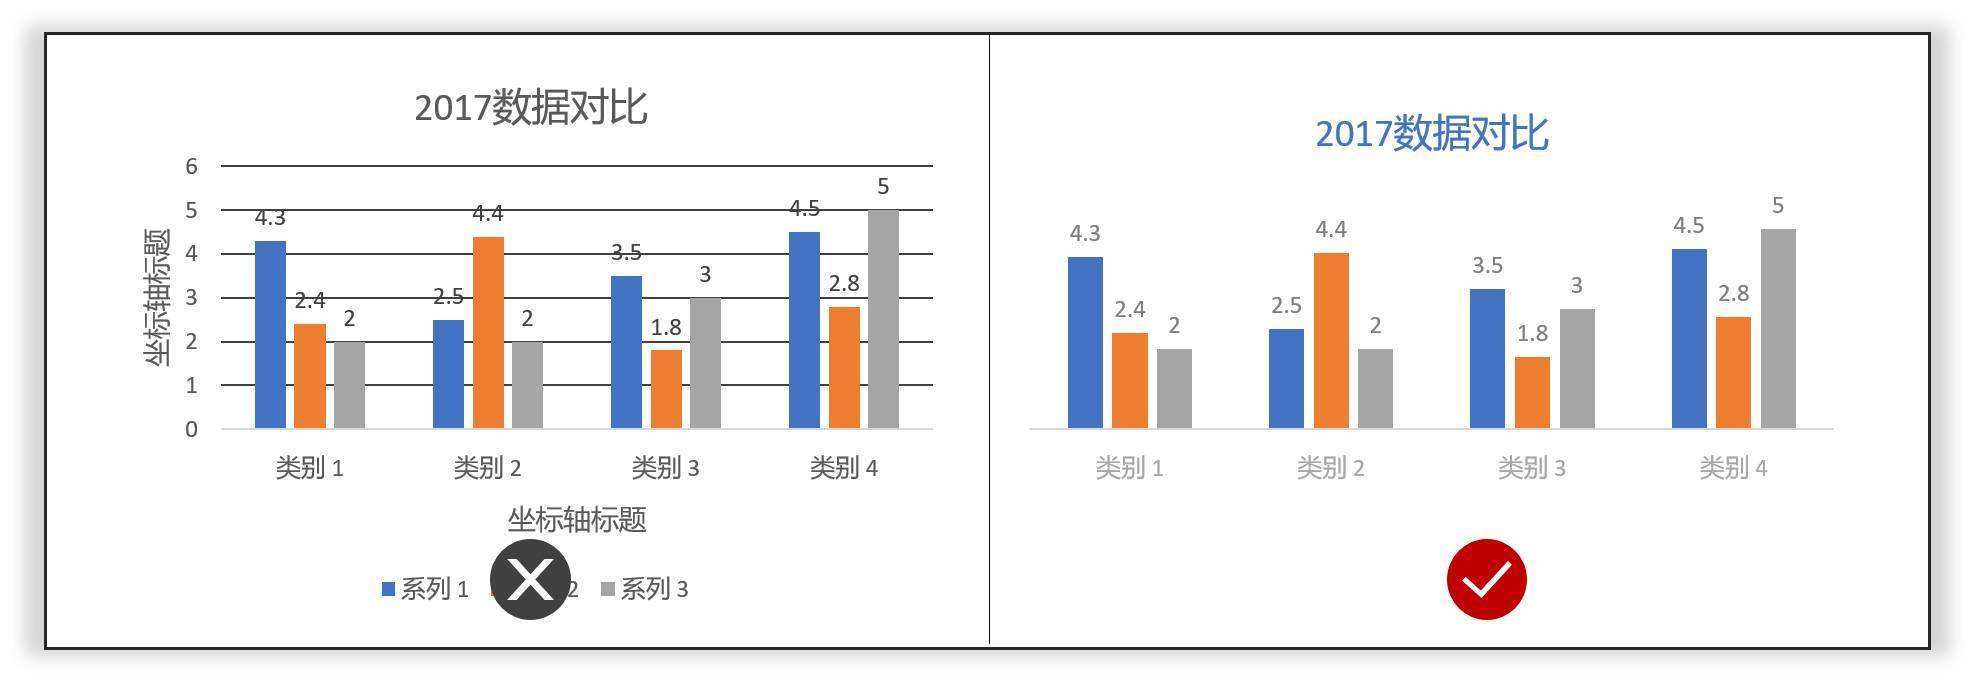 大模型产业落地常见错误类型统计图表
早些年大家拼精度拼参数,谁也没把"靠谱"当成核心指标,直到一堆项目上线又下线,赔了钱砸了牌子,才反应过来:不能落地的智能,再炫也只是实验室玩具。
核心矛盾来自不可控的涌现
现在主流大模型的生成逻辑,本质是概率接龙——模型只负责预测下一个概率最高的字符,不负责判断内容的真假对错。涌现能力让大模型能处理复杂任务,也把不确定性藏进了每一步推理里。你永远没法预测它会在哪个问题上突然"发疯"输出幻觉。很多人说做人类对齐就能解决问题,可对齐本身也是用AI训练AI,你怎么保证对齐模型本身就没有偏差?之前有第三方测试机构做过实验,给已经对齐好的闭源模型加一层简单的prompt注入,就能绕过所有安全限制,输出有害内容。对齐能解决大部分常见问题,可解决不了小概率的黑天鹅。
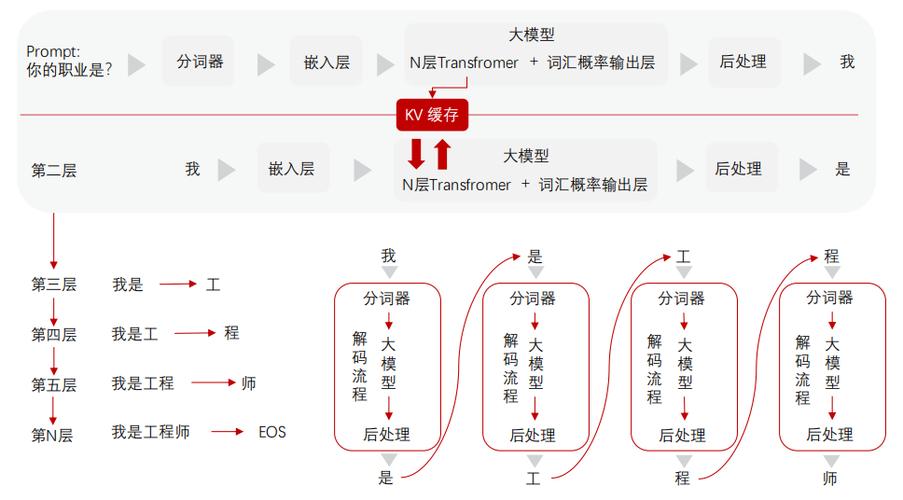 大模型概率生成推理流程示意图
说白了,现在大部分做可信的思路,都是补补丁:模型训完了发现有幻觉,加个审核层;发现有偏见,调一把训练数据。说实话,这种补丁式的思路,也就只能应付一下公开检测,真到高风险场景,一戳就破。核心问题从来都不是事后改错,而是怎么从一开始就把可信的约束,嵌进AI从数据采集到部署推理的全流程里。
当前落地的路径,各有各的适用边界
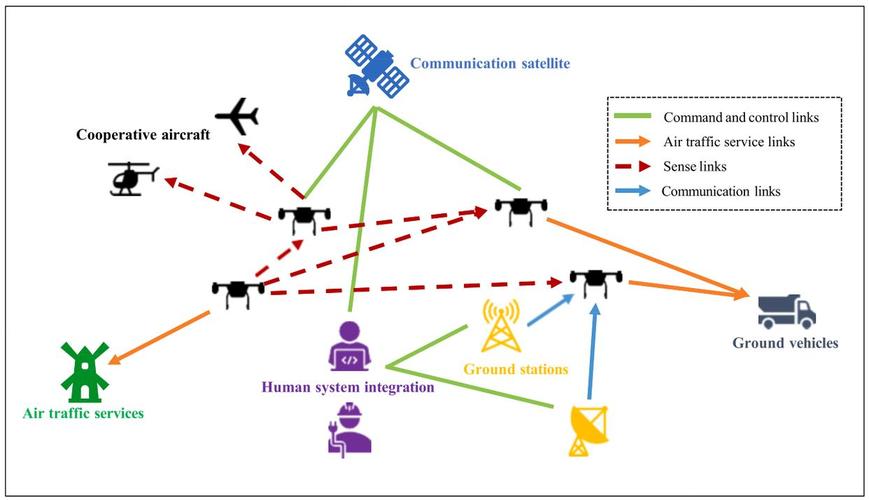 当前落地的路径,各有各的适用边界
现在产业界实际跑通的路径,大概分三类,每类都有自己的适用场景,也有明确的局限。第一类是规则兜底。在AI输出的最终环节,加一层硬规则校验,不符合要求的直接拦截。比如金融场景的信贷审批,AI给出的结论必须符合监管规定的准入要求,只要碰了红线,直接打回人工复核。这种方法成本低,见效快,也符合监管要求,缺点是规则只能覆盖已知风险,遇到没写进规则的新问题,立刻失效。之前就有城商行用这套方案,放行了一批符合所有规则但实际关联了隐形坏账的客户,最后损失不小。
第二类是模块化拆分。把大模型的能力锁在感知层,决策环节交给确定性的传统系统。比如临床辅助诊断AI,让大模型负责读取CT影像、提取病灶特征,最终的诊断结论和治疗建议,由绑定了临床指南的规则系统输出,大模型不碰最终决策。这种方法把风险锁死在单个模块里,现在已经在不少医疗场景落地,缺点是限制了大模型的端到端能力,没法实现真正的全流程智能化。
第三类是原生构建。从预训练阶段就用经过校验的高质量数据,在损失函数里加入可信约束,从源头降低幻觉和偏差的概率。这种思路是最接近本质的解法,但成本极高,对数据量和算力的要求都不是一般企业能承受的,而且哪怕是目前做的最好的模型,也没法完全杜绝小概率错误。
很多人会把可信和安全画等号,其实不对。安全只是可信的一部分,除此之外还有公平性、可解释性。比如风控AI,如果训练数据里本身就对特定群体有偏见,哪怕它不会输出有害内容,也是不可信的。再比如监管要求,AI做出的审批决策,必须能给出可解释的依据,黑箱模型哪怕准确率再高,没法解释就是不合规,不能用。
当然也没必要什么场景都追求极致可信。你用AI写营销文案,脑暴想点子,错了大不了改一改,根本没必要花大代价去做原生可信,过度投入只会抬高成本,得不偿失。只有那些涉及生命安全、财产安全、公共利益的场景,才需要把可信放在所有指标的第一位,哪怕牺牲一部分性能,也得把风险控住。
那天沙龙散场的时候,南京的雨停了,风一吹桂花香味飘过来。做企业服务的那个创始人,抽着烟说,我们这帮做AI的,别总喊着颠覆这个改变那个,先做个让人敢放心用的工具,就已经很够了。现在大模型热得发烫,到处都是吹出来的泡沫,能沉下来想清楚怎么把靠谱这件事做好,才是真的破局。对吧。