语音识别技术:听懂声音背后,被忽略的边界与难题
从声波到文字,没你想的那么简单
我们每天都在用,打字的时候点一下麦克风,就能出字,听起来稀松平常。可你有没有碰到过这种情况:奶茶店点单,背景音吵吵嚷嚷,你对着手机说“三分糖去冰”,它给你出“三份糖加冰”,害得你喝了一下午甜到齁的奶茶。这种尴尬,谁没碰到过?
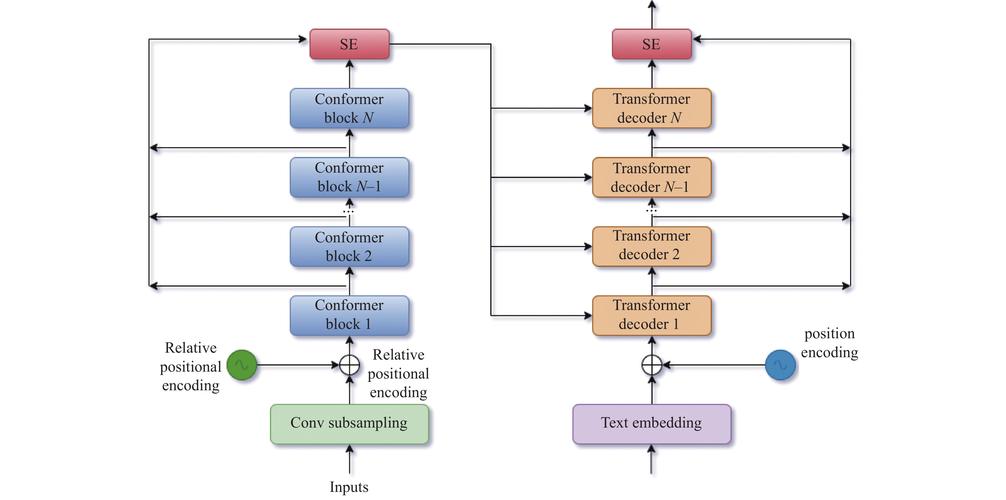 端到端语音识别模型结构示意图
早期技术用的是GMM-HMM框架,把声学模型和语言模型分开做,对计算资源要求低,但是碰到连读音变就直接拉胯。后来深度学习兴起,端到端模型把整个流程合在一起,准确率蹭蹭往上涨,最近几年大模型加入之后,连语义纠错都能自动完成,看起来好像真的已经“完美”了。
不对。哪怕是当前最成熟的方案,依然解决不了几个核心问题:低资源语言压根没有足够的标注数据,方言口音的变异度远超过模型见过的训练样本,极端嘈杂环境下,目标声音早就被背景噪音盖得几乎看不见,模型再强也做不到无中生有。我上个月在南京长江大桥上开车,打开车载导航说“导航到中山陵”,风噪太大,它连续识别错了四次,最后我还是停了车手动输的地址。真的挺窝火。
漂亮数据背后,藏着看不见的场景陷阱
现在只要是做相关产品的,都会拿准确率说事儿。张口就是百分之九十几的准确率,听起来特别厉害。可很少有人告诉你,这个数据是怎么测出来的。绝大多数公开的高准确率,都是实验室标准环境下的测试结果:拾音距离固定,发音标准清晰,背景噪音控制在极低水平。一旦换到真实场景,准确率掉十几个甚至二十几个点都是常事。
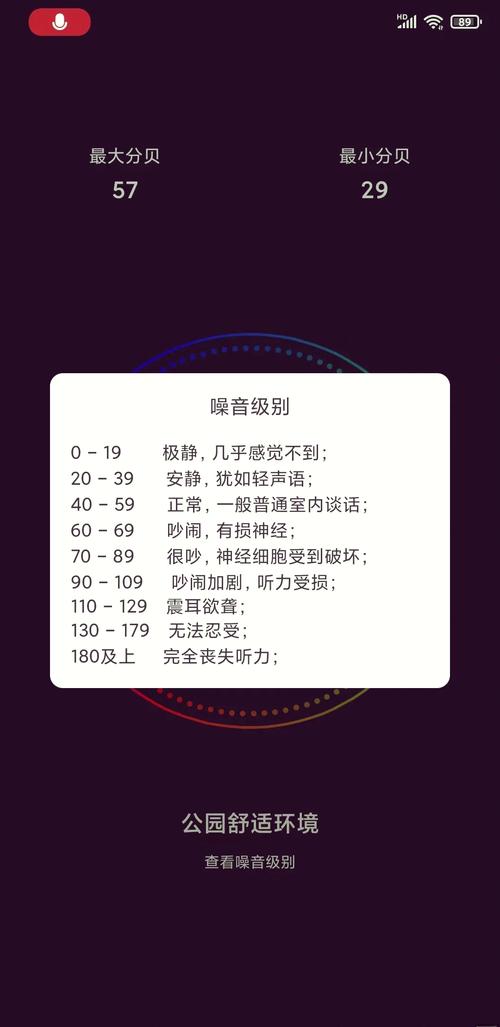 不同噪音环境语音识别准确率对比图
拿医疗场景的临床病历转写举例,医生说话语速快,夹杂大量专业术语,还有很多带口音的年轻规培医生,很多产品转写出来的结果,错误率能超过三成,医生改完一遍花的时间,比自己打字还久。还有司法领域的庭审转写,说话人重叠,方言插话,很多转写结果要人工核对大半天,原本说要提效,反而增负。
说实话,很多时候不是技术不行,是大家都故意把技术的能力吹得超出了它实际的边界。不过话说回来,用户的期待被拉得太高,一旦达不到预期,反而对技术更失望。
除了准确率,还有绕不开的风险问题。你每次开口说话,内容大多都会被上传到厂商的服务器,除了转写你的当前内容,很大概率会被留存下来训练模型。你聊过的病情,说过的银行卡号,甚至私下聊的商业机密,会不会被泄露?到现在也没有哪个厂商敢拍胸脯给用户打包票。还有误识别带来的责任问题,假如转写结果被用作法律证据,错了一个关键词,整个意思完全反转,这个后果谁来承担?这个问题到现在也没有明确的说法。
未来的方向,从来不是“万能通用”
 未来的方向,从来不是“万能通用”
现在很多行业从业者都在说,要做能听懂全人类所有语言所有口音的通用模型。这个方向对吗?不能说完全错,但绝对不是当下最该走的路。真实场景的需求太碎片化了,你给脱口秀演员做转写,要求能识别梗和谐音,你给户外作业的工人做对讲转写,要求能适应高强度的环境噪音,你给少数民族语言做转写,要求能在低标注数据下完成训练。指望一个大模型通吃所有场景,本质上还是懒,还是想赚快钱讲故事。
真正务实的路径,其实是垂直场景深耕。针对具体场景收集标注专属数据,做模型微调,把特定场景下的准确率做上去,比做一个什么都能做但什么都做不好的通用模型有用得多。比如针对四川方言做的本地生活服务转写模型,在餐馆、车站这类场景下的准确率,比通用模型高了快二十个点,用起来顺手很多。针对医疗领域预训练了上百万份专业病历的模型,对医学术语的识别率也远远超过通用模型。
还有很多人忽略的一点,就是端侧模型的优化。现在大多数识别服务都要把数据传到云端处理,不仅有隐私风险,还会有网络延迟,没信号的地方直接用不了。把模型压缩优化,放到本地设备运行,不需要联网就能完成转写,对很多对隐私要求高的场景,比如商务会议、私人诊疗咨询,反而更受欢迎。
技术发展到今天,确实给我们带来了太多方便,动动嘴就能打字,就能导航,就能控制家电,这些改变都是实实在在的。可我们也得清醒,它还没到无所不能的地步。那些藏在角落的具体问题,那些被资本吹胀的过高预期,才是接下来真正要沉下心解决的事儿。对吧。