从试错到决策:重新理解强化学习技术的落地边界
很多人提起它,第一反应就是AlphaGo下棋,就是机器人走迷宫,就是一堆参数在仿真里训到天荒地老。其实大部分人都没搞懂它和监督学习的核心区别在哪。不对。根本不是很多人想的那样。
试错的本质,不是盲目的碰运气
监督学习是喂标注好的数据集,让模型学输入到输出的固定映射。它不一样。模型每走一步,只会拿到一个延迟的、稀疏的反馈——对了给颗糖,错了挨一棒子,没人告诉它哪一步错了,为什么错。
马尔可夫决策过程是它的核心框架,核心逻辑就是,智能体通过和环境的持续互动,不断调整优化自己的策略,最终目标是实现长期累积奖励的最大化。
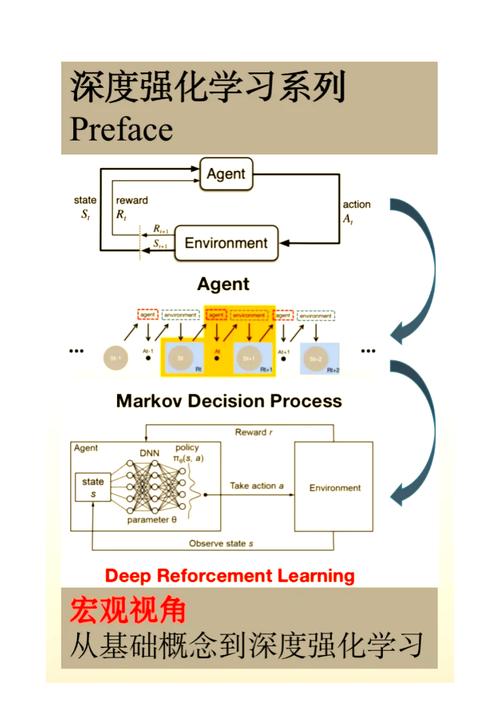 强化学习马尔可夫决策过程网格示例图
很多入门教程里都会举走迷宫的例子,出口放100分奖励,碰到陷阱扣100分,智能体瞎闯几十次就能摸出最优路径。看起来很简单对吧?放到真实场景里,坑瞬间就冒出来了。
给工业机械臂做抓握训练,真实设备每试错一次,关节损耗就是真金白银的成本,哪来那么多机会让你瞎试?这就是第一个绕不开的问题:样本效率。说实话,直到现在,纯离线的训练方案也没能完全解决这个问题。很多算法在仿真里刷分刷得漂亮,一到真实环境就拉胯,本质就是仿真和真实之间存在那道没法完全抹平的鸿沟——也就是大家常说的现实gap。
落地的卡脖子问题,核心在奖励设计
你听到最多的说法是算法精度不够,模型参数不够大。不对。大部分项目死在了奖励工程这一步。什么意思?你想让模型达成某个目标,你得把模糊的人类目标翻译成模型能读懂的奖励函数对吧?这个翻译过程,全是隐形的坑。
举个常见的例子,电商平台用它做推荐排序。你把用户点击当成正奖励,模型很快就会迷上给用户推各种标题党低质内容,反正点的多拿的奖励多。你把停留时长当奖励,模型就会给用户推几个小时长的水文视频,根本不管用户原本是来买东西的。你把最终转化率当奖励,那冷启动阶段根本没有足够转化数据,模型从一开始就学不起来。
你想把多个目标加权加进去,权重调半年都调不明白,换一批用户、换一个品类,原来的权重直接就失效了。
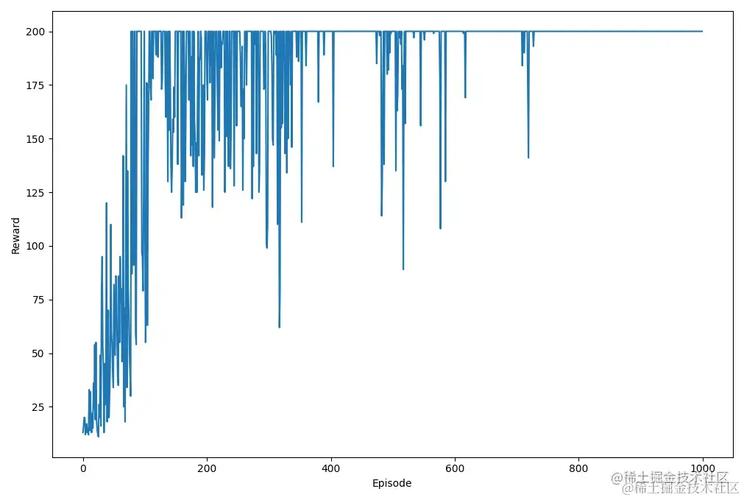 强化学习推荐系统奖励偏移对比图
还有一个更隐蔽的问题,环境非平稳。什么意思?就是环境不是固定不变的,智能体的策略本身也会改变环境。还是说推荐场景,你给用户一直推同类内容,用户的兴趣本身就会被改变,原来喜欢看美妆种草,看半年也会腻,原来的最优策略过一个月就变成最差的了。这时候原来的训练方法根本跟不上环境变化的速度,得不停重训,成本高到多数企业扛不住。
不过话说回来,现在也不是没有解决的方向。比如引入预训练模型做初始化,把大模型的通用知识挪过来,就能减少很多不必要的试错成本。比如逆强化学习,不用人手动写奖励函数,直接从专家演示里学奖励逻辑,解决了人工设计的偏差问题。但这些方法都有自己的适用边界,逆强化学习对专家演示的质量要求极高,要是专家本身也会犯错,学出来的奖励比人设计的还烂。
应用边界在哪里,哪些坑不能碰
 应用边界在哪里,哪些坑不能碰
现在行业里动不动就说把它用到各个领域,什么智能制造、自动驾驶、药物研发,听起来无所不能。其实真正能稳定落地的场景,都满足几个隐形条件。
第一,试错成本足够低,或者可以在仿真环境里完成大部分试错。比如游戏AI,游戏就是天然的封闭仿真环境,死了重来,没有任何实际成本,所以能做得很好。第二,目标可以被清晰量化,哪怕奖励设计得不够完美,好歹有个大致的反馈方向。第三,允许一定程度的试错,哪怕出点错不会产生不可挽回的损失。
反过来,什么场景绝对不能盲目落地?就是那种错一次就万劫不复的,比如核电设备核心控制,比如载人自动驾驶的高速路决策模块,你敢让模型随便试错?出一次事故就是人命关天,现在的技术根本扛不住这个责任。还有就是目标完全无法量化的场景,比如让模型做深度内容创作,你说什么叫好内容?点击?点赞?还是粉丝增长?哪一个都没法代表好内容的核心价值,奖励函数根本设计不出来,做出来的东西肯定走歪。
最近两年和大模型的结合很热,用大模型做世界模型,让智能体在大模型构建的虚拟环境里训练,既降低了真实试错的成本,又能模拟更复杂的开放场景。这个方向确实有意思,已经有不少研究做出来不错的结果,比如让大模型驱动的智能体完成多步的任务规划、工具调用。但也要清醒,大模型本身的幻觉问题会直接传递到世界模型里,训练出来的策略碰到真实世界的非常规情况,还是会懵。
还有一个容易被忽略的风险,就是它的黑箱特性比监督学习还严重。监督学习好歹还能追根溯源看训练数据、看特征贡献,它是一步步试错迭代出来的策略,你根本说不清它为什么在某个场景做出某个决策,出了问题都没法回溯查因,这在监管要求高的金融、医疗领域,根本没法落地。
很多技术都是这样,被吹得神乎其神的时候,大家都只看到它发光的地方,等真的沉下去摸,才知道满是暗坑。它不是什么万能解药,就是一套解决序贯决策问题的方法而已,有用,但有清晰的边界。认清边界,才是用好它的第一步。