知识图谱构建:从教科书到落地的踩坑指南
别被教科书骗了,真实项目里知识图谱构建根本不是按流程走
很多刚入门的朋友翻完几篇综述,跑通了某个开源数据集的demo,就觉得自己懂知识图谱构建了。说实话,等你真接一个企业项目试试,不出三天就懵。
教科书上写得清清楚楚,按步骤来:数据获取→实体抽取→关系抽取→知识融合→质量校验→存储应用,一步一个脚印,看起来工整得像工厂流水线。
真实情况呢?你做着做着发现甲方加了新的需求,要改schema,得,前面所有的标注抽取全得重来一遍。
我前年帮一家零售企业做商品知识图谱,甲方一开始说只需要做品类和品牌关系,做到一半说要加供应商、仓储、售后配件的关联,整个框架推到重写,半个多月的活白干了。别提多难受了!
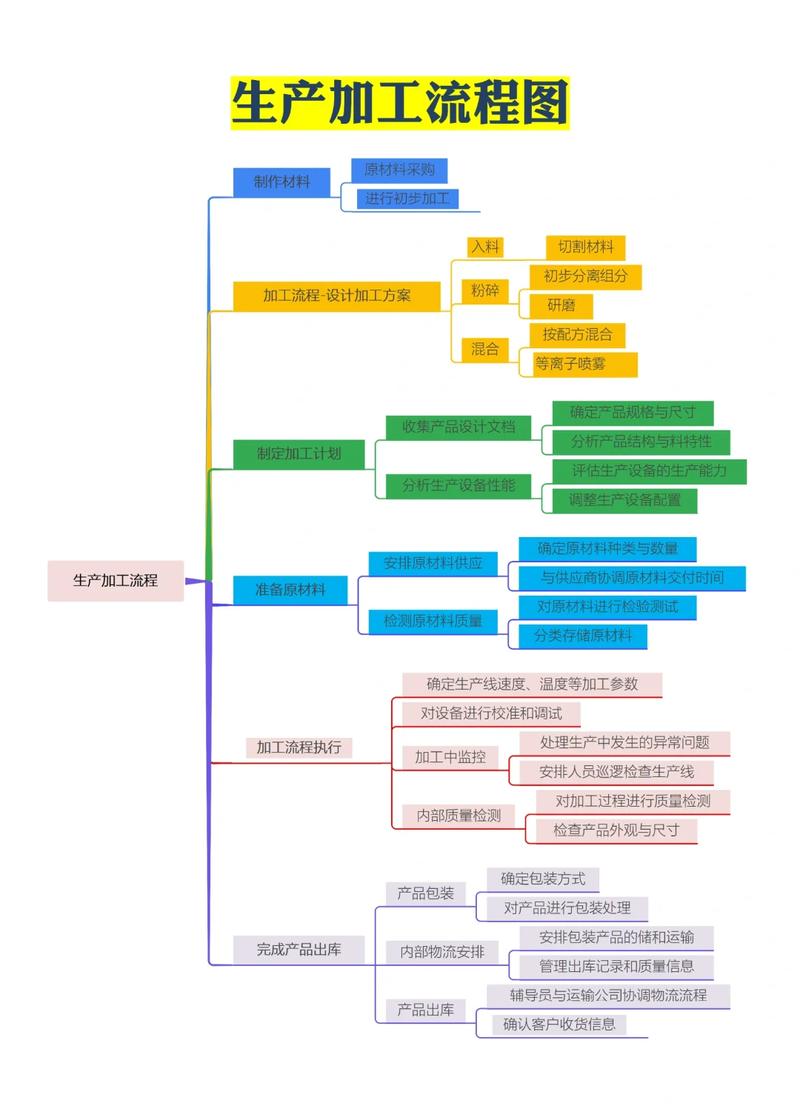 工业级知识图谱构建全流程示意图
说白了,知识图谱构建从来不是线性工程,是反复迭代的脏活累活。你别一开始就想着搞个大而全的全领域图谱,能把核心业务那几十类关系理清楚,就已经赢过八成项目了。
最容易翻车的三个环节,我踩过的坑都给你列出来
做了快八年知识图谱相关的项目,我总结出来,翻车基本都翻在三个地方,全是细节,全容易忽略。
第一个坑,schema 设计贪大求全。很多人觉得知识图谱嘛,不就是把所有东西都连起来吗?上来就定义了上百个实体类型,几百种关系,光写schema定义就写了半个月,结果到落地的时候,一半的实体根本找不到对应的数据,剩下的一半标注起来要了老命,最后项目烂尾。
我的经验是,先从核心业务痛点倒推,你做这个图谱是为了做搜索?还是做推荐?还是做问答?先把满足这个需求最小的schema做出来,跑通了再慢慢加,对吧?
第二个坑,实体对齐全靠算法,忽略规则校验。这个是重灾区,很多算法工程师觉得现在大模型抽取实体准确率都九十多了,还搞什么人工规则?结果出来一堆笑话:“苹果”既是水果品牌又是水果,全连一块了;“北大”一会儿是北京大学,一会儿是北大青鸟,错得一塌糊涂。
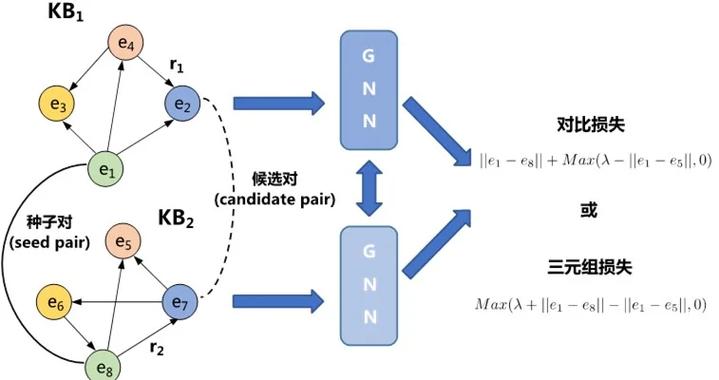 知识图谱实体对齐错误案例对比图
别不信,哪怕是大厂做的知识图谱,你去搜搜,照样有这种错链的问题。异名同实体、同名异实体,这两个问题,算法能解决八成,剩下两成必须靠业务规则加人工校验,省不了这个功夫。
第三个坑,做完就扔,不考虑迭代更新。很多项目交付的时候图谱看起来很漂亮,半年过去,企业业务变了,新产品上线了,旧的实体淘汰了,图谱还是老样子,根本用不了,最后被扔在服务器角落吃灰。
知识图谱本来就是活的,构建的时候就要留好更新接口,设计好自动更新的流程,不然就是一次性产物,白花钱。
大模型时代,知识图谱构建的玩法彻底变了
 大模型时代,知识图谱构建的玩法彻底变了
前几年做知识图谱构建,最费钱的是什么?标注。一个稍微大一点的项目,标注团队十几个人做几个月,光标注费就几十万,中小根本玩不起。
现在呢?大模型辅助知识图谱构建,真的香。原来要三个月的标注工作,现在让大模型先根据prompt做一轮自动标注,人工只需要修正错误,效率至少提三倍,成本直接砍半都不止。
不过话说回来,也别把大模型吹得太神。大模型会幻觉啊,它会给你瞎编不存在的关系,错把A公司的创始人安到B公司头上,你要是直接用,出来的图谱错漏百出,根本没法用。
现在行业里比较成熟的玩法是,大模型做粗加工,传统规则和人工做精加工,两者结合。既省了钱,又控住了质量。
还有个变化,原来知识图谱构建都是大厂搞来做搜索、做推荐,现在很多中小制造、零售企业都开始做自己的业务知识图谱,成本降下来了,大家都用得起了。比如做制造业的,做一个供应链知识图谱,把上下游供应商、零部件、产能全连起来,找异常的时候点一下就全清楚了,比原来翻excel找效率高太多了。
很多人说,大模型出来,知识图谱就没用了。不对啊,大模型的幻觉正好需要知识图谱做校正,知识图谱构建出来的结构化知识,给大模型做检索增强,效果提升不是一点半点。两者是互补的,不是谁取代谁。
现在入行做知识图谱构建,不需要你天天盯着重做模型,开源模型够好用了。你要练的能力,是怎么理清楚业务需求,怎么设计合适的schema,怎么把大模型和传统流程结合起来,做出真正能用的东西。
说白了,知识图谱构建,拼的从来不是谁的算法更先进,是谁更懂细节,更懂业务,肯蹲下来踩坑。偷不了懒的。