从被动抢修到主动预判:资产性能管理的破局路径
上个月在南京江北的工业园区转了三天,看了三家重资产工厂的运维现场。触目惊心。一个年营收几十亿的化工厂,核心压缩机的轴承换了三批,每次出问题都是停线抢修,少则百万多则上千万的损失,愣是没摸到规律。
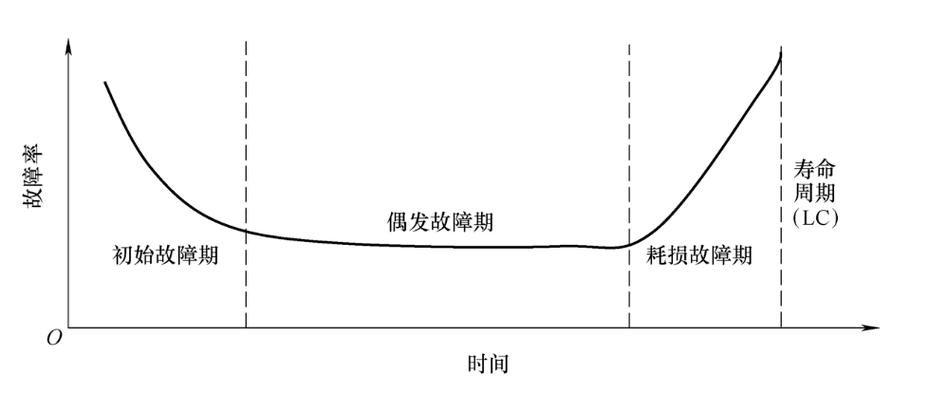 工业旋转轴承失效概率浴盆曲线示意图
行业内公认的设备失效规律就是浴盆曲线,三个阶段:早期投产的磨合失效,中期稳定的随机失效,后期老化的损耗失效。绝大多数企业的运维,都只卡在最后一个阶段救火——等设备出了问题再修,从来不会在前两个阶段收集数据,捕捉异常信号。
刚才提到的那家化工厂,其实十年前就装了振动监测,但是数据都存在本地硬盘,半年才导一次做报表,从来没人实时分析。海量的异常信号就躺在硬盘里睡大觉,等到轴承抱死停线,才后悔没早发现不对。
说实话,国内超七成重资产企业,现在还停留在这个阶段。要理清一个基本前提:它不是万能的,有清晰的应用边界。你办公室的打印复印一体机,坏了换个硒鼓也就几百块,犯不着花几万块装传感器做监测,只有那些停机影响生产、单位时间损失高、维修成本大的核心生产资产,才值得投入资源落地。
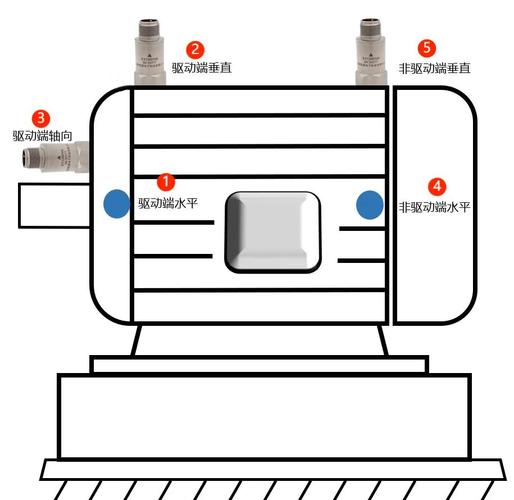 工业电机振动传感器错误安装位置对比图
这里藏着一个很多项目都踩的关键坑:多数项目是IT或者信息化部门牵头,一线运维老师傅的话语权太弱。设计图上标的位置不对,老师傅指出来要改,乙方说按图施工不能动,最后钱花了,东西没用。
正确的实现路径,得反过来:先拉着一线运维梳理核心部件的失效模式,搞清楚这个部件常见的失效是啥,哪种参数能提前反映异常,再确定测点位置,最后才是数据采集和建模。顺序错了,满盘皆输。
还有一个容易被忽略的风险,数据标注错配。刚出校门的算法工程师没见过真实的设备失效,把正常的负载波动标成异常,把早期的异常信号标成正常,模型的准确率从根上就歪了。
不过话说回来,也不是说只有头部大企业能玩,中小企业不需要望而却步。找核心的三五台设备,每个设备装两三个关键测点,几百块一个传感器,先跑半年验证效果,行了再铺开,远比一口吃个胖子稳妥。
 落地的核心:不是无人运维,是人网共生
现在到处都在吹无人值守、全自动运维,说AI要取代运维工人。我就问一句,你敢让AI直接下达停核心生产线的指令吗?谁敢?
去年在南京的一次行业沙龙上,听过一个省属钢厂的运维总监分享,他们的AI模型发出了二级预警,提示主轧机的齿轮箱异常,需要立即停机检修。结果跟着师傅去现场,师傅拿听声棒一搭,摸了摸箱体温度,说没事,当前轧制的坯料厚,负载大,正常波动,再跑半个月没问题。结果半个月后停线检修,打开齿轮箱啥事都没有,模型确实误报了。
为什么?AI模型学的是历史数据,现场的原材料、环境温度、生产负载每时每刻都在变,模型跟不上实时变化的场景,误报漏报在所难免。真正能落地的项目,都遵循一个基本逻辑:AI出预警,人做最终决策。
这里还有一个长期风险,很多企业上了系统之后,就开始淡化人工运维的作用,觉得有AI盯着就行了,结果经验丰富的老师傅退休之后,年轻人只会看系统弹窗,系统不报警就从来不去现场摸,很多早期的异常根本发现不了,最后憋出大故障。
趋势其实很清晰,未来不会是AI完全取代人,而是把老师傅的经验数字化,和数据模型结合起来,互相补位。模型帮人盯着成千上万的测点,不漏掉任何一个异常信号,人用几十年的现场经验判断真假,拍板决策。
也要清楚限制,对于全新投产、没有历史失效数据的设备,模型根本没有学习样本,这个时候还是得靠人工的定期巡检,靠积累的经验判断,不能迷信模型的能力。
之前听过一个干了四十年运维的南京老师傅说,设备跟人一样,是有脾气的,你天天去摸它听它,才知道它哪不对,机器能帮你记数据,但不能替你摸那一下。这句话我记到现在。
现在市面上概念太多了,换个包装就能吹成黑科技,卖天价,很多企业交了几百万上千万的学费才搞明白,东西好不好用,能不能解决自己的问题,拉到现场跑三个月,比啥PPT都管用。少追概念,多解决具体问题,这条路才能走通。
被误解的“管理”:本质不是管资产,是管失效风险
很多业内人提起这个概念,第一反应就是给资产编号造册,到点定时保养对吧?这根本就是两回事。那是固定资产台账管理,核心是盘点资产保值,和设备能不能稳定运行压根不沾边。 真正的核心,是通过对设备运行状态的实时感知,提前预判潜在的失效风险,把故障消灭在萌芽阶段,避免非计划停机带来的巨额损失。工业旋转轴承失效概率浴盆曲线示意图
行业内公认的设备失效规律就是浴盆曲线,三个阶段:早期投产的磨合失效,中期稳定的随机失效,后期老化的损耗失效。绝大多数企业的运维,都只卡在最后一个阶段救火——等设备出了问题再修,从来不会在前两个阶段收集数据,捕捉异常信号。
刚才提到的那家化工厂,其实十年前就装了振动监测,但是数据都存在本地硬盘,半年才导一次做报表,从来没人实时分析。海量的异常信号就躺在硬盘里睡大觉,等到轴承抱死停线,才后悔没早发现不对。
说实话,国内超七成重资产企业,现在还停留在这个阶段。要理清一个基本前提:它不是万能的,有清晰的应用边界。你办公室的打印复印一体机,坏了换个硒鼓也就几百块,犯不着花几万块装传感器做监测,只有那些停机影响生产、单位时间损失高、维修成本大的核心生产资产,才值得投入资源落地。
数据不是越多越好,脏数据是最大的陷阱
这几年资本吹的厉害,很多厂商动不动就说“全数据采集”“全面覆盖”,仿佛装的传感器越多,效果就越好。扯。 我前年接触过一个苏南的火电项目,业主花了近两千万上整套系统,给汽轮发电机装了上百个传感器,采集了几百个运行参数,结果训练出来的故障预测模型,准确率连百分之三十都达不到,最后整套系统锁在机房落灰。问题出在哪?传感器装错了位置——要求测轴的振动,施工队图方便,全装在了电机外壳上,采集到的全是周边设备的干扰噪声,根本不是核心部件的真实运行数据。用这种数据喂出来的模型,能准确才见鬼了。工业电机振动传感器错误安装位置对比图
这里藏着一个很多项目都踩的关键坑:多数项目是IT或者信息化部门牵头,一线运维老师傅的话语权太弱。设计图上标的位置不对,老师傅指出来要改,乙方说按图施工不能动,最后钱花了,东西没用。
正确的实现路径,得反过来:先拉着一线运维梳理核心部件的失效模式,搞清楚这个部件常见的失效是啥,哪种参数能提前反映异常,再确定测点位置,最后才是数据采集和建模。顺序错了,满盘皆输。
还有一个容易被忽略的风险,数据标注错配。刚出校门的算法工程师没见过真实的设备失效,把正常的负载波动标成异常,把早期的异常信号标成正常,模型的准确率从根上就歪了。
不过话说回来,也不是说只有头部大企业能玩,中小企业不需要望而却步。找核心的三五台设备,每个设备装两三个关键测点,几百块一个传感器,先跑半年验证效果,行了再铺开,远比一口吃个胖子稳妥。
落地的核心:不是无人运维,是人网共生
落地的核心:不是无人运维,是人网共生
现在到处都在吹无人值守、全自动运维,说AI要取代运维工人。我就问一句,你敢让AI直接下达停核心生产线的指令吗?谁敢?
去年在南京的一次行业沙龙上,听过一个省属钢厂的运维总监分享,他们的AI模型发出了二级预警,提示主轧机的齿轮箱异常,需要立即停机检修。结果跟着师傅去现场,师傅拿听声棒一搭,摸了摸箱体温度,说没事,当前轧制的坯料厚,负载大,正常波动,再跑半个月没问题。结果半个月后停线检修,打开齿轮箱啥事都没有,模型确实误报了。
为什么?AI模型学的是历史数据,现场的原材料、环境温度、生产负载每时每刻都在变,模型跟不上实时变化的场景,误报漏报在所难免。真正能落地的项目,都遵循一个基本逻辑:AI出预警,人做最终决策。
这里还有一个长期风险,很多企业上了系统之后,就开始淡化人工运维的作用,觉得有AI盯着就行了,结果经验丰富的老师傅退休之后,年轻人只会看系统弹窗,系统不报警就从来不去现场摸,很多早期的异常根本发现不了,最后憋出大故障。
趋势其实很清晰,未来不会是AI完全取代人,而是把老师傅的经验数字化,和数据模型结合起来,互相补位。模型帮人盯着成千上万的测点,不漏掉任何一个异常信号,人用几十年的现场经验判断真假,拍板决策。
也要清楚限制,对于全新投产、没有历史失效数据的设备,模型根本没有学习样本,这个时候还是得靠人工的定期巡检,靠积累的经验判断,不能迷信模型的能力。
之前听过一个干了四十年运维的南京老师傅说,设备跟人一样,是有脾气的,你天天去摸它听它,才知道它哪不对,机器能帮你记数据,但不能替你摸那一下。这句话我记到现在。
现在市面上概念太多了,换个包装就能吹成黑科技,卖天价,很多企业交了几百万上千万的学费才搞明白,东西好不好用,能不能解决自己的问题,拉到现场跑三个月,比啥PPT都管用。少追概念,多解决具体问题,这条路才能走通。