预测性维护算法:从纸上谈兵到帮工厂省下千万真金白银
去年跟着行业团去东莞考察一家民营轧钢厂,刚进中控室我就被墙上的大屏吸引了。满屏跳动的温度、振动、电流数据,每10秒更新一次,右下角的风险评分条绿黄红跳得清清楚楚。厂长叼着保温杯跟我说,搁五年前,他们这儿轧钢主机一年少说坏两三次,每次停线抢修最少损失几十万,还得熬夜搭进去十几个工人半个月的调休。现在呢?靠预测性维护算法提前一周就能预判异常,去年一年只停过一次计划外检修,算下来纯省了780万。
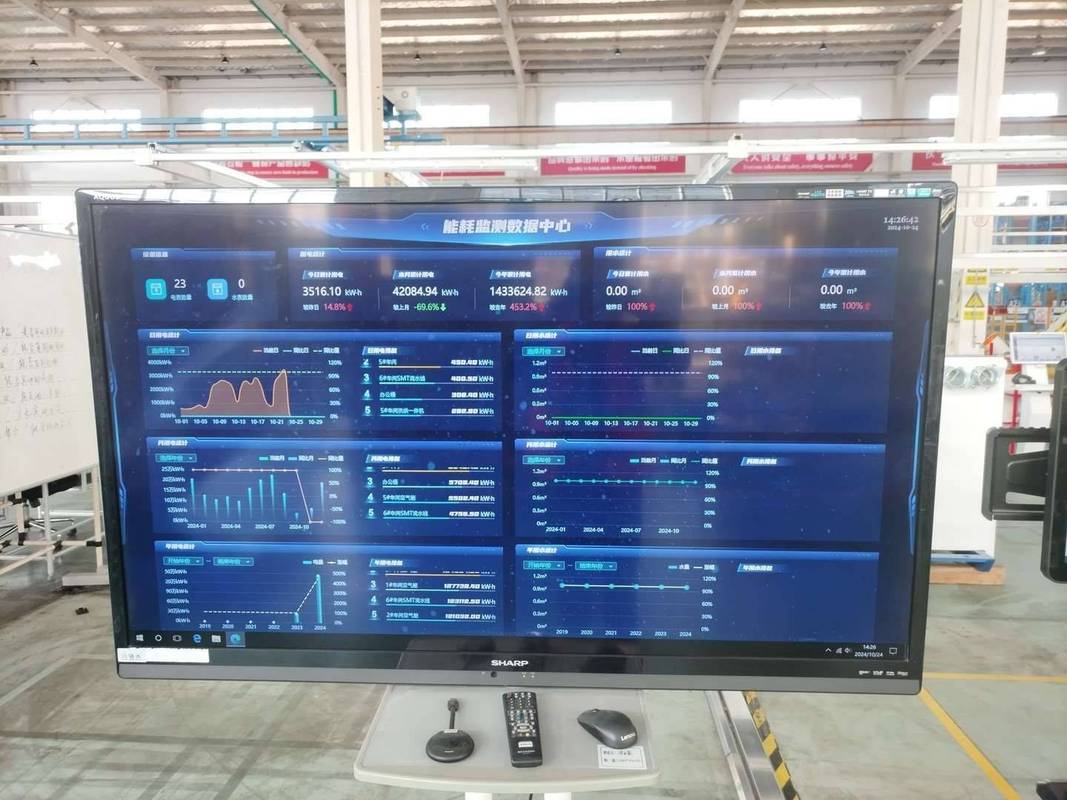 工厂轧钢设备预测性维护算法中控大屏
我去年接触过一个做市政水务的客户,花两百多万上了一套预测性维护系统,结果用了半年,水泵都烧了一台,系统还显示风险0%。后来拆开看,那帮做算法的拿公开的轴承数据集训练完模型,直接就往客户那儿塞,根本没考虑污水泵的腐蚀、负载波动和实验室数据完全是两码事。
这不就是诈骗吗?很多团队做算法,就只会调开源包,根本不接地气。拿着通用数据套所有场景,不出问题才怪。
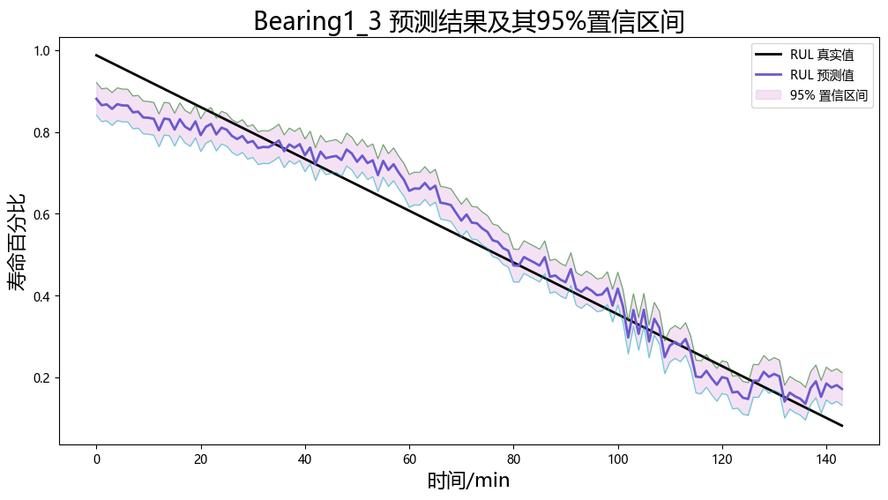 滚动轴承预测性维护算法剩余寿命预测曲线图
不过话说回来,不是越复杂的算法越好用。我见过一家做食品加工的工厂,非要给十几台包装机上大模型做预测性维护,一台包装机才几十万,算法投入就花了近百万,推理一次要十秒,包装机一分钟转六十圈,十秒够转十圈了,就算预测出来故障,也已经出问题了。
说白了,适合的才是好的。你十几台分散的风机,用优化好的XGBoost足够,准确率能到96%以上,成本不到深度学习的五分之一。犯不着追新凑热闹。
 落地的时候,这三个坑90%的团队都会踩
第一个坑,故障数据匮乏。正常设备谁天天坏啊?大部分工厂跑个两三年,也就攒个几十上百份故障数据,深度学习模型需要成千上万的样本,根本不够喂。很多团队直接拿公开数据集凑,结果到现场完全不适配。现在业内比较好的解法是用半监督学习或者自监督学习,拿海量的正常数据预训练,再用少量故障数据微调,效果比纯监督学习好太多。
第二个坑,脱离现场工艺。算法工程师天天坐在写字楼里调参,根本不知道现场传感器哪个被灰尘糊住了,哪个本身就精度差,把无效特征当宝贝,结果模型准确率上不去。我上次给一个钢厂做顾问,发现他们算法模型把一个坏了半年的温度传感器当核心特征,换了传感器之后准确率直接涨了20%。你说冤不冤?
第三个坑,追求完美准确率。很多老板说,我要零误报,不然我不信你。可实际上呢?就算准确率做到90%,提前三天预警,就算有10%的误报,你安排个免费的巡检花不了几个钱,总比突然坏了停线损失几十万强吧?我见过太多团队为了降几个点的误报,把模型调得越来越保守,结果漏了真故障,赔了夫人又折兵。
说实话,现在国内智能制造推进得快,很多工厂都在往数字化转,预测性维护算法是我见过最容易落地、最容易拿到回报的工业AI应用。不用搞那些花里胡哨的概念,能帮工厂省钱,能帮工人少熬几次抢修的通宵,就是好算法。对吧?
别拿伪预测性维护骗钱了,九成项目没摸到核心
现在工业圈谁不提预测性维护?厂商招标不说自己带AI算法都不好意思打招呼。可实际上呢?十有八九是把原来的定期保养换了个皮,套个算法的壳就敢卖百万价格。 什么是真的?说白了就是靠设备全生命周期的实时数据,训练算法模型,在故障发生前一周甚至半个月,精准告诉你哪台设备哪个部件要坏,风险有多高。不是拍脑袋定三个月保养一次,到点就拆机器换零件——那叫预防性维护,不是预测性。工厂轧钢设备预测性维护算法中控大屏
我去年接触过一个做市政水务的客户,花两百多万上了一套预测性维护系统,结果用了半年,水泵都烧了一台,系统还显示风险0%。后来拆开看,那帮做算法的拿公开的轴承数据集训练完模型,直接就往客户那儿塞,根本没考虑污水泵的腐蚀、负载波动和实验室数据完全是两码事。
这不就是诈骗吗?很多团队做算法,就只会调开源包,根本不接地气。拿着通用数据套所有场景,不出问题才怪。
当下主流的预测性维护算法,到底哪个能打?
不少人一听说算法就觉得越深越好,越新越好,其实完全不是这么回事。现在市面上能用在生产里的算法,大概分三类,各有各的适用场景。 第一类是传统统计方法,比如最常用的威布尔分布寿命预测,原理就是靠同型号部件的失效数据,算出来不同时间的故障率。这个方法简单,成本低,适合部件标准化、故障率规律的场景,比如风场的风机轴承,汽车的发动机零件,准确率其实不低。但是碰到复杂的、定制化的大型设备,直接歇菜。 第二类是传统机器学习算法,比如XGBoost、随机森林这些。这个是现在工业界落地最多的,能同时处理十几个甚至上百个传感器的数据,把振动、温度、电流这些特征揉在一起,提取异常信号,准确率比统计方法高一大截。而且模型小,推理快,传感器传过来数据,几毫秒就能出结果,完全适配工业现场的实时性要求。 第三类就是近几年火到发紫的深度学习算法,尤其是Transformer和图神经网络。我看过浙大团队最新的成果,用图神经网络建模整条生产线的设备关联关系,上游设备的微小异常会影响下游,模型能直接把根因找出来,准确率比传统方法高10%到15%。滚动轴承预测性维护算法剩余寿命预测曲线图
不过话说回来,不是越复杂的算法越好用。我见过一家做食品加工的工厂,非要给十几台包装机上大模型做预测性维护,一台包装机才几十万,算法投入就花了近百万,推理一次要十秒,包装机一分钟转六十圈,十秒够转十圈了,就算预测出来故障,也已经出问题了。
说白了,适合的才是好的。你十几台分散的风机,用优化好的XGBoost足够,准确率能到96%以上,成本不到深度学习的五分之一。犯不着追新凑热闹。
落地的时候,这三个坑90%的团队都会踩
落地的时候,这三个坑90%的团队都会踩
第一个坑,故障数据匮乏。正常设备谁天天坏啊?大部分工厂跑个两三年,也就攒个几十上百份故障数据,深度学习模型需要成千上万的样本,根本不够喂。很多团队直接拿公开数据集凑,结果到现场完全不适配。现在业内比较好的解法是用半监督学习或者自监督学习,拿海量的正常数据预训练,再用少量故障数据微调,效果比纯监督学习好太多。
第二个坑,脱离现场工艺。算法工程师天天坐在写字楼里调参,根本不知道现场传感器哪个被灰尘糊住了,哪个本身就精度差,把无效特征当宝贝,结果模型准确率上不去。我上次给一个钢厂做顾问,发现他们算法模型把一个坏了半年的温度传感器当核心特征,换了传感器之后准确率直接涨了20%。你说冤不冤?
第三个坑,追求完美准确率。很多老板说,我要零误报,不然我不信你。可实际上呢?就算准确率做到90%,提前三天预警,就算有10%的误报,你安排个免费的巡检花不了几个钱,总比突然坏了停线损失几十万强吧?我见过太多团队为了降几个点的误报,把模型调得越来越保守,结果漏了真故障,赔了夫人又折兵。
说实话,现在国内智能制造推进得快,很多工厂都在往数字化转,预测性维护算法是我见过最容易落地、最容易拿到回报的工业AI应用。不用搞那些花里胡哨的概念,能帮工厂省钱,能帮工人少熬几次抢修的通宵,就是好算法。对吧?