代码大模型:看上去很美,踩过坑才知道的能力边界
上个月在南京江心洲跟几个做企业服务的朋友吃饭,酒过三巡,一半的人都在骂。骂的就是那个最近火得发烫的东西。能提效率是真的,落到生产环节,十有八九要踩坑也是真的。
 代码大模型训练语料编程语言分布图
很多厂商宣传的时候只说准确率,不说这个准确率是在什么数据集上测出来的。都是挑热门场景的样例测,当然好看。换个冷场景,准确率直接掉一半都不奇怪。
没人会把自己踩坑的数据放出来给你看。
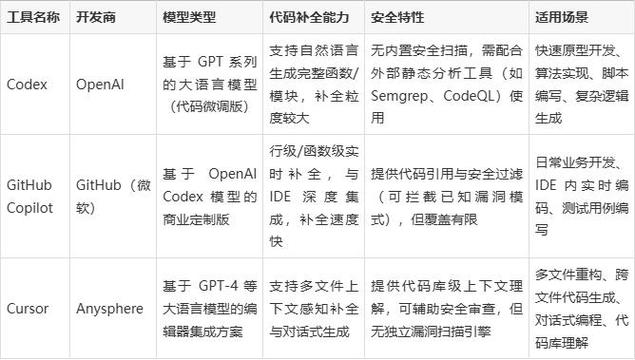 代码大模型生成隐式漏洞案例对比图
不是不能用,是不能瞎用。现在很多成熟团队把它用来写单元测试、补注释、转代码格式、把老语言的代码搬去新框架,把重复的体力活干了,确实能省不少时间。非要让它写核心业务逻辑,出了问题背锅的还是自己。
我见过最夸张的案例,一家小公司的开发偷懒,把整个支付模块全让模型生成,上线半个月才发现,用户提现的时候,模型生成的代码把银行卡号做了截断,一千多个用户提不了现,差点把公司搞黄。
 接下来的方向,要落地不要讲故事
现在市面上一堆项目,上来就说要做通用的全代码生成,听着就悬。通用意味着什么都能做一点,什么都做不精。
真正能落地的方向,反而都是垂直的。比如给芯片设计行业做专属的,基于行业内部开源代码和企业自有代码微调,只解决特定场景的验证代码生成问题。或者给前端团队做,只生成符合团队自有规范的组件代码,把编码规则提前训练进去,不用开发写完再改一遍格式。
这种小而准的方向,反而比吹出来的通用大模型更能赚钱,也更能解决实际问题。
不过话说回来,它带来的隐忧也不能忽略。我最近面试几个刚毕业的学生,写个最简单的快速排序都能写错边界条件,问他怎么回事,说平时写代码都是让模型生成,自己很少手动敲逻辑,更别说跟着报错日志一点点调bug了。
下一代开发者会不会失去排查底层问题的能力?这个问题现在没人能给出确定的答案。
它终究只是个工具。工具的价值,是帮人省时间干更重要的事,不是帮人把所有事都干了。现在很多人把它吹得玄乎,好像再过两年程序员都要失业,真的不至于。
你去路边看看,挖掘机普及这么多年,挖机司机还是要持证上岗,还是得人开,对吧?只是原来靠人工一锹一锹挖的活,现在几分钟就干完了。本质是一样的。
剩下的,就是看谁能踩对坑,找到真正适合它的位置而已。
被放大的能力,被藏起来的前提
很多人说它能替代程序员,这话骗骗外行还行。它的核心机制,说白了就是基于训练语料的统计概率预测,下一个token该出什么。训练数据的分布偏差,直接决定了它能做什么,不能做什么。 热门语言比如Java、Python,GitHub上千万级的开源项目喂进去,补全、写个通用工具逻辑,确实顺。可换个场景呢? 当你需要给十年前写的工厂MES系统写一个对接新设备的驱动模块,整个项目用的还是现在几乎没人维护的Delphi,翻遍公开语料都找不到百行以上同环境的正确代码,生成出来的东西连语法检查都过不了。 更别说很多行业定制场景,代码根本不会公开,全在企业本地存着,预训练根本没见过这种业务逻辑。代码大模型训练语料编程语言分布图
很多厂商宣传的时候只说准确率,不说这个准确率是在什么数据集上测出来的。都是挑热门场景的样例测,当然好看。换个冷场景,准确率直接掉一半都不奇怪。
没人会把自己踩坑的数据放出来给你看。
看不见的暗坑:能用和好用是两回事
我上个月帮一家创业公司改他们的用户引流脚本,开发说用某模型生成了核心的请求分发逻辑,跑测试没问题,一上线到一万并发就崩。 查了整整两天。最后发现,生成的代码里,每次请求都重新初始化一次数据库连接池,没做复用。测试环境只有几十并发,根本发现不了。压力一上来,直接把数据库连接数打满。 这种就是隐式逻辑漏洞,从语法上看完全正确,跑小流量也没问题,只有在特定生产条件下才会触发。更可怕的是,很多漏洞还带知识产权问题。 训练语料里混了不少带GPL协议的开源代码,生成出来的代码片段,跟原开源项目的某段逻辑几乎一模一样。你直接拿去用在闭源的商业项目里,哪天被原作者找上门索赔,连说理的地方都没有。 说实话,现在但凡有点规模的互联网公司,核心生产系统的代码,都不让直接贴进去生成。怕的就是数据泄露,还有这种法律风险。代码大模型生成隐式漏洞案例对比图
不是不能用,是不能瞎用。现在很多成熟团队把它用来写单元测试、补注释、转代码格式、把老语言的代码搬去新框架,把重复的体力活干了,确实能省不少时间。非要让它写核心业务逻辑,出了问题背锅的还是自己。
我见过最夸张的案例,一家小公司的开发偷懒,把整个支付模块全让模型生成,上线半个月才发现,用户提现的时候,模型生成的代码把银行卡号做了截断,一千多个用户提不了现,差点把公司搞黄。
接下来的方向,要落地不要讲故事
接下来的方向,要落地不要讲故事
现在市面上一堆项目,上来就说要做通用的全代码生成,听着就悬。通用意味着什么都能做一点,什么都做不精。
真正能落地的方向,反而都是垂直的。比如给芯片设计行业做专属的,基于行业内部开源代码和企业自有代码微调,只解决特定场景的验证代码生成问题。或者给前端团队做,只生成符合团队自有规范的组件代码,把编码规则提前训练进去,不用开发写完再改一遍格式。
这种小而准的方向,反而比吹出来的通用大模型更能赚钱,也更能解决实际问题。
不过话说回来,它带来的隐忧也不能忽略。我最近面试几个刚毕业的学生,写个最简单的快速排序都能写错边界条件,问他怎么回事,说平时写代码都是让模型生成,自己很少手动敲逻辑,更别说跟着报错日志一点点调bug了。
下一代开发者会不会失去排查底层问题的能力?这个问题现在没人能给出确定的答案。
它终究只是个工具。工具的价值,是帮人省时间干更重要的事,不是帮人把所有事都干了。现在很多人把它吹得玄乎,好像再过两年程序员都要失业,真的不至于。
你去路边看看,挖掘机普及这么多年,挖机司机还是要持证上岗,还是得人开,对吧?只是原来靠人工一锹一锹挖的活,现在几分钟就干完了。本质是一样的。
剩下的,就是看谁能踩对坑,找到真正适合它的位置而已。