拆墙:近存计算如何打破半个世纪的算力困局
冯诺依曼架构的发明,把计算机拉进了发展的快车道。
但从诞生第一天起,它就带了个天生的bug。
存储和计算分家。
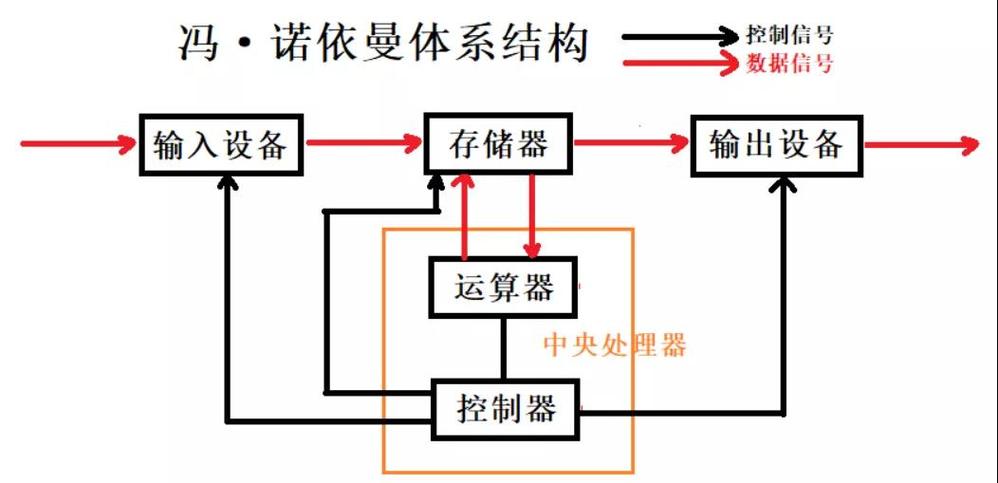 冯诺依曼架构内存墙性能瓶颈示意图
业内想了很多办法拆墙。存算一体是一条路,把计算直接做进存储单元里,但是架构改得太狠,软件生态全部要推翻重来,短期根本落不了地。还有高带宽内存、光互联,都是在总线层面挤牙膏,没解决根本问题。
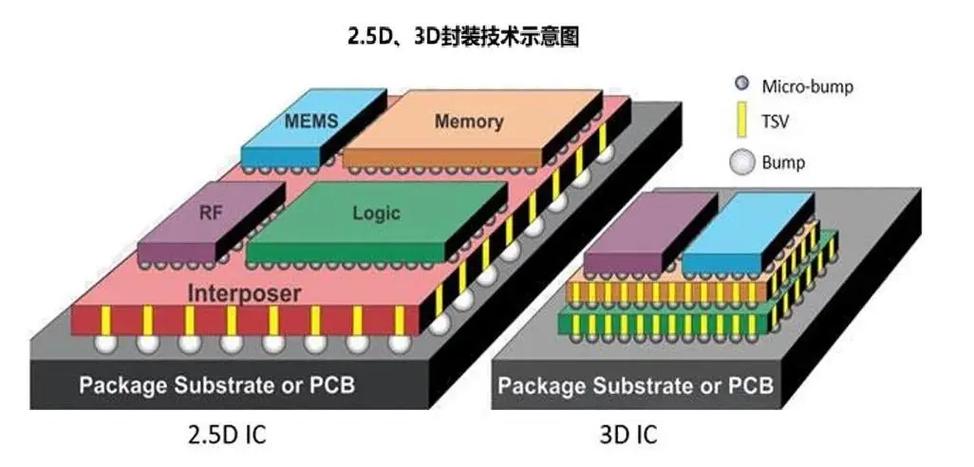 3D堆叠近存计算芯片封装结构图
大家都盯着硬件堆叠的进度,其实最难啃的骨头在软件。原来的软件栈都是为存储计算分离设计的,怎么划分近存远存的地址空间?怎么调度不同访存特征的任务?怎么让开发者不用改太多代码就能用上?这些都是现在没完全解决的问题。很多做出来的原型芯片,性能纸面数据很好看,一跑实际业务任务就拉胯,就是软件适配没跟上。
 落地路上的坑,比纸面参数多得多
第一个坑就是成本。3D堆叠现在良率还上不去,一块叠了八层存储die的芯片,报废率比传统封装高两三倍,卖价自然降不下来。现在只有对单位算力能耗极度敏感的大客户愿意买单,普通消费级芯片根本用不起。
第二个坑就是概念炒得太凶。说实话,现在很多厂商把原来用了好几年的高带宽内存加速方案,换个名字就拿出来吹,骗资本的钱。你去抠参数,其实和传统方案比,性能提升不到百分之二十,价格翻了一倍,这不就是换皮割韭菜吗?离谱。
它从来就不是万能的算力解药,应用边界非常清晰。未来三五年,肯定是先在云侧的访存密集型场景落地,比如向量数据库加速、大模型推理加速,这些场景能接受高成本,也能快速拿到收益。消费端的话,可能最先用在端侧大模型的手机芯片上,毕竟端侧内存空间有限,访存压力大,降延迟提续航的需求很迫切。
现在整个行业都在往AI算力赛道挤,一窝蜂上马项目,很多团队根本没搞清楚自己要解决什么问题,先把概念堆上拿融资,最后大概率会淘汰一大批虚火的项目,留下真正啃硬骨头改技术的玩家。
半个世纪的老墙,不是一朝一夕能拆掉的。它不是什么颠覆性的革命,就是一步一步给现有架构续寿命的务实方案。至于未来会不会成为主流,还要看硬件成本和软件生态能不能跟得上,咱们走着瞧。
拖了五十年的老墙,终于挡不住路了
早期芯片制程落后,计算单元的速度才是瓶颈,存储和计算之间的带宽差没人在意。 这几十年制程工艺跟着摩尔定律一路往下缩,计算单元的速度翻了不知道多少倍,内存的访问速度提升却慢得像蜗牛——两者的差距已经拉到了上千倍。 现在大模型跑推理,推荐系统做召回,百分之八十以上的时间,计算单元都在空等数据。能耗更夸张,数据每走一厘米的总线,消耗的能量是做一次浮点运算的上百倍。 之前跑一个千亿参数大模型的单次推理,光数据搬运的能耗就占了总能耗的九成以上,剩下不到一成才是真的用来做计算。冯诺依曼架构内存墙性能瓶颈示意图
业内想了很多办法拆墙。存算一体是一条路,把计算直接做进存储单元里,但是架构改得太狠,软件生态全部要推翻重来,短期根本落不了地。还有高带宽内存、光互联,都是在总线层面挤牙膏,没解决根本问题。
不是推倒重来,是给旧架构搭个新台阶
很多人容易把它和存算一体混为一谈,说实话,这俩根本不是一回事。它是在现有冯诺依曼框架下做的渐进式重构,核心就是把计算单元尽可能往存储旁边挪,缩短数据要走的路,本质是拆墙,不是盖个全新的房子。 现在主流的实现方式,要么是把计算逻辑做进同一块存储芯片的die里,要么用3D堆叠把计算die和存储die叠在一起,要么就是把高带宽内存和计算封装在同一个硅基板上,不管哪种,核心都是缩短访存路径,提带宽降延迟。 不是所有任务都能吃这个红利。访存密集型任务,比如大模型离线推理、推荐系统的Embedding检索、向量数据库查询,这些任务大部分操作都是读数据,计算量不大,受益最明显。举个例子,向量检索里,把全量向量放近存,查询延迟能压到原来的十分之一,能耗降一半以上。反过来,纯计算密集型任务,比如气象模拟的大规模矩阵运算,大部分时间计算单元都在忙,没多少时间等数据,收益就非常有限,甚至因为额外的封装成本,性价比反而更低。3D堆叠近存计算芯片封装结构图
大家都盯着硬件堆叠的进度,其实最难啃的骨头在软件。原来的软件栈都是为存储计算分离设计的,怎么划分近存远存的地址空间?怎么调度不同访存特征的任务?怎么让开发者不用改太多代码就能用上?这些都是现在没完全解决的问题。很多做出来的原型芯片,性能纸面数据很好看,一跑实际业务任务就拉胯,就是软件适配没跟上。
落地路上的坑,比纸面参数多得多
落地路上的坑,比纸面参数多得多
第一个坑就是成本。3D堆叠现在良率还上不去,一块叠了八层存储die的芯片,报废率比传统封装高两三倍,卖价自然降不下来。现在只有对单位算力能耗极度敏感的大客户愿意买单,普通消费级芯片根本用不起。
第二个坑就是概念炒得太凶。说实话,现在很多厂商把原来用了好几年的高带宽内存加速方案,换个名字就拿出来吹,骗资本的钱。你去抠参数,其实和传统方案比,性能提升不到百分之二十,价格翻了一倍,这不就是换皮割韭菜吗?离谱。
它从来就不是万能的算力解药,应用边界非常清晰。未来三五年,肯定是先在云侧的访存密集型场景落地,比如向量数据库加速、大模型推理加速,这些场景能接受高成本,也能快速拿到收益。消费端的话,可能最先用在端侧大模型的手机芯片上,毕竟端侧内存空间有限,访存压力大,降延迟提续航的需求很迫切。
现在整个行业都在往AI算力赛道挤,一窝蜂上马项目,很多团队根本没搞清楚自己要解决什么问题,先把概念堆上拿融资,最后大概率会淘汰一大批虚火的项目,留下真正啃硬骨头改技术的玩家。
半个世纪的老墙,不是一朝一夕能拆掉的。它不是什么颠覆性的革命,就是一步一步给现有架构续寿命的务实方案。至于未来会不会成为主流,还要看硬件成本和软件生态能不能跟得上,咱们走着瞧。