类脑芯片研发:为什么它才是下一代AI的真正底盘
堆出来的大模型,已经摸到了天花板
现在训练一个千亿参数的大模型,要烧掉上百万度电。这个数字够一个普通三口之家用上一百年。
所有的能耗,大半都耗在了冯诺依曼架构的存储墙瓶颈上。传统芯片把计算和存储分开,每次运算都要把数据从内存搬到计算单元,搬来搬去的损耗,比真正做计算的损耗还要大好几倍。
说白了,现在我们喂给AI越多数据,它要搬的东西就越多,浪费的电就越恐怖。这条路走到最后,只有少数几个巨头能玩得起,绝大多数玩家连门都摸不到。
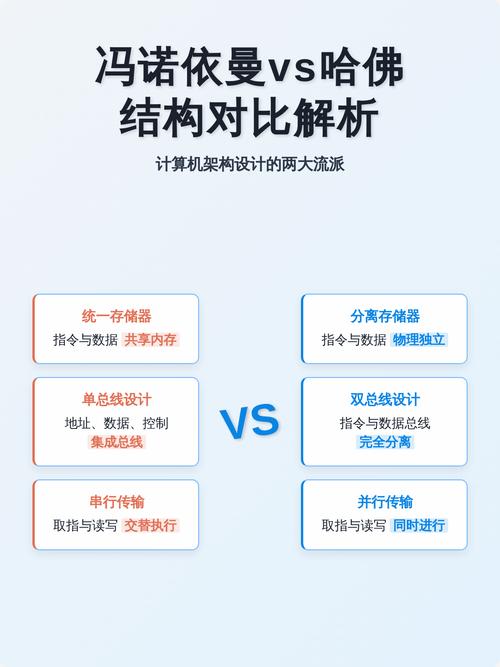 传统冯诺依曼架构与类脑架构功耗对比图
你说,这样的AI,真的能走进千千万万的终端设备吗?靠堆算力堆出来的智能,怎么看都像是温室里的花朵,撑不起下一代AI的未来。
类脑芯片研发,真不是炒出来的概念
很多人一听到类脑,第一反应就是“又是资本炒出来骗钱的吧?”。说实话,换十年前我也这么想。可现在真不一样了。
类脑的核心逻辑其实特别简单:模仿人脑的工作方式做芯片。人脑才多重?一千多克。功耗才多少?二十多瓦。就这么点能耗,能同时处理图像、声音、逻辑推理,还能边走边学,现在全世界最厉害的超级计算机都做不到。
现在类脑芯片研发主要走两条路:一条是结构类脑,直接在硬件上模拟神经元和突触的连接,用脉冲信号传递信息,也就是我们常说的脉冲神经网络硬件;另一条是功能类脑,不纠结完全复制人脑结构,只模仿人脑低功耗并行计算的特点,做适配AI算法的定制芯片。
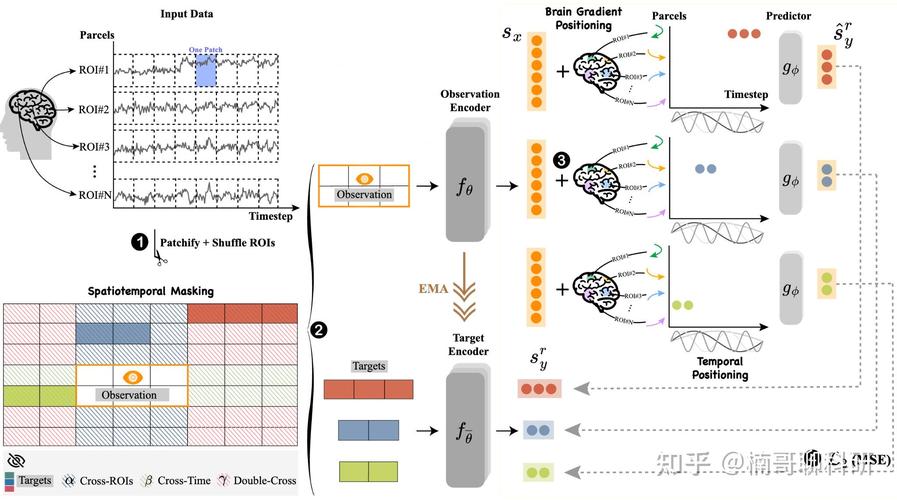 类脑芯片神经元突触模拟电路原理图
我给你报个真实的数据,清华研发的第二代天机芯,做实时无人驾驶目标检测,功耗不到传统GPU的百分之一。准确率还没降多少。
我当时第一次看到这个测试结果,差点把眼镜摔了。
现在已经有不少场景落地了:低功耗的端侧AI摄像头,植入式的医疗设备,还有机器人的实时控制,这些对功耗要求极高的场景,类脑芯片已经开始干活了。不是实验室里的玩具,是真能产出价值的产品。
现在卡脖子的坎,都是未来开门的钥匙
 现在卡脖子的坎,都是未来开门的钥匙
不过话说回来,类脑芯片研发要走的路还长着呢。卡脖子的地方一抓一大把。
第一个坎,就是我们对人脑本身就没搞懂。我们知道人脑有八百多亿神经元,知道神经元靠突触传递脉冲信号,可具体怎么完成学习、怎么存储记忆,现在还有一大堆未解之谜。我们现在做的类脑,说白了还是模仿了个皮毛,离真正的人脑智能还差得远。
第二个坎,是器件的瓶颈。类脑芯片需要能模拟突触可塑性的新型器件,比如忆阻器,对材料和工艺的要求特别高,现在很多高端器件的良率还上不去,成本降不下来,就没法大规模量产。
第三个坎,是生态。现在做AI开发大家都用CUDA,生态成熟,工具链全。类脑芯片现在还没有统一的开发框架,开发者要重新学,重新适配,自然就没多少人愿意用。没有应用反哺,研发的动力就会弱很多。
可话说回来,哪一个新赛道不是这么过来的?当年GPU刚做AI推理的时候,不也没人看好吗?
国内现在的研发进度,其实真的不慢。清华的天机芯,中科院的忆阻器类脑芯片,还有不少创业公司已经在做场景落地了,我们在脉冲神经网络这块的积累,不比国外差。
类脑芯片也不是要彻底取代现在的GPU和CPU。至少未来二十年,都是互补的关系:大模型训练还是靠GPU,端侧推理、低功耗场景交给类脑芯片。以后你的手机里装一块类脑芯片,本地就能处理所有AI请求,不用把数据传到云端,既隐私又快,还不费电。以后家用机器人不用联网,本地就能实时处理各种突发情况,反应比云端快好几倍。
这样的未来,难道不香吗?
我现在逛技术论坛,经常看到有人吵类脑到底是未来还是骗局。我每次都想说,你别着急下结论。
给研发一点时间。十年后再看,你会发现现在这群蹲在实验室里啃硬骨头的人,走的才是AI真正的出路。