联邦学习技术:把数据隐私捏在自己手里的新玩法
你有没有碰到过这种情况?想做个准一点的AI模型,需要多家机构的数据,可谁都不敢把手里的原始数据交出去。给吧,违反隐私法规,搞不好还要吃罚单;不给吧,模型训不出来,项目直接凉凉。这种两难,最近这些年慢慢有了靠谱的解法——就是我们今天说的联邦学习技术。
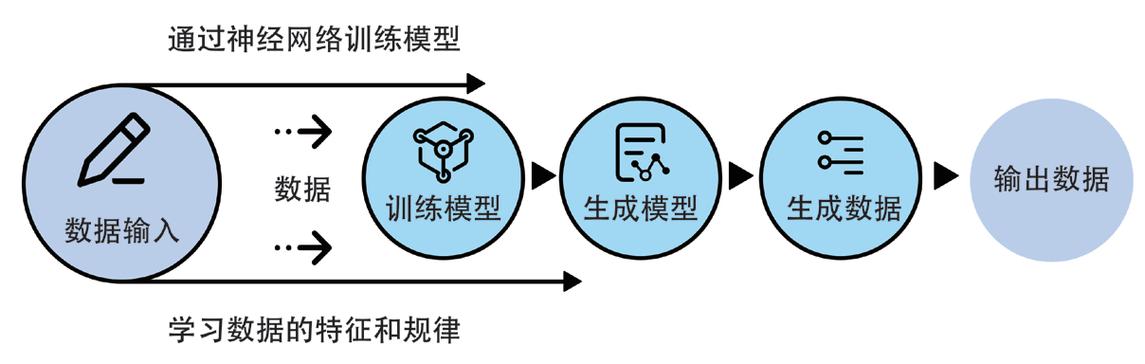 传统集中式AI训练数据流向示意图
我之前认识一个做医疗AI的创业者,跟我吐了快两小时苦水。他想做一个肺癌早期筛查的AI模型,需要五家医院的CT影像数据,结果每家医院的伦理委员会都过不了,谁敢把患者的影像往外发?项目拖了两年,钱烧完了,最后只能卖给大公司。这种例子真的太多了。需求摆在那里,政策不允许,技术就得跟着变。联邦学习就是这么被逼出来的。
 横向联邦学习模型参数交互示意图
现在常见的联邦学习主要分两类,一类是横向联邦学习,就是刚才说的这种,各家的业务相同,用户不同,相当于按行切数据,特征空间是一样的;还有一类叫纵向联邦学习,就是不同机构有不同特征,用户重叠度很高,比如同一个城市,电商有用户的消费记录,银行有用户的信贷记录,运营商有用户的出行记录,三家把特征合起来训模型,谁也不拿对方的原始数据,相当于按列切数据,用户空间相同,特征不同。两种场景覆盖了绝大多数跨机构合作的需求。
别听那些顶会论文写得云里雾里,绕来绕去,核心就是一句话:我不拿你的数据,我只跟你交换计算结果,大家一起把模型做好。太朴素了,对不对?
 落地现状:已经能用,但坑还不少
现在联邦学习不是停在论文里的概念,已经大规模落地了。最多的就是金融行业,风控、反欺诈、营销获客,大把在用。我知道的几家头部股份制银行,跨机构联合训的风控模型,比单机构训的准确率提了12%以上,坏账率降了快8个点,效果实打实的。
医疗行业现在落地也很快,刚才说的影像筛查,还有药物研发,都在用联邦学习。之前看柳叶刀子刊今年初发的研究,欧美多家医院用联邦学习训的乳腺癌筛查模型,准确率比单中心训的高了快20%,而且完全符合HIPAA的隐私要求,太能说明问题了。还有现在火得一塌糊涂的大模型,很多机构也开始用联邦学习做大模型训练了——每个机构训自己的领域大模型,用联邦学习聚合参数,不用把所有敏感数据集中到一块,既省了成本,又解决了隐私问题,这个方向现在火得要命。
不过话说回来,现在联邦学习的坑也真不少。我给你数几个最明显的。第一,通信成本太高了。你想啊,动辄上百轮的参数交互,大模型的参数都是千亿级的,来回传,网络稍微差一点,能卡到你怀疑人生。现在虽然有梯度压缩、稀疏化这些方法,但还是没完全解决。第二,绝对的安全还是做不到。很多人说联邦学习不碰原始数据就是绝对安全,其实不对,已经有不少研究证明,通过梯度反推,是可以还原出一部分原始用户数据的,只是难度比直接拿数据高很多,一般人也不会费这个劲,但技术上确实有漏洞。现在大家也在把同态加密、差分隐私这些技术和联邦学习结合,补这个漏洞,就是成本又上去了。第三,协调成本太高了。你拉十家机构搭联邦学习平台,光是谈谁当协调方,数据出问题谁担责,利益怎么分,就能谈半年,比技术问题头疼一百倍。
但是你说这些问题是不是解决不了?倒也不是。技术在迭代,行业标准也在慢慢出来,现在国内已经有不少机构在做联邦学习的行业标准了,以后对接起来就容易多了。
我自己对这个技术还是挺看好的。原来AI发展这么多年,一直绕不开一个悖论:要AI好用,就得拿更多用户数据,要拿用户数据,就大概率要牺牲隐私。联邦学习相当于给这个悖论找了一个双赢的解。你要模型精度,我要隐私安全,大家各取所需,谁也不用牺牲谁。未来说不定再过个三五年,所有跨机构的AI合作,都会默认用联邦学习了。你说对吧?
为什么集中数据训模型越来越走不通了
早十年AI火起来的时候,大家默认的规则就是“数据为王”,谁手里数据多,谁的模型就好。大公司疯狂攒数据,小公司想蹭都蹭不到,更别说医院、金融这种监管严的行业,数据连出内网都不行。 现在呢?规则变了。不管是国内的《个人信息保护法》,还是欧盟的GDPR,对数据流通管得越来越严。去年还有一家持牌消费金融公司因为违规共享用户数据,罚了快八百万,对吧?就算你不怕罚款,哪家用户愿意把自己的病历、银行流水随便给陌生人用? 数据出不来,大家手里的数据就成了一个个孤岛。看起来储量丰富,就是用不了。传统集中式AI训练数据流向示意图
我之前认识一个做医疗AI的创业者,跟我吐了快两小时苦水。他想做一个肺癌早期筛查的AI模型,需要五家医院的CT影像数据,结果每家医院的伦理委员会都过不了,谁敢把患者的影像往外发?项目拖了两年,钱烧完了,最后只能卖给大公司。这种例子真的太多了。需求摆在那里,政策不允许,技术就得跟着变。联邦学习就是这么被逼出来的。
联邦学习技术的核心逻辑其实一点都不复杂
很多人听这个名字觉得玄乎,什么联邦不联邦,是不是又是资本炒出来的概念?说实话,真不是。它的核心逻辑一句话就能说清楚:数据不动,模型动。 啥意思?原来你要训模型,得把所有人的原始数据都搬到同一个数据中心,算完再出模型。联邦学习反过来,原始数据存在谁家,就一直待在谁家,不用动。各家只需要把自己训练完更新的模型参数,或者说梯度,传给协调方,协调方把所有参数聚合之后,再把更新好的全局模型发回给各家。来回迭代个几十上百轮,模型就能训好。从头到尾,没有人能拿到别人的原始数据。完美符合隐私法规的要求。 举个实际的例子,三家城商行要一起训反欺诈模型。每家都有自己的几千万用户数据,原始数据都存在自己行里的服务器里。第一轮,大家都用自己的数据训初始模型,算出参数更新,发给统一的协调节点,协调节点把三家的参数按权重加起来,得到新的全局模型,再发回去。第二轮,三家再用自己的数据更新这个全局模型,再传参数……来回几十轮,模型的准确率就上去了。谁也没碰谁的原始数据,大家一起用上了更多数据的优势,这不比自己闷头训强?横向联邦学习模型参数交互示意图
现在常见的联邦学习主要分两类,一类是横向联邦学习,就是刚才说的这种,各家的业务相同,用户不同,相当于按行切数据,特征空间是一样的;还有一类叫纵向联邦学习,就是不同机构有不同特征,用户重叠度很高,比如同一个城市,电商有用户的消费记录,银行有用户的信贷记录,运营商有用户的出行记录,三家把特征合起来训模型,谁也不拿对方的原始数据,相当于按列切数据,用户空间相同,特征不同。两种场景覆盖了绝大多数跨机构合作的需求。
别听那些顶会论文写得云里雾里,绕来绕去,核心就是一句话:我不拿你的数据,我只跟你交换计算结果,大家一起把模型做好。太朴素了,对不对?
落地现状:已经能用,但坑还不少
落地现状:已经能用,但坑还不少
现在联邦学习不是停在论文里的概念,已经大规模落地了。最多的就是金融行业,风控、反欺诈、营销获客,大把在用。我知道的几家头部股份制银行,跨机构联合训的风控模型,比单机构训的准确率提了12%以上,坏账率降了快8个点,效果实打实的。
医疗行业现在落地也很快,刚才说的影像筛查,还有药物研发,都在用联邦学习。之前看柳叶刀子刊今年初发的研究,欧美多家医院用联邦学习训的乳腺癌筛查模型,准确率比单中心训的高了快20%,而且完全符合HIPAA的隐私要求,太能说明问题了。还有现在火得一塌糊涂的大模型,很多机构也开始用联邦学习做大模型训练了——每个机构训自己的领域大模型,用联邦学习聚合参数,不用把所有敏感数据集中到一块,既省了成本,又解决了隐私问题,这个方向现在火得要命。
不过话说回来,现在联邦学习的坑也真不少。我给你数几个最明显的。第一,通信成本太高了。你想啊,动辄上百轮的参数交互,大模型的参数都是千亿级的,来回传,网络稍微差一点,能卡到你怀疑人生。现在虽然有梯度压缩、稀疏化这些方法,但还是没完全解决。第二,绝对的安全还是做不到。很多人说联邦学习不碰原始数据就是绝对安全,其实不对,已经有不少研究证明,通过梯度反推,是可以还原出一部分原始用户数据的,只是难度比直接拿数据高很多,一般人也不会费这个劲,但技术上确实有漏洞。现在大家也在把同态加密、差分隐私这些技术和联邦学习结合,补这个漏洞,就是成本又上去了。第三,协调成本太高了。你拉十家机构搭联邦学习平台,光是谈谁当协调方,数据出问题谁担责,利益怎么分,就能谈半年,比技术问题头疼一百倍。
但是你说这些问题是不是解决不了?倒也不是。技术在迭代,行业标准也在慢慢出来,现在国内已经有不少机构在做联邦学习的行业标准了,以后对接起来就容易多了。
我自己对这个技术还是挺看好的。原来AI发展这么多年,一直绕不开一个悖论:要AI好用,就得拿更多用户数据,要拿用户数据,就大概率要牺牲隐私。联邦学习相当于给这个悖论找了一个双赢的解。你要模型精度,我要隐私安全,大家各取所需,谁也不用牺牲谁。未来说不定再过个三五年,所有跨机构的AI合作,都会默认用联邦学习了。你说对吧?