语音识别技术:早就不是你以为的转文字工具了
从“猜声音”到“懂语言”,底层逻辑换了三茬
早在上世纪五十年代,全世界第一个语音识别系统就出来了,那玩意儿什么水平?只能认0到9十个数字,还得同一个人慢慢说,换个人就认不出来。错一半都是常事。
后来到了九十年代,统计模型起来了,GMM-HMM架构统治了业界快二十年,那时候终于能认连续语音了,普通人慢慢说,它能转个七七八八。可你只要口音重一点,周围有点背景音,它直接给你瞎编内容。说实话我早年玩初代Siri,问“今天北京天气”,它给我打开炒股软件,这种事都发生过好几次,笑到直不起腰。
直到最近十年,深度学习起来,Transformer架构横空出世,整个赛道直接换了玩法。现在主流的端到端语音识别模型,根本不需要拆分声学模型、语言模型分开训练,直接从语音波形输出文字,准确率直接拉到95%以上,日常使用跟普通人耳识别的准确率差不了多少。
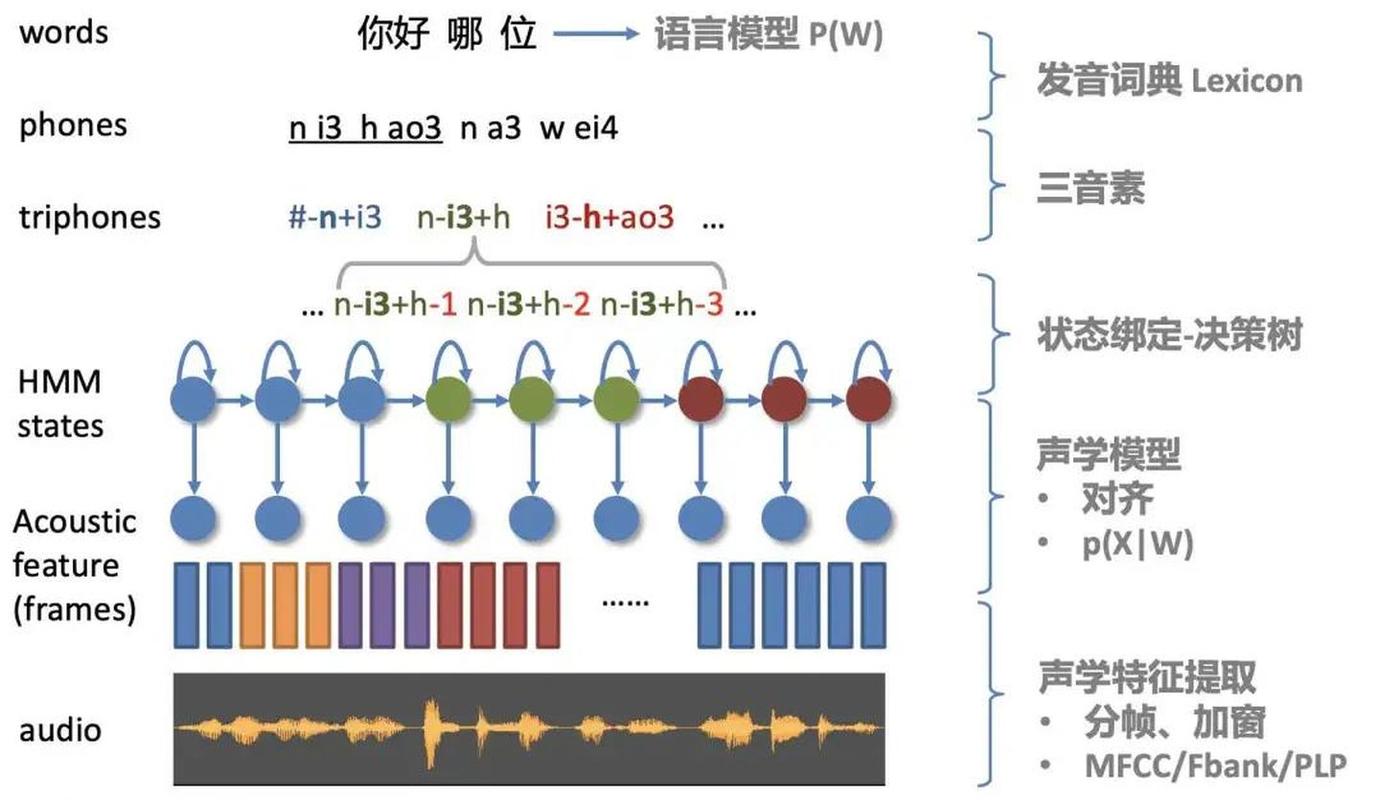 语音识别技术三代模型演进对比图
现在别说标准普通话,你带点川普粤普,甚至说话中途混几个英文单词、网络热词,它都能给你顺对。前阵子我看中科院自动化所公开的最新成果,多方言混合语音识别的准确率已经做到92%以上,比很多本地人听外地口音准多了。
除了打字,语音识别技术偷偷钻进了这些场景
大部分人对语音识别的印象还停留在输入法转文字,实际上这玩意儿早就渗透进各行各业,偷偷帮我们省了不知道多少事。
线下餐饮高峰期,服务员哪有空慢悠悠点屏幕?对着点餐机说一句“三份微辣招牌烤鱼,加两份冰粉少糖”,直接入单扣库存,比手点快三倍还不容易出错。
更厉害的是助听领域。现在很多智能助听设备已经用上了定制化语音识别技术,能过滤掉环境杂音,定向增强你想听的声音,甚至能实时把方言转成普通话播放给听障用户。我之前看过一篇人物采访,有个退休的听障阿姨说,用了这个设备,终于能听懂从外地回来上大学的孙子说的话了,看到那段的时候瞬间戳中我。
 语音识别技术智能助听设备应用场景图
还有我自己天天用的,采访录音转写。之前做专栏采访,两个小时的录音,我得安安静静坐四个小时逐句整理,整理完腰都直不起来。现在直接丢给带语音识别的工具,十分钟转好,我只要改几个专业名词的错字就行,省出来的时间能多写半篇稿子。
不过话说回来,现在也不是完美。上次我去一个行业发布会,台底下全是拍照鼓掌的声音,发言人拿话筒离得远,转出来错了快三分之一,还是挺尴尬的。
接下来,语音识别技术还要啃哪些硬骨头
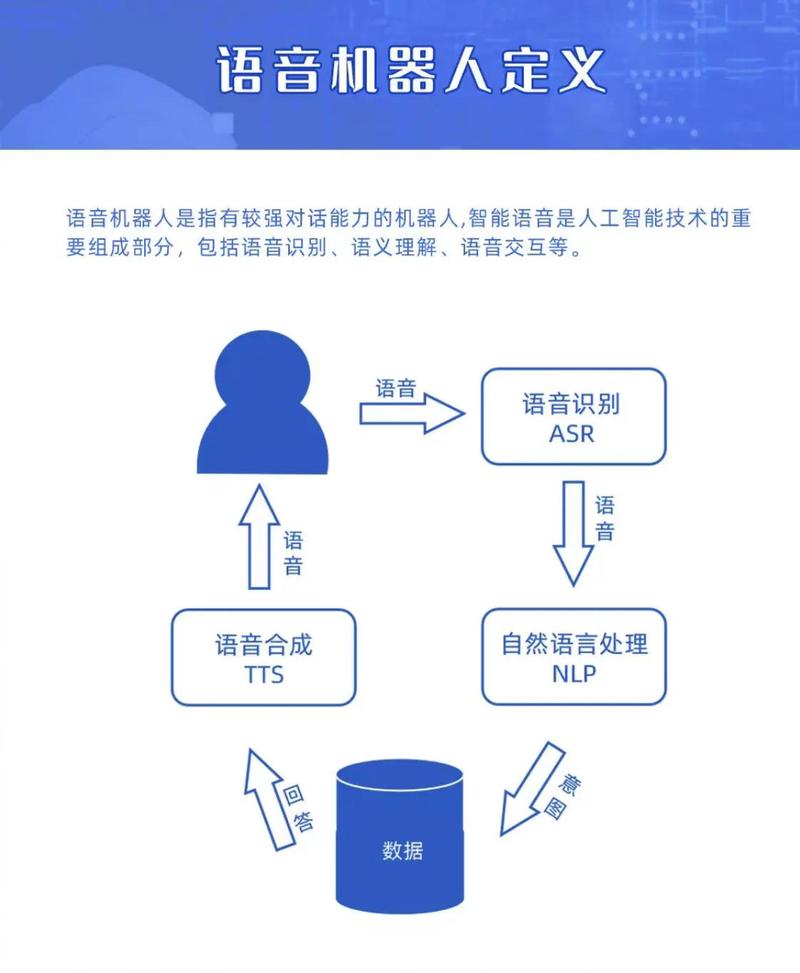 接下来,语音识别技术还要啃哪些硬骨头
现在看起来准确率已经很高了,但要真的做到像人一样随便在哪都能听懂,还差得远。
第一个硬骨头就是复杂场景。远场收音、多人同时说话、背景噪音大,这些场景下现在的模型准确率还是会掉的厉害,刚才说的发布会就是例子。还有专业领域,你说一堆生僻的医学术语、航空航天术语,通用模型直接懵,转出来驴唇不对马嘴,还得一个个定制调优,成本不低。
第二个绕不开的就是隐私。现在大部分语音识别都是云端处理,你说的话要上传到服务商的服务器才能转写,很多人担心隐私泄露,也不是多余的。现在行业里都在推端侧语音识别,所有计算都在你自己的手机、设备本地完成,不用上传数据,既降低了延迟,又解决了隐私问题。现在国内旗舰手机的离线语音唤醒,已经都是端侧做的了,说实话我挺期待全端侧语音识别普及的,毕竟谁也不想自己私下聊天的内容被传到第三方服务器对吧。
还有一个方向就是多模态结合。以后的语音识别肯定不会只转文字,要结合摄像头拍到的场景、你之前说的上下文、甚至你的表情动作,来理解你到底说的是什么。比如你对着手机说“我要这个,要大一号的”,它能结合你正在看商品的画面,直接理解你要的是这件M码的黑色卫衣,不用你再反复说清楚。
你仔细想就会明白,语音识别是AI和人交互的第一道关口。以后不管是智能家居还是虚拟现实,最自然的交互肯定是张嘴说话,不用动手点来点去。现在语音识别技术的每一步进步,其实都是在给下一代交互铺路子。前阵子OpenAI出的实时语音翻译,你说中文,对方那边半秒就能出英文语音,跟面对面聊天几乎没差,这不就是几十年前科幻电影里才有的翻译耳机吗?
我们天天用,很少会想这项技术从实验室出来,已经走了近七十年。从只能认十个数字,到现在揣在口袋里帮我们干各种活,真的踩了无数坑才有今天。以后肯定还会更有意思,对吧。