云计算平台构建:踩过坑才懂的实战干货
我前两年帮一家传统制造企业搭私有云,差点把头发熬光!
很多人说起云计算平台构建,第一反应就是买一堆服务器,装个K8s,接上开源框架就能上线。哪有这么简单?一堆坑都藏在你看不见的地方。
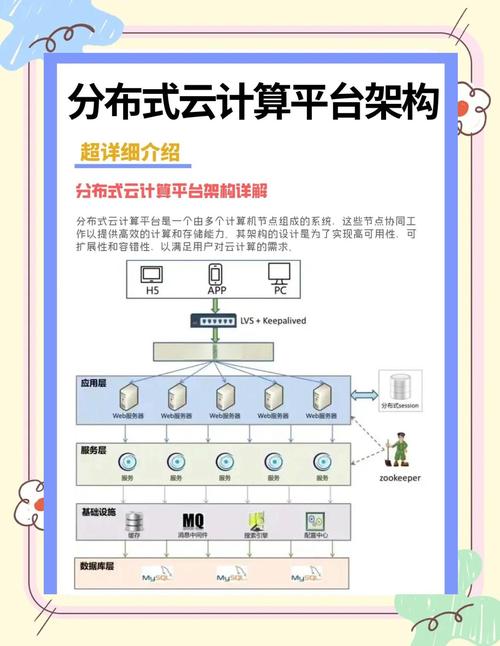 企业私有云计算平台业务分层架构图
云计算平台构建的第一步,从来不是选技术,是定边界。你得先想明白,这个平台到底是给谁用的?做什么用的?
要是只给内部ERP、MES这些核心生产系统用的私有云,就别瞎折腾多租户隔离那一套,我碰过一个客户,为了加这个功能多花了三百万,到现在那功能都没开启过,纯纯给厂商交智商税。
分完用途,再给业务分层:核心交易要低延迟,就得把存储往计算节点旁放,别搞什么远存算分离;非核心的大数据分析、日志存储,再上存算分离,能省一大半存储成本。哦对了,测试环境别和生产环境共用资源池,别嫌浪费,真出问题把生产带崩了,哭都来不及。
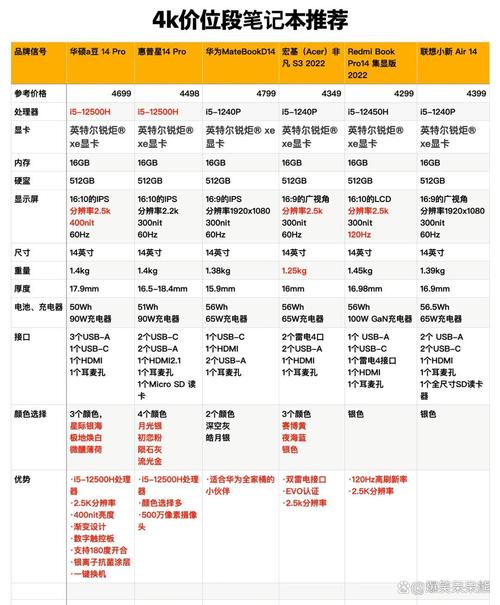 云计算平台三类存储性能对比测试表
核心交易走块存储,冷数据归档走对象存储,研发共享文件走文件存储,这个边界别乱跨。块存储的低延迟是另外两类比不了的,对象存储虽然便宜,随机读写性能差一大截,给核心业务用就是找死。
不过话说回来,现在火得一塌糊涂的存算分离架构,不是谁都适合。你要是整个平台才不到一百个节点,存算分离反而多了一层网络开销,性能不升反降,我见过有人硬赶潮流,结果掉了20%的性能,纯纯瞎折腾。
还有个容易忽略的点:网络虚拟化的损耗。很多人算带宽的时候直接按物理带宽算,根本忘了虚拟化本身会吃掉10%-15%的性能,一到业务高峰直接卡成PPT,这都是我见过的血泪教训。
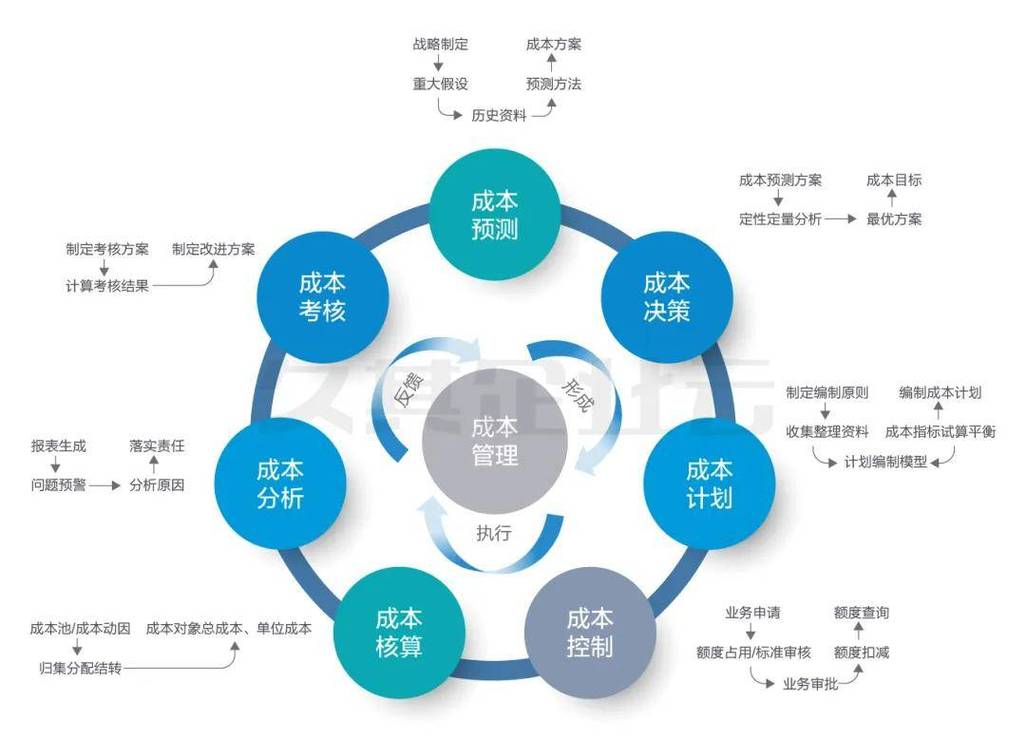 成本控制才是长期能用下去的关键
很多企业算云计算平台构建的成本,只算初期买服务器买软件的钱,根本忘了运营成本才是大头。我接触过一家中型互联网公司,平台上线一年,运维、电费、扩容的钱,已经花了初期采购成本的两倍,离谱吧?
怎么控成本?说几个真有用的,不是那些厂商忽悠的噱头。
第一个就是弹性伸缩别放那当摆设。很多公司的测试环境、办公云,晚上十点到第二天早上六点根本没人用,居然还全量跑着节点,一年下来十几万的电费白扔,只要设置个自动扩缩容,就能省出大半个运维的工资。
第二个,新的技术成果该用就用,别守着老一套。去年中科院计算所发布的硅光互连算力调度成果,我上个月给客户做方案刚用上,同一集群内跨节点的算力调度延迟直接降了40%,多业务混跑的时候,能省至少15%的冗余算力,算下来一年能省几十万。
第三个,冗余设计别过度。很多厂商卖方案,上来就劝你做N+3冗余,说这样更安全,说白了就是多卖设备多赚钱。你得按业务等级来,核心交易做N+2冗余足够,非核心的测试环境、内部工具,N+1就够,甚至有些不影响生产的业务,接受单点故障也没什么,省下来的钱投到业务上不好吗?
现在AI火,很多人问我,搭云计算平台要不要提前预留大模型训练的GPU算力?说实话,你要是没有明确落地的AI业务,别瞎囤卡。现在GPU多贵啊,放那半年不用,折旧都折没了,真要是临时要用,租公有云的弹性算力都比自己囤着便宜。
云计算平台构建这事儿,从来没有放之四海而皆准的最优方案,只有最适合你自己的。别信厂商的全能广告,也别盲目赶技术潮流,摸清楚自己的需求,避开这些前人踩过的坑,比什么都强。
别上来就堆开源组件,先理清楚你的业务底座
去年信通院发布的云计算行业调研报告显示,超过六成新建云计算平台,上线半年内突发故障率超过30%,其中八成问题根源,都是搭建初期没理清楚业务需求,上来就堆技术。 说实话,我见过太多公司踩这个坑。创业公司要做云服务,上来就要对标阿里云搞全栈功能,传统企业转数字化,非要把所有业务都塞进云平台,结果就是功能一大堆,能用的没几个,运维成本翻三倍。企业私有云计算平台业务分层架构图
云计算平台构建的第一步,从来不是选技术,是定边界。你得先想明白,这个平台到底是给谁用的?做什么用的?
要是只给内部ERP、MES这些核心生产系统用的私有云,就别瞎折腾多租户隔离那一套,我碰过一个客户,为了加这个功能多花了三百万,到现在那功能都没开启过,纯纯给厂商交智商税。
分完用途,再给业务分层:核心交易要低延迟,就得把存储往计算节点旁放,别搞什么远存算分离;非核心的大数据分析、日志存储,再上存算分离,能省一大半存储成本。哦对了,测试环境别和生产环境共用资源池,别嫌浪费,真出问题把生产带崩了,哭都来不及。
稳定性这块,没几个新手会注意存储的暗坑
搭平台的时候,所有人都盯着计算节点的算力够不够,出口带宽够不够,十个新手有九个会忽略存储的坑。 我之前那个制造客户,一开始图便宜,给核心MES系统配了普通分布式块存储,一到月底结算,IO延迟直接飙到几百毫秒,生产线停了十分钟,赔了十几万,找厂商维权人家说你自己选的配置,根本不认账。 现在云计算平台的存储分三类:块存储、对象存储、文件存储,很多人图省事随便混用,这就是最大的隐患。云计算平台三类存储性能对比测试表
核心交易走块存储,冷数据归档走对象存储,研发共享文件走文件存储,这个边界别乱跨。块存储的低延迟是另外两类比不了的,对象存储虽然便宜,随机读写性能差一大截,给核心业务用就是找死。
不过话说回来,现在火得一塌糊涂的存算分离架构,不是谁都适合。你要是整个平台才不到一百个节点,存算分离反而多了一层网络开销,性能不升反降,我见过有人硬赶潮流,结果掉了20%的性能,纯纯瞎折腾。
还有个容易忽略的点:网络虚拟化的损耗。很多人算带宽的时候直接按物理带宽算,根本忘了虚拟化本身会吃掉10%-15%的性能,一到业务高峰直接卡成PPT,这都是我见过的血泪教训。
成本控制才是长期能用下去的关键
成本控制才是长期能用下去的关键
很多企业算云计算平台构建的成本,只算初期买服务器买软件的钱,根本忘了运营成本才是大头。我接触过一家中型互联网公司,平台上线一年,运维、电费、扩容的钱,已经花了初期采购成本的两倍,离谱吧?
怎么控成本?说几个真有用的,不是那些厂商忽悠的噱头。
第一个就是弹性伸缩别放那当摆设。很多公司的测试环境、办公云,晚上十点到第二天早上六点根本没人用,居然还全量跑着节点,一年下来十几万的电费白扔,只要设置个自动扩缩容,就能省出大半个运维的工资。
第二个,新的技术成果该用就用,别守着老一套。去年中科院计算所发布的硅光互连算力调度成果,我上个月给客户做方案刚用上,同一集群内跨节点的算力调度延迟直接降了40%,多业务混跑的时候,能省至少15%的冗余算力,算下来一年能省几十万。
第三个,冗余设计别过度。很多厂商卖方案,上来就劝你做N+3冗余,说这样更安全,说白了就是多卖设备多赚钱。你得按业务等级来,核心交易做N+2冗余足够,非核心的测试环境、内部工具,N+1就够,甚至有些不影响生产的业务,接受单点故障也没什么,省下来的钱投到业务上不好吗?
现在AI火,很多人问我,搭云计算平台要不要提前预留大模型训练的GPU算力?说实话,你要是没有明确落地的AI业务,别瞎囤卡。现在GPU多贵啊,放那半年不用,折旧都折没了,真要是临时要用,租公有云的弹性算力都比自己囤着便宜。
云计算平台构建这事儿,从来没有放之四海而皆准的最优方案,只有最适合你自己的。别信厂商的全能广告,也别盲目赶技术潮流,摸清楚自己的需求,避开这些前人踩过的坑,比什么都强。