踩过10个坑之后,我眼里的微服务架构设计
上周跟几个刚创业的朋友吃饭,酒过三巡就开始吐槽。说看了几篇大厂技术博客,脑子一热就把跑了半年的单体拆成了微服务,现在上线每周都出幺蛾子,运维天天在群里骂开发,开发天天抱怨联调等半天。
我听完只能笑,这坑我十年前就踩过。
现在网上的错误导向太严重了,开口就是“越微越好”,搞得很多人觉得不拆个几十个服务都不好意思说自己做微服务。
说实话,我见过最离谱的项目,五个开发,拆了二十一个服务。光服务注册发现的配置,就能占一个后端每天三分之一的工作量。
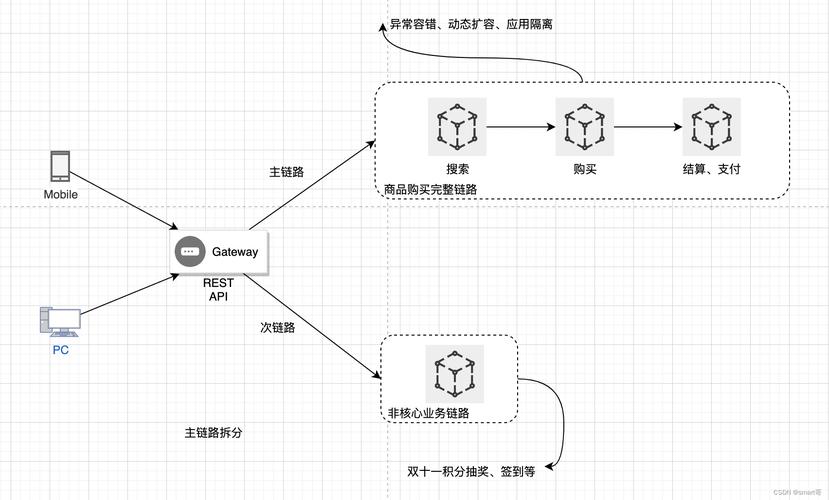 不同业务规模微服务拆分粒度对比图
拆分的核心逻辑永远是业务边界,不是代码行数,更不是技术时尚。
什么叫业务边界?就是你团队里已经按业务线分好组了,做用户的一拨人,做商品的一拨人,做交易的一拨人,那正好按这个边界拆,大家各自改各自的,不会代码冲突,上线不用等别人合代码,这才是微服务的意义。
如果你的团队总共才三四个人,一两个人管全栈业务,拆什么拆?就算你拆了,改一个需求还是要改三四个服务,反而多了部署、联调、依赖兼容一堆破事,纯纯自己找罪受。
举个真实的例子,去年有个做社区团购的初创找我做咨询,他们本来单体扛着日均十万单跑得好好的,就是看对手做了微服务,非要跟风拆,拆完之后直接把研发效率拖慢了一半,光接口兼容问题就出了七八个线上bug,最后还是我帮他们把关联度高的几个服务合并回去,才恢复正常。
刚做微服务的人,十个有九个会在分布式事务这里卡壳。
我刚做微服务那会,为了实现订单减库存的强一致性,翻了无数资料,试了两阶段提交、三阶段提交,还搭了一套分布式锁集群,最后上线压测,qps直接掉了三分之二,根本没法用。
后来还是跟着老架构师学了一招,才想明白。
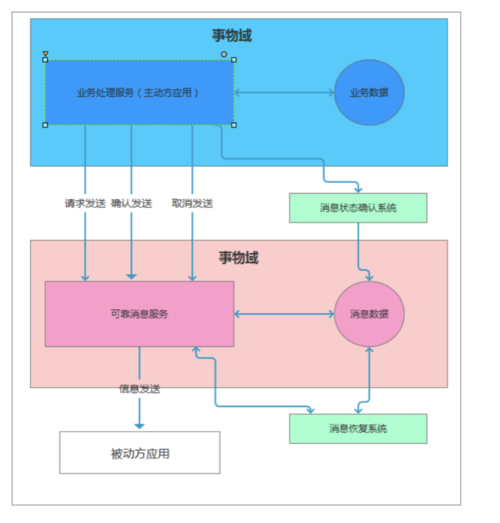 微服务分布式事务最终一致性补偿流程图
大部分业务场景,允许几秒的延迟不一致,只要最终一致就够了。
还是说订单减库存,你先预扣库存,用户15分钟没付款就自动回滚,订单生成成功发个消息给库存服务,异步更新,哪怕消息丢了,加个定时对账的补偿任务不就完了?
出问题的概率有多大?我见过做了五六年的电商,用这套方案,一年也就出个一两回,手动调一下库存就好,比花大功夫做强一致,把全平台性能拖垮划算一万倍。
现在很多新手,上来就追求完美,什么都要强一致,根本不看业务实际需要,说白了就是书本读多了,没碰过真实的线上压力。
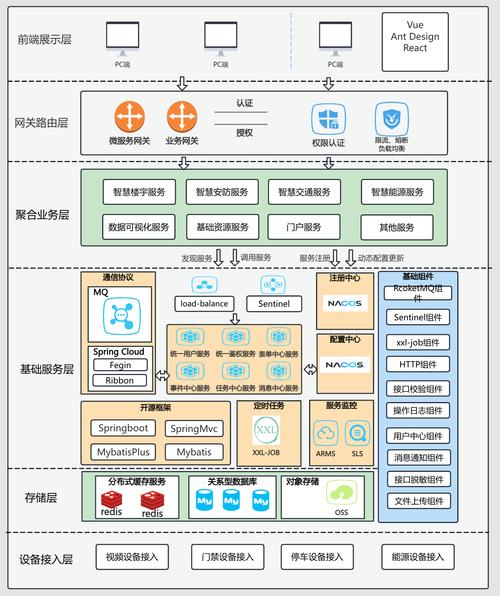 可观测性才是微服务架构设计的核心基建,别等炸线才补
我见过太多团队,拆服务的时候劲头十足,上线前才想起来,哦,出问题了怎么查?
原来单体的时候,日志都在一起,报错了直接搜关键词就能找到问题。拆完微服务,一个请求串七八个服务,每个服务的日志存在不同的机器上,你找谁去?
之前有个朋友跟我吐槽,他们线上出了个下单失败的bug,四个开发查了六个小时,才发现是某个新上线的服务把参数名改了,没通知下游,就是因为没做全链路追踪,也没做统一日志,只能一个服务一个服务登上去翻日志,翻到最后所有人都心态崩了。
微服务上线之前,可观测性的三件套必须先搭好:全链路追踪、统一日志聚合、核心指标监控。缺一个都别上线。
现在云原生生态这么成熟,搭这套东西根本不费劲,用opentelemetry接一下,弄个grafana就能看,花不了两天功夫,能帮你后面省几百个小时的排查时间,怎么算都划算。
不过话说回来,也没必要过度建设,你就七八个服务,没必要动不动就上几十万的商业可观测平台,开源方案完全够用,把钱花在业务上不好吗?
微服务从来不是银弹。它是解决大规模团队、大规模业务痛点的方案,不是用来装逼的技术时尚。
你业务没到那个规模,团队没到那个体量,老老实实把单体写好,把基础功能做稳定,比什么都强。
真等你业务涨了,团队扩了,再一点点拆,一点点迭代架构,完全来得及。
踩过坑的人都懂,适合自己的,才是对的。
我听完只能笑,这坑我十年前就踩过。
别为了“微”而微,拆服务的核心标尺从来不是大小
现在网上的错误导向太严重了,开口就是“越微越好”,搞得很多人觉得不拆个几十个服务都不好意思说自己做微服务。
说实话,我见过最离谱的项目,五个开发,拆了二十一个服务。光服务注册发现的配置,就能占一个后端每天三分之一的工作量。
不同业务规模微服务拆分粒度对比图
拆分的核心逻辑永远是业务边界,不是代码行数,更不是技术时尚。
什么叫业务边界?就是你团队里已经按业务线分好组了,做用户的一拨人,做商品的一拨人,做交易的一拨人,那正好按这个边界拆,大家各自改各自的,不会代码冲突,上线不用等别人合代码,这才是微服务的意义。
如果你的团队总共才三四个人,一两个人管全栈业务,拆什么拆?就算你拆了,改一个需求还是要改三四个服务,反而多了部署、联调、依赖兼容一堆破事,纯纯自己找罪受。
举个真实的例子,去年有个做社区团购的初创找我做咨询,他们本来单体扛着日均十万单跑得好好的,就是看对手做了微服务,非要跟风拆,拆完之后直接把研发效率拖慢了一半,光接口兼容问题就出了七八个线上bug,最后还是我帮他们把关联度高的几个服务合并回去,才恢复正常。
分布式事务是绕不开的坎,但90%的场景不需要强一致性
刚做微服务的人,十个有九个会在分布式事务这里卡壳。
我刚做微服务那会,为了实现订单减库存的强一致性,翻了无数资料,试了两阶段提交、三阶段提交,还搭了一套分布式锁集群,最后上线压测,qps直接掉了三分之二,根本没法用。
后来还是跟着老架构师学了一招,才想明白。
微服务分布式事务最终一致性补偿流程图
大部分业务场景,允许几秒的延迟不一致,只要最终一致就够了。
还是说订单减库存,你先预扣库存,用户15分钟没付款就自动回滚,订单生成成功发个消息给库存服务,异步更新,哪怕消息丢了,加个定时对账的补偿任务不就完了?
出问题的概率有多大?我见过做了五六年的电商,用这套方案,一年也就出个一两回,手动调一下库存就好,比花大功夫做强一致,把全平台性能拖垮划算一万倍。
现在很多新手,上来就追求完美,什么都要强一致,根本不看业务实际需要,说白了就是书本读多了,没碰过真实的线上压力。
可观测性才是微服务架构设计的核心基建,别等炸线才补
可观测性才是微服务架构设计的核心基建,别等炸线才补
我见过太多团队,拆服务的时候劲头十足,上线前才想起来,哦,出问题了怎么查?
原来单体的时候,日志都在一起,报错了直接搜关键词就能找到问题。拆完微服务,一个请求串七八个服务,每个服务的日志存在不同的机器上,你找谁去?
之前有个朋友跟我吐槽,他们线上出了个下单失败的bug,四个开发查了六个小时,才发现是某个新上线的服务把参数名改了,没通知下游,就是因为没做全链路追踪,也没做统一日志,只能一个服务一个服务登上去翻日志,翻到最后所有人都心态崩了。
微服务上线之前,可观测性的三件套必须先搭好:全链路追踪、统一日志聚合、核心指标监控。缺一个都别上线。
现在云原生生态这么成熟,搭这套东西根本不费劲,用opentelemetry接一下,弄个grafana就能看,花不了两天功夫,能帮你后面省几百个小时的排查时间,怎么算都划算。
不过话说回来,也没必要过度建设,你就七八个服务,没必要动不动就上几十万的商业可观测平台,开源方案完全够用,把钱花在业务上不好吗?
微服务从来不是银弹。它是解决大规模团队、大规模业务痛点的方案,不是用来装逼的技术时尚。
你业务没到那个规模,团队没到那个体量,老老实实把单体写好,把基础功能做稳定,比什么都强。
真等你业务涨了,团队扩了,再一点点拆,一点点迭代架构,完全来得及。
踩过坑的人都懂,适合自己的,才是对的。