人工智能产业应用落地:模型不贵,贵的是那堆没人愿意标的图
上个月去江宁一家做精密结构件的厂子。车间里轰隆隆的,线尾架着两台工业相机,旁边坐着一位老师傅,眼睛盯着屏幕上的灰度图找划痕。
我问他,不是说上了AI质检了吗。
他把保温杯往桌上一磕:上了啊。就是老误报,一天得点掉两百多次报警,烦得很。
这句话听着像随口吐槽,其实差不多就是眼下人工智能产业应用挺真实的那一面——网上聊的是参数、算力、发布会,车间里卡住项目的是光照、节拍、标注,和一堆琐碎到不像技术的活儿。
我做过几个视觉质检的落地项目。真正死在“模型精度不够”上的,远少于死在“没人愿意标数据”上的。
 工厂产线机器视觉工业相机缺陷检测现场
模型那一环,其实花不了几个钱
先讲讲这东西怎么跑起来的,尽量说人话。
工业质检用的多半是卷积神经网络,英文缩写CNN。你可以把它想成一摞筛子,图片从上面倒进去,每层筛子滤出一种特征——边缘、纹理、斑点,七八层摞下来,网络就能“看”出这块料上有个不规则的暗斑。它是分类还是检测,取决于任务:判断有没有缺陷,还是要把缺陷框出来、顺带量个尺寸。
关键在于,筛子的参数不是人写死的,是从样本里喂出来的。
这就麻烦了。
教一个老师傅的徒弟,给他二三十个坏件看看,说说这是划伤、这是压痕、这是氧化,差不多就能上手。神经网络不行。它没有常识,只能从数据里统计规律。你要它认得一种划痕,可能得给它几百张甚至上千张同类的坏件照片,还得有人一张一张把缺陷框准。
框准这件事,比听起来难。边缘模糊的算不算?两毫米的算不算?批次之间色差导致的“假缺陷”要不要标成负样本?标注规则扯不清,模型学出来的一定是浆糊。
而且这里有个绕不过去的坑:数据分布漂移。换一批原材料、换一盏灯管、相机镜头上落了点油污,图像的统计特征就变了,昨天还好用的模型今天就开始抽风。不是模型坏了,是它见过的那个世界变了。
那钱到底花在哪了
拆开讲,一个视觉质检项目,成本大概分这么几块。
相机、镜头、光源、工控机、边缘算力盒子,硬件。这部分是明码标价的,好算。
数据采集和标注。这部分不太可控。产线上坏件本来就少,良率高的线,一天可能就出几个次品,攒够训练样本要等好几个月。你等不起,就得人为造缺陷——拿砂纸蹭、拿针划、拿夹具压。造出来的和真的有多像?重在掺和。
然后标注。一个人一天认真框图,撑死几百张,还得有人复核。一张图几分钱到几块钱不等,看缺陷多复杂。听着不多,乘以几万张、乘以几个缺陷类别、再乘以产线数量,就不是小钱了。更何况标错了还得返工。
再往后是工程化的脏活:光照重新设计、相机标定、节拍匹配、模型压缩、边缘部署、跟MES系统对接、报警分级、误报的闭环回收。
顺便说下延迟这件事。产线一秒走过好几个件,推理必须在本地跑,几十毫秒内出结果。把图像传云端推理?网一断,产线就停了。所以边缘侧部署是标配,模型还得做量化、剪枝,砍到能塞进小盒子里跑得动。
你看,这里面有多少是“AI”,又有多少是别的东西。
一个有意思的变化:大模型进来干复判
 一个有意思的变化:大模型进来干复判
这两年多模态大模型起来了,很多人第一反应是“用它替代小模型”。不现实,太慢太贵。
但它在另一个位置上站住了:复判。
思路是分层。规则清晰、样本充足的缺陷,交给小模型在边缘跑,快、稳、便宜。小模型拿不准的那一小撮——大概占百分之几——推到后台,让多模态模型看一眼,结合工艺参数和文本描述,给一个“疑似压痕,建议复检”的判断,甚至能回答老师傅一句“这块为什么判NG”。
对人来说,工作就从“盯着屏幕点掉两百次报警”,变成了“看十几条挑出来的疑难件”。体验完全不一样。
这里我得泼盆冷水。大模型会一本正经地说错话。把它的输出直接接进控制逻辑去剔除产品,风险自负。它适合当顾问,不适合当扳机。
什么时候不该上,这也得说清楚
我见过一些项目,一开始就不该立项。
一种是缺陷定义本身就模糊。什么叫“外观不佳”?老师傅之间都吵不出统一标准,你让机器怎么学。先把标准写成人能执行的规则,再谈AI。
一种是批量太小、换型太频繁。今天做A款明天做B款,每款样本都攒不够,模型刚训热乎就换产品了。这种场景,传统视觉算法加人工可能更划算——不是所有问题都值得动用神经网络。
还有一种,误报的代价被严重低估。方案书上写个“准确率99%”就完事了,可产线上的账不是这么算的。漏检一个致命缺陷,可能赔进去一台车;误报一次,只是让工人多看两眼。两个方向的代价差着好几个数量级,阈值往哪调,是业务问题,不是算法问题。所谓99%,得先问清楚是在什么样本分布下、对哪一类缺陷、按什么代价函数算出来的。
另外,“AI替代质检员”这个说法,我一般不接。现实里跑得好的线,人并没有少,只是岗位换了——从重复目检,变成处理疑难件、维护标注规则、盯着模型衰减。模型不会自己变老,但数据会。不持续喂新样本,半年之后它的表现一定会往下掉。
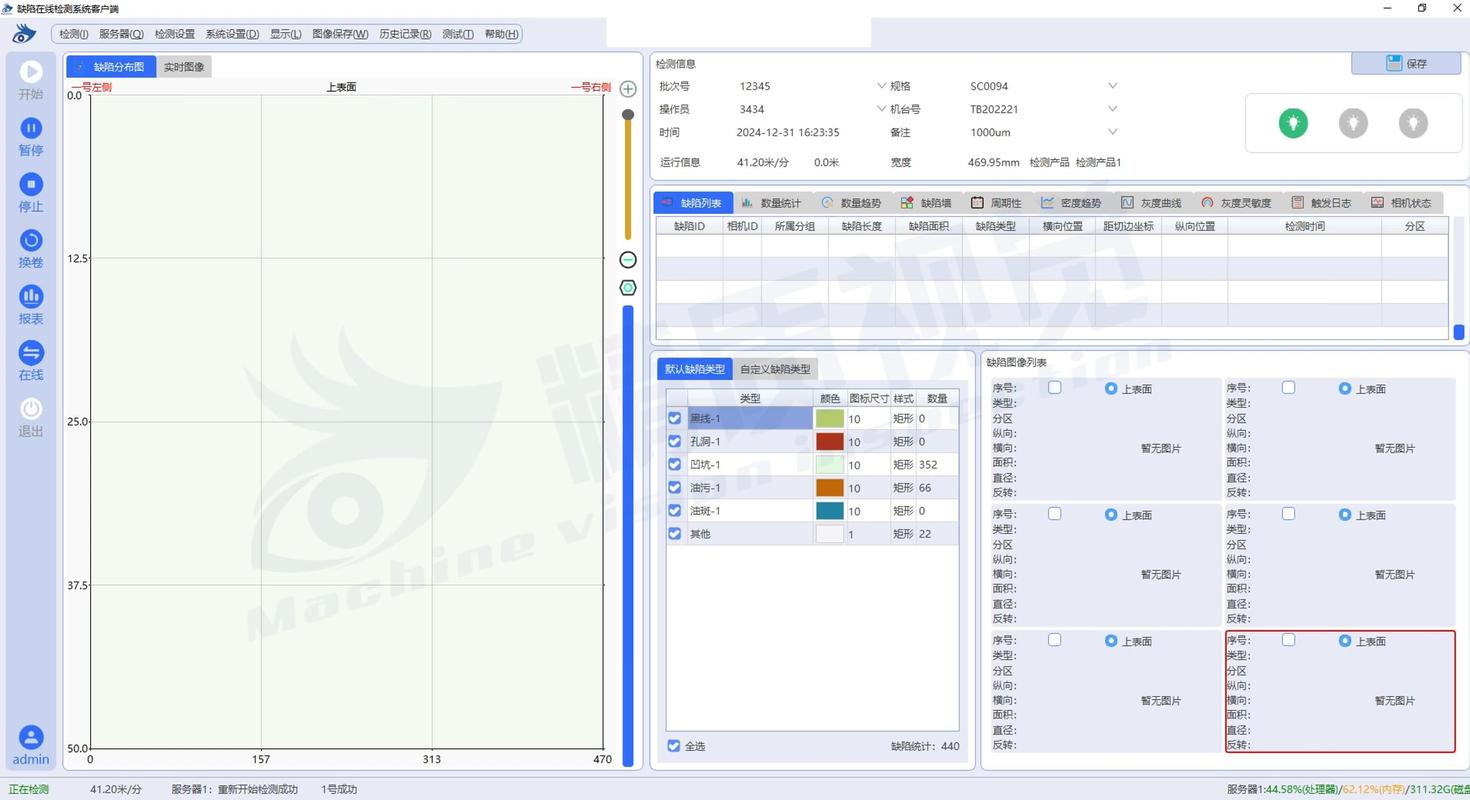 工业质检缺陷样本标注分类软件界面
回到那个车间。老师傅后来调岗了,带两个年轻人做缺陷样本库,顺手把标注规范写成了一本小册子。他跟我说,这活儿比看屏幕累,但眼睛舒服多了。
我觉得这句话,比任何一份技术白皮书都更接近人工智能产业应用的真面目。技术走到车间里,最后拼的往往不是谁的网络更深,而是谁肯把那些不性感的事——标数据、定标准、修灯、跑闭环——一件一件做完。
做不完,模型再漂亮也就是个演示。