容器化部署技术别再当玄学:科研软件复现、GPU调度和镜像供应链的硬核现实
实验室里最常听见的一句话是什么?“这代码在我电脑上能跑。” 然后换台机器,CUDA 版本不对,Python 包冲突,MPI 路径写死。你盯着屏幕,想砸键盘。容器化部署技术就是冲着这种烂摊子来的。不过它也不是什么魔法。用错了,照样一地鸡毛。
先别急着 docker run:科研场景比互联网生产环境野得多
互联网公司搞容器,通常有运维团队、K8s 集群、镜像仓库、CI/CD。实验室呢?一台带四张 4090 的服务器,一个快毕业的博士生,外加一个没人敢动的 conda 环境。差别巨大。
Docker 当然好用。镜像分层让依赖打包变得像搭积木,OCI 标准又把运行时、镜像格式、仓库接口拆开。可到了超算,Docker 的 root 守护进程模型直接撞墙。管理员不给你 root,你怎么办?Apptainer,以前叫 Singularity,成了 HPC 里的常客。它不需要常驻 root 守护进程,还能把镜像做成单个 .sif 文件,拷来拷去。说实话,我第一次在 Slurm 作业里看到 apptainer exec 的时候,差点以为拼错了。
但坑也在这儿。有人把 200GB 数据集直接塞进镜像,推到 registry,整个实验室的网络都哭了。镜像不是数据盘。数据该挂载就挂载,该用对象存储就用对象存储。基础镜像也别贪大,cuda:12.4-devel 这种,开发时爽,部署时臃肿。多阶段构建能救你一命。
 科研高性能计算容器化部署Slurm作业提交场景图
另外一个反直觉的点:容器化部署技术并不等于 Docker。Podman、containerd、CRI-O、Apptainer、Wasm 运行时,都算这个家族。选哪个,看你的调度器、权限模型和安全需求。别拿着一把锤子找所有钉子。
Kubernetes 进了实验室,但和云原生那套不完全是一回事
Kubernetes 现在几乎成了容器编排的事实标准。科研圈也不例外。KubeFlow、Volcano、Kueue、Slurm operator,这些项目把批处理、MPI、Jupyter 工作流往 K8s 上搬。行业动态很明显:2024 到 2026 年,越来越多高校和研究所开始搞内部 GPU 平台,用命名空间做多租户,用 ResourceQuota 限制额度,用 PriorityClass 抢卡。
问题来了。云原生默认假设你的应用是无状态的、可以随时重启的。科研工作负载呢?一跑三天的训练任务,中间挂了想骂人。MPI 作业需要低延迟网络,K8s 的 CNI 插件不一定扛得住。还有 GPU,NVIDIA device plugin 能暴露整卡,但你要共享怎么办?MIG、vGPU、时间片轮转,各有各的麻烦。有人用 NVIDIA MIG 把 A100 切成七份,听起来很美,实际切完显存和算力都缩水,小模型还行,大模型直接跪。
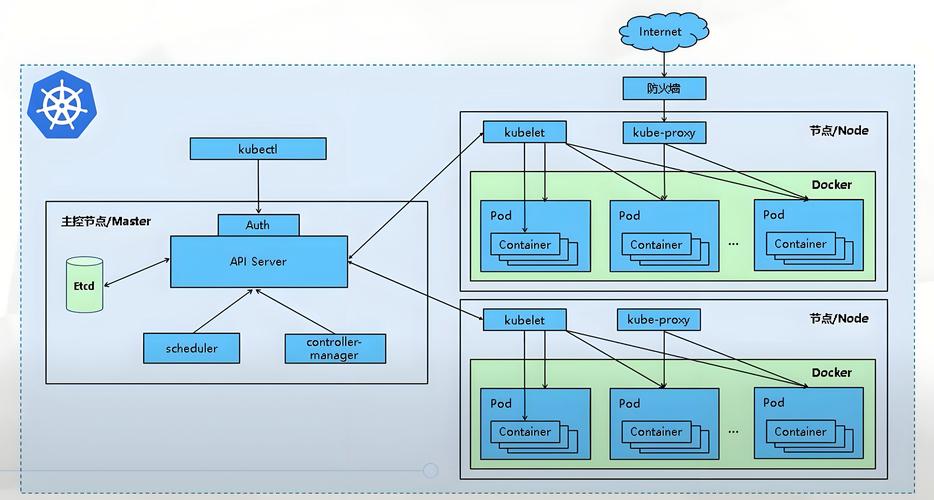 Kubernetes容器化部署GPU调度架构示意图
我的偏见:如果你只是跑几个单机实验,别上 K8s。真的。SSH 加 Slurm 更省心。但如果你有几十号人抢卡,配额、审计、隔离、自助提交,这些需求一出来,K8s 的复杂度反而值了。对吧?工具选择看规模。
还有个趋势值得盯:Kueue 和 Volcano 正在补上批调度的短板。以前 K8s 调度器对 gang scheduling 支持弱,MPI 作业容易死锁。现在不少平台把队列、优先级、抢占做成一层。科研平台工程师终于不用自己写调度器了——虽然他们可能还是得写一堆 YAML。
镜像供应链、复现性与安全:论文评审的新战场
科研最怕什么?结果复现不了。代码放 GitHub,三年后依赖全挂。requirements.txt 里写个 numpy,谁知道是哪个版本。容器镜像能锁定依赖,但前提是你得把镜像摘要写进论文。对,digest,不是 tag。latest 这种标签,今天和明天可能指向两个世界。
现在不少会议和期刊的 artifact evaluation 已经要求提交 Dockerfile 或 Apptainer 定义文件,最好再给个镜像 digest。行业里,Sigstore、cosign、SBOM、SLSA 这些供应链工具开始进入科研视野。听起来离学术很远?一点也不。去年就有人发现某个公共镜像里的 Python 包被投毒,挖矿程序跑了半个月。超算管理员脸都绿了。
 科研成果容器镜像签名SBOM供应链安全流程图
安全隔离也得说清楚。容器共享内核,不是虚拟机。普通 runc 容器逃逸不是新鲜事。要强隔离,Kata Containers、gVisor、机密容器都能上,但性能损耗和运维复杂度跟着涨。科研场景里,如果跑的是不可信代码——比如审稿人给的 artifact——至少用 rootless 容器,开 userns,别直接挂宿主机敏感目录。别问我怎么知道的。
另一个现实:镜像仓库会挂。Docker Hub 限流,公共 registry 说没就没。重要镜像最好在本地 registry 留一份,或者用 ORAS 把镜像推到对象存储。论文附录里除了 GitHub 链接,也留个 tar 包。土,但管用。
别被工具绑架:什么时候不该上容器
 别被工具绑架:什么时候不该上容器
这话可能不讨喜:容器不是万能的。内核模块、特殊硬件驱动、实时系统、RDMA 极致性能调优,这些场景硬塞容器,纯属给自己找事。有些 MPI 应用在裸机上跑就是比容器里快几个百分点,别小看这几个百分点,超算机时按百万核小时算。
还有,容器化部署技术解决的是环境一致性,不是科学问题。别指望打个镜像,代码里的 bug 就自动消失。我见过有人把错误结果怪到容器头上,最后发现是随机种子没固定。哎。
如果团队只有两三个人,Spack 加 conda 加 module 系统可能更轻。真要上容器,从 Apptainer 或 Podman 开始,别一上来就 K8s。先把镜像构建、版本固定、数据挂载这三件事做扎实。等规模上来了,再考虑编排。
最后给个暴论:未来两年,科研软件交付会越来越像软件供应链。论文附带的不只是代码,还有可验证的容器镜像、签名、SBOM 和硬件描述。谁先习惯这套,谁少熬夜。谁还靠“在我电脑上能跑”,谁就继续和 CUDA 版本搏斗。就这样。