智能制造研发的暗礁:仿真报告写得漂亮,为什么车间一跑就崩?
上个月去苏州,一家做汽车转向节的企业。他们刚上了一条柔性加工线,仿真报告我看了,节拍提升32%,OEE算出来能到78%。挺好看的数字。但实际一跑,卡在去毛刺工位。原因?仿真里默认毛刺厚度是0.2mm,实际铸件毛刺最大有1.8mm。机械臂夹爪一抓就抖,抖了就得停机重试。
你说这是仿真技术不行?还真不是。问题出在智能制造研发的一个结构性矛盾:模型越精细,对边界条件的要求就越苛刻,而边界条件恰恰是最难拿准的东西。 这篇文章不聊宏观趋势,就聊几个我在产学研项目里反复踩过的坑。
仿真跑得欢,现场直冒烟——假象从哪来?
干过智能制造研发的人都有这个体会:仿真模型在电脑里跑得顺,一到实物验证就翻车。翻车姿势还千奇百怪。我见过一个案例,焊接变形仿真算得和实测差了四倍。为什么?模型里夹具刚度设成了无穷大,实际那套气动夹具在焊接热影响下会退让0.3毫米。就这零点几毫米,应力的分布全变了。
 智能制造产线仿真模型与实物变形对比场景
说实话,这不是仿真软件的问题。是研发流程的问题。很多团队把仿真当成“验证工具”,而不是“设计工具”。心里想的是:我先把结构定下来,再跑个仿真证明它行。这就倒过来了。仿真的价值在于帮你发现“你没想到的边界条件”,而不是给你一张漂亮的云图去汇报。 但现实里,甲方催进度,乙方要结题,谁有空去抠那些犄角旮旯的边界参数?
还有一个更隐蔽的陷阱:多物理场耦合。热-力耦合、流-固耦合,听着高级。但你只要有一个场的参数不准,误差就会非线性放大。我做过一个电机定子的热仿真,导热系数用的手册值,实测发现硅钢片叠压后的等效导热系数比手册值低了将近40%。为什么?叠片间的接触热阻。手册里不会告诉你,因为那是你的装配工艺决定的。所以仿真模型的可信度不能只看单学科误差,必须结合制造工艺的离散性来评估。 这一点,论文里很少写,但产线上天天发生。
数据不是不够,是馊了
前年帮一家齿轮厂做设备健康管理。他们很自豪地说:我们装了三百多个传感器,数据存了三年。我打开数据库一看,头皮发麻。振动信号采样率设成了100Hz,齿轮啮合频率在2kHz以上,完全混叠。温度数据用的热电偶,响应时间半分钟,测轴承瞬态温升?开玩笑。
更麻烦的是标签。你问产线班长:这个振动异常对应什么故障?他说:“大概轴承吧,反正换了就好。” 换下来拆开一看,有时候是保持架断裂,有时候是润滑不良,有时候是装配偏心。这几种故障在频谱上的特征有重叠,没有细粒度标签,再牛的深度学习模型也只能学个寂寞。
这就牵扯到智能制造研发的一个核心方法问题:数据驱动和机理模型怎么融合。我的观点很明确——先用机理模型筛特征,再用小样本学习补残差。 别一上来就搞端到端。举个例子,滚动轴承故障诊断,包络谱里的BPFO、BPFI这些特征频率是基于几何尺寸算出来的,这就是机理先验。你把这几阶频率对应的幅值作为输入,哪怕只有几十个故障样本,分类器也能收敛。如果直接把原始振动信号塞给CNN,没有几万条标注数据,根本没法看。
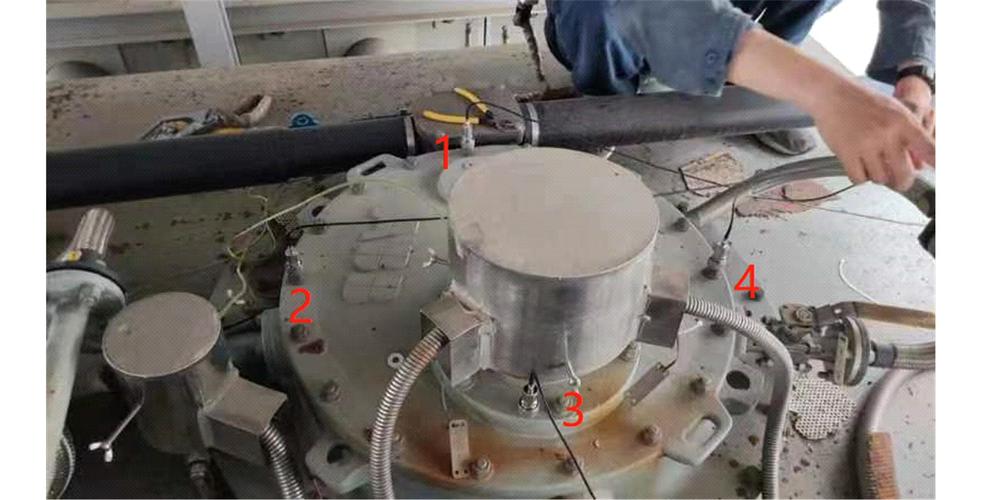 工业现场振动传感器安装与数据采集终端场景
不过话说回来,机理模型也不是万能的。齿轮箱的齿面磨损,磨损量与振动特征之间的映射关系,至今没有精确的解析表达式。这时候数据驱动就派上用场了。但前提是数据得“干净”——时间对齐、工况归一、传感器漂移校正。这三件事做完,数据量可能砍掉一半,但模型泛化能力反而上去了。我管这叫“数据瘦身”,比堆算力管用。
老师傅退休后,系统就变傻
 老师傅退休后,系统就变傻
去年在常州,一个做精密冲压的厂子。他们的模具调试全靠一位老师傅,五十多岁,耳朵听冲床声音就知道间隙大了还是小了。厂里想上智能制造研发项目,把老师傅的经验数字化。怎么做的呢?装了麦克风,录声音,做时频分析。录了三个月,模型准确率百分之九十多。挺好吧?结果老师傅退休第二个月,新模具调试,模型全错。
为什么?因为老师傅调模的时候,会先摸一下导柱的油膜,再敲两下模板听回音。声音信号只是他判断链里的一环,而且不是最关键的那环。你只录了声音,丢掉了触觉、位置、甚至敲击力度的信息。知识沉淀不是录一段数据就完事,你得把人的操作序列和决策条件一起建模。
后来我们换了个思路,用AR眼镜加力传感器,把老师傅的敲击动作分解成“位置-力度-回弹”三元组,再结合模具间隙的实测值,构建了一个简单的工艺知识图谱。图谱里节点是操作意图,边是条件-动作关系。这东西没有神经网络那么炫,但可解释,能审计。老师傅的徒弟推着新模具过来,系统能反问:“导柱油膜状态未检测,建议先补测。” 这才是智能制造研发里知识工程该干的事——把隐性知识变成显式的逻辑规则,再让数据去填充规则里的阈值。
千万别把数字孪生搞成三维动画。我见过一个项目,花了两百万做了个工厂的VR漫游,能看设备颜色变化,能点开看维修记录。甲方领导很满意。但产线换型的时候,这个孪生体连新工装的干涉检查都做不了。说实话,没有物理引擎和实时数据驱动的孪生,就是一张能动的墙纸。
边界在哪里:哪些活该仿真干,哪些别碰
 边界在哪里:哪些活该仿真干,哪些别碰
不是所有研发环节都值得上仿真。我总结了一个粗糙的判据:看参数可辨识性和试错成本。 如果关键物理参数能通过标准实验测出来(比如材料本构、摩擦系数),而且实物试错一次要花几十万(比如大型铸件缩孔、航空叶片变形),那仿真值得投。反过来,一个小钣金件的回弹补偿,仿真跑三天,不如直接上折弯机试三次。三次废料成本不到五百块。
还有个容易忽略的边界:计算资源的时间窗口。研发周期就两个月,你搞个高保真仿真要跑一周,那还不如用降阶模型近似,或者干脆做物理试验设计(DOE)。我见过一个团队,为了把仿真误差从5%降到3%,多花了四个月调网格。结果产品上市晚了一个季度。你说这笔账怎么算?
另外,多物理场耦合的仿真,别轻易上。每增加一个物理场,不确定性至少翻倍。热-流-固三场耦合?除非你的边界条件都有实测数据支撑,否则结果连定性参考都勉强。我的建议是:先做单场验证,确认边界条件准确了,再逐步加场。 这叫“渐进式保真”,比一上来就搞全耦合靠谱得多。
最后说一个反例。某家电企业做冰箱门体发泡仿真,模型很漂亮,但忽略了发泡模具的排气孔堵塞。实际生产中,排气孔每生产两百件就要清理一次,否则局部密度不均。仿真里永远默认模具是理想的。这个模型能指导设计吗?能。能指导工艺吗?不能。所以智能制造研发里,工艺仿真和设计仿真要分开建模型,不能指望一个模型通吃。 谁要是跟你说“一个数字孪生搞定全流程”,你让他先产线上连跑三个月不出偏差再说。
下次立项评审,你试着问一句:“这个模型的不确定度怎么量化?给我看敏感度分析。” 答不上来的,先回去把边界条件测准了再来。真的,别急着写研发报告。