生态效率提升别只看指数:钢厂余热、园区桑基图和0.1的差距
先别急着看排名,生态效率提升的坑多在边界
先抛一个数字。0.83。某流程工业园区的生态效率指数,三年爬了11%。别急着鼓掌——这11%里,有一半来自余热回收,另一半来自统计边界调整。你说气不气?我上周翻一份园区报告,看到一行小字,差点把咖啡喷出来:边界从“企业厂界”改成了“园区合并口径”,指标立刻好看不少。
生态效率提升,说白了,就是单位环境压力换来的经济产出更多。常见测法有DEA、SFA,也有LCA加物质流分析。模型不神秘,真正难的是数据。企业级、工序级、设备级,颗粒度差一层,结论能差出十万八千里。有些报告把生态效率写成PR稿,数据一抹,边界一改,指标漂亮得像滤镜。对吧?
 钢铁企业余热回收梯级利用系统流程图实拍
我不是反对做指数。指数有用。可你得能复算。拿钢铁行业举例,高炉煤气放散率、转炉煤气回收量、烧结余热回收率,这些工序级数据才是硬骨头。公开文献里常能看到:用超效率SBM-DEA测一批钢铁企业,纯技术效率并不难看,规模效率却经常拖后腿。翻译成人话——单台设备挺能打,系统协同拉胯。余热这儿收一点,那儿放一点,最后综合能耗还是下不来。
所以别一上来就追新模型。先把物料平衡和能量平衡做平。真的。一个园区的蒸汽管网,跑冒滴漏查清楚,比在PPT里加十个算法模块更管用。
科研成果里最值钱的,是“可追溯”三个字
最近几年,生态效率提升的科研成果有个明显转向:从“算一个漂亮数”转向“把账做细”。生命周期评价LCA、物质流分析MFA、投入产出表,开始跟企业DCS数据、电表、流量计对接。说实话,这活儿很土。蹲现场、对台账、追批次。但没有工序级数据,生态效率提升就容易变成口径游戏。
有个做化工园区的团队,把蒸汽、氢气、废渣的流向画成桑基图,一画出来,问题藏不住了:某条低压蒸汽管线常年有12%的损耗,企业自己都没注意。改完保温、调了调度,生态效率指数没吹牛,真的往上走了0.1。0.1听着小?放到园区全年产值里,不小。
 工业园区物质流分析桑基图科研案例
不过话说回来,桑基图不是画着好看。它得能回答三个问题:物料从哪来、去哪了、损失在哪个环节。答不上来,图再漂亮也是装饰画。科研成果的价值,也在这儿——把“感觉浪费”变成“可计量、可追溯、可验证的损失”。
还有个细节,很多人忽略:异质性。企业规模、设备年龄、原料品位不一样,拿同一套前沿面去套,结论会偏。SFA能处理一部分随机误差,DEA对异常值又敏感。我的建议很土:多跑几组敏感性分析,别只报一个均值。均值会骗人。真的。
行业动态很热,但数字孪生不是万能药
看行业动态,CBAM、产品碳足迹、碳排放双控,全在倒逼企业做细账。欧盟那边要的是产品级碳足迹,范围三还得往上追。你厂界内算得再漂亮,上游矿石、外购电力、运输环节一摊开,生态效率提升的含金量立刻见真章。
数字孪生这两年火得不行。大屏一挂,三维模型一转,领导点头。可没有实时物料平衡和能量平衡,数字孪生就是个贵一点的监控摄像头。我见过一个做得不错的案例:把余热锅炉、汽轮机、换热站的数据打通,做滚动优化调度。AI不直接改设定值,只给操作员推建议。为什么?安全边界不能丢。人得在回路里。这就有意思了——算法负责找工况,人负责兜底。
 化工园区生态效率数字孪生大屏界面
AI优化燃烧也一样。别指望一上模型就降碳。先看仪表准不准、阀门灵不灵、数据延迟大不大。现场基础没打好,模型学到的全是噪声。嗯,这话不好听,但省真金白银。
别只盯工厂,园区和农业也是生态效率提升的战场
 别只盯工厂,园区和农业也是生态效率提升的战场
工业共生是老话题,可老话题常做常新。钢厂余热给周边社区供暖,化工厂副产氢给园区交通,废渣做建材。单个企业看,可能不划算;园区合并口径看,能量梯级利用和物质循环能把系统性损失吃回来。关键是利益分配。蒸汽谁买单、管网谁维护、停供风险谁承担。技术方案不难,难的是合同和调度规则。
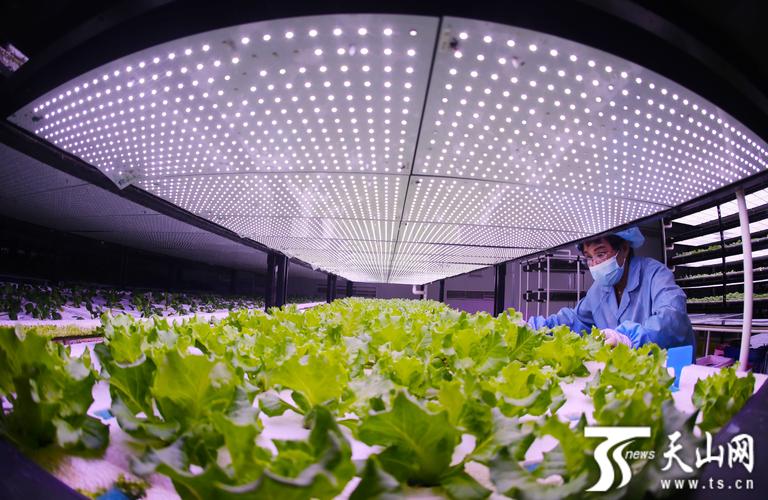
农业这边,生态效率提升的空间也不小。遥感加地面传感器,能把氮肥利用率、灌溉水利用效率算到地块级。科研成果里,用DEA测农业生态效率的论文一抓一把,但真正能落到合作社的,得把复杂模型翻译成“少施一次肥、多收几十斤”的账。不然没人听。对吧?
我最后的看法很直接:生态效率提升不是一张奖状,是一套能复算的账。边界写清楚,数据留痕迹,损失找得到,改进能验证。少一点口径魔法,多一点现场蹲点。那些0.1的提升,往往就藏在蒸汽管线的保温层里,藏在流量计的校准记录里,藏在一张没人愿意画的桑基图里。