泵开始哼歌的那天,预测性维护算法在算什么
凌晨两点,电话响。中控说P-204泵振动高高报。我披上外套往现场走,脑子里先冒出来的不是轴承,是那套预测性维护算法——又狼来了?到了泵边,手搭在轴承座上,能感到一阵细密的“嗡”,不是平时那种沉稳的哼。拆开,保持架裂了。挺悬。可回头一想,这算法除了喊“振动高”,还干了啥?说实话,不够。
报警响的时候,算法其实什么都没说
 报警响的时候,算法其实什么都没说
很多现场把“预测性维护”做成了高级阈值报警。振动超过4.5 mm/s,弹窗。温度过80℃,弹窗。这有用,但这是保护,不是预测。保护关心“现在危不危险”,预测关心“还能撑多久、什么时候安排停机”。两码事。
预测性维护算法要回答的核心问题很具体:这台泵的轴承,未来一周到一个月内,失效概率怎么变?剩余寿命大概落在哪个区间?注意,是区间,不是点。谁要敢给你一个精确到小时的点估计,你反而要警惕。工业现场不是实验室,工况、负载、润滑、对中都在变,算法给点估计等于耍流氓。
我常用一个比喻:阈值报警像汽车仪表盘上的油灯,亮了你知道该找加油站;预测性维护像导航预估“剩余续航还能跑多少公里,前方服务区多远”。油灯不会告诉你还能跑几十公里,导航会,但导航也会受堵车、驾驶习惯影响。预测性维护算法就是那个导航,只不过它看的是振动、温度、电流这些“路况”。
从振动信号到健康指标,中间隔着好几道手
拿旋转机械的轴承说。测点选在哪,比模型选什么更要紧。轴承座刚性、传感器磁吸还是螺纹、方向是径向还是轴向,都会改变信号。我见过把传感器吸在薄板罩壳上的,数据看着挺热闹,全是罩壳共鸣。那套算法再花哨也白搭。
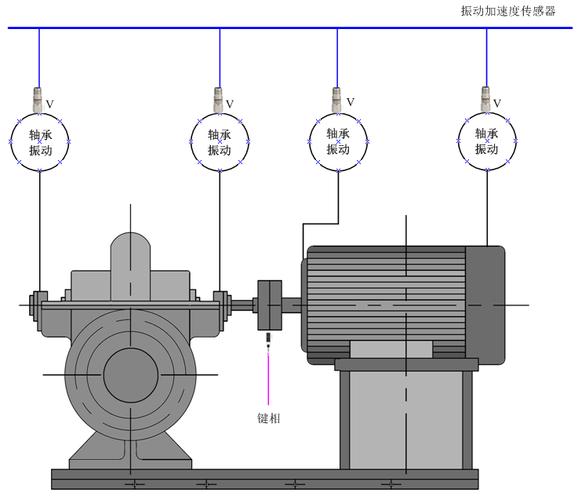 工业泵轴承振动加速度传感器测点布置示意图
信号进来,先采样。采样率不够,高频冲击直接混叠,后面全错。然后做FFT看频谱,但轴承早期故障的冲击很弱,淹没在齿轮啮合、叶轮通过频率里。这时候常用包络解调:把高频共振带里的冲击“包”出来,再看低频重复节奏。轴承外圈、内圈、滚动体、保持架各有特征频率,BPFO、BPFI、BSF、FTF。名字吓人,其实就是不同部件转一圈产生的重复冲击节奏。包络谱上出现这些频率及其谐波,才敢说“轴承可能有伤”。
 滚动轴承故障特征频率包络谱分析示意图
但特征频率不是万能钥匙。变转速下,频率跟着转,你得做阶次分析,把角度域采样的信号转成阶次谱,不然转速一波动,谱线糊成一团。负载变化也会让冲击幅值变。所以健康指标不能只挑一个RMS——均方根值,反映整体能量。RMS对早期微弱冲击不敏感,峭度对冲击敏感但容易被偶发噪声带偏。工程上常用组合:RMS看趋势,峭度看突变,包络谱特征频率幅值看故障类型。别指望一个指标打天下。
这里有个坑:健康指标要能“单调退化”。理想情况下,轴承从正常到失效,指标应该像下坡路,偶尔抖一下可以,不能今天高明天低像心电图。实际数据里,润滑、负载、维修动作都会让指标回弹。所以做RUL之前,先看健康指标曲线有没有可解释的退化趋势。没有趋势,硬上深度学习,等于让模型背噪声。
剩余寿命预测真正的麻烦,是数据在骗你
很多团队一上来就LSTM、TCN、Transformer。模型没错,错在数据划分。时序数据随机打乱做训练测试,等于用未来的数据预测过去,指标漂亮得离谱。正确做法是按时间切:用前80%时间训练,后20%验证;或者按设备切,不同泵做跨设备验证。更隐蔽的是归一化泄漏——你用全量数据算均值和方差,测试集的信息已经漏进训练。工业数据里这种泄漏太常见,尤其是设备少、样本少的时候,大家容易手滑。
还有标签。RUL标签从哪来?从维修记录倒推。可维修记录本身受报警策略影响:阈值设得低,修得勤,记录里“故障”就多;阈值设得高,拖到坏了才修,标签又变成突发失效。算法学到的可能是“维修班的习惯”,不是“轴承的退化”。这点很要命。我见过一个项目,模型在离线测试集上RUL误差很小,上线后提前量忽长忽短。查了半天,训练集里混进了维修后重新磨合的数据,模型把“刚修完”当成了“快坏了”。
退化建模有两条路。一条是基于物理或统计的退化模型,比如指数退化、线性退化、Wiener过程、伽马过程。好处是可解释,能给置信区间,小样本也能跑。另一条是数据驱动,直接学传感器序列到RUL的映射。数据充足、工况单一时,数据驱动有优势;工况多变、失效样本少时,统计模型更稳。别迷信“端到端”,端到端把特征工程藏进网络里,出了问题你连查都没法查。
阈值怎么定?固定阈值省事,但设备工况一变就误报。自适应阈值按工况分箱,比如按转速、负载、温度分段,每段算健康指标的基线。更细一点,用退化模型的失效阈值反推报警线:假设失效阈值是健康指标的某个分位数,结合退化速率,算“预计多少天后越过失效线”。这样报警带时间含义,不是干巴巴一个数。
它算的是时间窗,不是命运
横向看,振动不是唯一信号。电机电流签名分析能看转子断条、气隙偏心;温度能看润滑和冷却;油液磨粒能看磨损模式。多源融合听着高级,落地时先解决“时间对齐”和“采样频率不一致”。振动是kHz级,温度是分钟级,油液是周级。融合不是把特征拼一起扔进模型,而是先想清楚每个信号对应什么退化机理。否则融合等于加噪声。
预测性维护算法的边界也很清楚。变转速变负载的工程机械、缺少失效样本的新设备、传感器装得勉强的老设备,RUL预测的置信区间会宽得没法用。这时候退一步做异常检测和退化趋势预警,比硬报RUL更诚实。还有维修干预:你换了润滑脂,退化轨迹就拐弯了,模型得能识别“维护事件”,不然会把维护后的回弹当成故障前兆。这个在数据里往往没有标记,得靠工单时间、电流启停、振动突变去推断。
风险呢?过度信任算法会过修,备件和停机成本上去;完全不信任又回到定期维修,该坏还是坏。我的经验是,算法输出必须带“可行动信息”:不是“轴承RUL=13.7天”,而是“未来两周内失效概率上升,建议在下个计划停机窗口检查润滑和振动包络”。人做决策,算法给依据。现场老师傅看一眼油窗、听一耳朵,可能比模型更早发现异常。算法别想着替代他们,先把数据管道做干净、测点选对、阈值有人复核,就已经赢了一大半。
说到底,预测性维护算法不是算命。它算的是一个时间窗,一个概率,一个让维修排班从“坏了再修”挪到“按计划修”的提前量。泵开始哼歌的那天,算法别只会喊“振动高”。它得说:还有多少天,为什么,以及下一步干什么。