边缘计算卸载的边界条件:把任务推近一点为何仍可能更慢
先把一个常见误判摆出来:卸载决策常被写成时延与能耗的加权和,仿佛权重一调,答案自然出现。实际系统里,权重背后是业务契约、链路抖动和运维习惯。一个视频分析任务在本地多跑八十毫秒也许能忍,产线质检多八十毫秒就要命。于是卸载不是单纯的技术动作,而是边界谈判。
我见过不少方案在论文里跑得很顺,落到现场却卡在一条上行链路上。怪谁?怪把无线接入当成理想管道。边缘节点离得近,不等于任务到得了。接入时延、排队时延、回传时延、容器冷启动、跨节点迁移,每一项都要进账本。
 边缘计算卸载无线接入链路时延分解示意图
延迟账本不是一张表
 延迟账本不是一张表
端到端时延可拆成采集、预处理、上行传输、边缘排队、计算、结果回传、执行器响应。问题在于这些项不独立。上行重传会推高排队,排队又改变超时触发,超时触发重传。一个闭环。把平均值填进表里,看似清楚,尾部时延却常被藏掉。工业控制、车路协同、远程操控关心的恰恰是尾部。卸载策略若只优化均值,等于把风险留给业务侧。
能耗也一样。把计算推给边缘,手机省电,机房电表转得快。若边缘节点由市电供电,能耗账未必改善;若靠电池或绿电波动,账本又变。碳排放转移更隐蔽。说卸载一定省能,不成立。它有条件:终端电池受限、边缘供电稳定、任务计算密集且数据量相对小。否则,传输能耗和冷却开销会吃掉收益。
还有一个常被忽略的项:决策开销。任务粒度细,卸载决策本身就要采样、预测、通信、协商。调度器每秒做几千次判断,开销可能超过算力节省。小任务尤其如此。几毫秒的本地计算,硬要封装、加密、上传、排队、再解密,听着就累。
部分卸载的麻烦在耦合
二值卸载容易讲:本地跑或边缘跑。真实任务常是链式或图状。视频分析先解码,再检测,再跟踪,再编码。哪一段切走?切点选错,前后数据传输把收益抵消。DAG 调度里,节点权重、边带宽、依赖关系一起变。边缘节点资源一抖,关键路径就换。
部分卸载还要处理状态。模型参数、缓存、会话上下文,不是每次都能轻装迁移。容器冷启动几百毫秒到数秒,函数计算更明显。对短任务,冷启动就是灾难。预热能缓解,但预热占资源。资源碎片化随之而来:每个边缘节点都留一点余量,整体利用率却上不去。
 MEC服务器容器冷启动与任务迁移场景图
我倾向于先把任务画像做粗,不要把卸载器写成万能裁判。计算密集、数据量小、时延容忍度中等的任务,卸载收益相对稳。上行数据大、依赖本地传感器闭环、隐私边界硬的任务,留在端侧更合理。中间地带才需要细粒度决策。卸载的收益来自匹配,不来自把任务一律推远。
测试床会揭短
 测试床会揭短
仿真里链路是分布,现场链路是事件。突发干扰、切换、遮挡、基站负载,都会让上行带宽掉下去。测试床要记录时间戳对齐、队列深度、容器启动、失败重试。否则,论文里的卸载增益很容易来自参数假设。
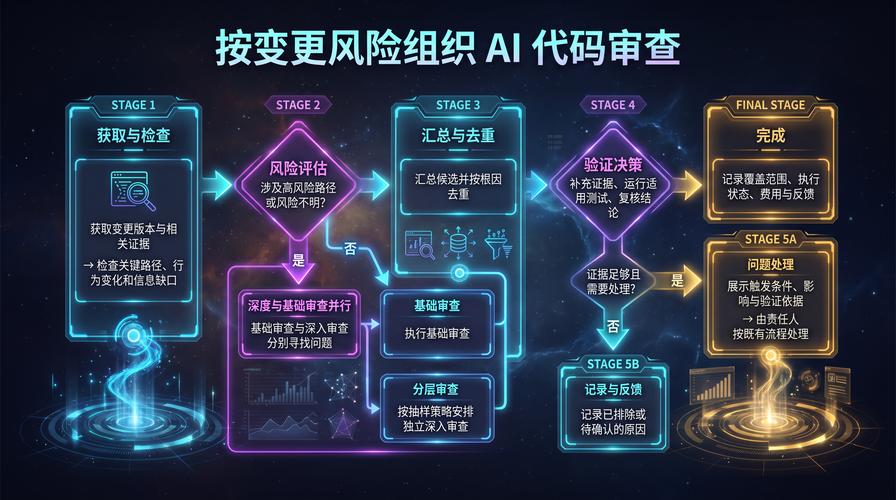
验证时我会盯三件事:尾部时延有没有下降,能耗口径是否一致,失败后的回退是否可用。回退不是补丁,是设计的一部分。边缘节点失联,任务能不能在本地降级跑?降级后精度掉多少?业务是否接受?这些问题不写进实验,部署时就会变成事故。
学习型卸载策略也要小心。强化学习在仿真里能学出漂亮策略,换到现场,状态空间变了,奖励函数偏了,策略漂移。在线学习还要探索,探索意味着试错。生产系统不一定给试错预算。于是常见做法是规则兜底、学习调参、离线评估加灰度。听着不优雅,但能活。
边界与风险
 边界与风险
车路协同、工业 AR、视频巡检是典型场景,但边界不同。车路协同对移动性和切换极敏感,边缘节点要跟着车走。工业 AR 对上行带宽和抖动敏感,Wi-Fi 覆盖不好时,卸载收益很快消失。视频巡检可容忍秒级延迟,却对存储和隐私敏感。同一套卸载框架,换场景就要换约束。
风险还包括供应商锁定和运维复杂度。边缘节点分散,镜像管理、版本回滚、监控告警都要人。省下的终端算力,可能变成边缘运维账单。隐私合规也绕不开:数据出端,哪怕只到基站侧,也要看行业规则。技术可行不等于合规可行。
趋势上,端侧算力在涨,很多轻量模型本地跑得动,卸载边界会往回收。无服务器边缘和算网融合会把调度粒度做细,但冷启动和资源隔离仍是硬骨头。语义通信、模型分割可能改变传输账本,不过现在谈普适结论还早。
所以,边缘计算卸载的关键不在“卸不卸”,而在“哪一段、在什么条件下、失败后怎么办”。把这三个问题答清楚,比再调一个权重系数有用。别急着把任务推走。先看账本,再看回退。这个顺序反了,系统就会用尾部时延教你做人。