代码大模型狂飙背后:我试了三个真实项目,有些话不吐不快
前两天跟一个做后端的朋友吃饭,他吐槽说公司刚上了个代码大模型,结果生成的SQL全是坑。我笑了——这玩意儿我去年就试过,当时它给我补全了一个死循环。真的。我盯着屏幕愣了五秒。不过嘛,最近还真有点不一样了。你懂的,就是那种“虽然还是笨,但笨得有点可爱”的感觉。
代码大模型,跟普通大模型差在哪?
很多人以为代码大模型就是拿GPT在GitHub上微调一下。差远了。代码大模型从预训练阶段就开始“偏科”——语料里代码占比极高,而且训练目标专门针对代码结构优化。比如FIM(Fill-in-the-Middle)训练,让模型学会在代码中间填空,而不是只会从左到右续写。这玩意儿对IDE补全太关键了。你写个函数头,它得知道中间该填什么,还得跟后面的逻辑接上。普通大模型?它可能给你写一段散文。
现在主流的代码大模型,像Code Llama、StarCoder2、DeepSeek-Coder、Qwen2.5-Coder,都在仓库级上下文上较劲。什么叫仓库级?就是模型不光看你当前这个文件,还能跨文件理解依赖关系。说实话,这个能力听着很美,实际用起来……嗯,只能说还在路上。我试过让某个开源代码大模型帮我改一个跨三个文件的bug,它倒是挺自信,直接给我生成了一个不存在的工具类。编译报错那一刻,我差点把键盘吃了。
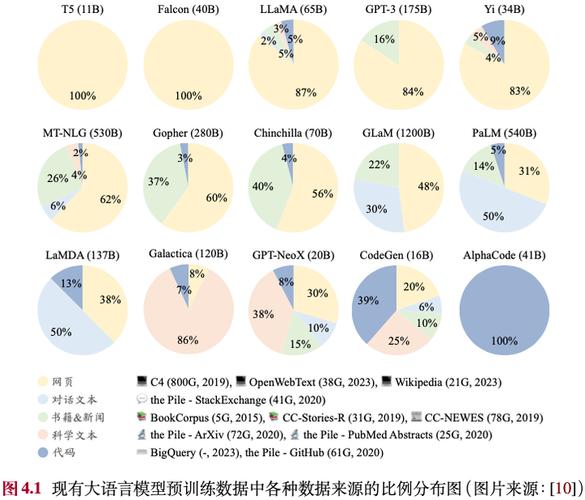 代码大模型预训练代码语料占比饼状图
不过话说回来,技术演进确实快。2024年开源代码大模型井喷,DeepSeek-Coder-V2直接干到236B参数,支持338种编程语言。Qwen2.5-Coder在HumanEval上刷到90%以上。数字很漂亮。但你别急着鼓掌——HumanEval那题量,我大学作业都比它复杂。
训练数据:GitHub不是万能药
代码大模型的命门在数据。GitHub上代码多吧?多。脏吧?也脏。重复代码、自动生成的代码、许可证不明的代码、甚至带漏洞的代码,全混在一起。你直接拿来训练,模型学到的可能就是“如何优雅地写出一个SQL注入”。所以数据清洗是门大学问。去重、过滤低质量、剔除测试文件、做许可证合规——每一步都烧钱烧算力。
更麻烦的是数据污染。有些代码大模型在HumanEval上分数高得离谱,结果一查,训练集里混进了测试题。这不就是开卷考试吗?学术界已经盯上这个问题了。2024年有篇论文专门扒了多个代码大模型的训练数据,发现不少模型的“高分”水分不小。讲真,这行当里刷榜的风气,跟当年深度学习图像分类有一拼。
 代码大模型GitHub代码仓库数据清洗流程图
还有个坑:代码大模型对“新鲜”API的理解往往滞后。你让它写个用最新版本LangChain的代码,它可能给你返回一个两年前已经废弃的接口。为啥?训练数据截止了呗。RAG(检索增强生成)能缓解,但工程上又引入了检索质量、上下文长度一堆新问题。反正就是按下葫芦浮起瓢。
落地:补全、对话、Agent,谁在买单?
我观察下来,目前真正让企业愿意掏钱的场景就三个:IDE智能补全、代码问答、单元测试生成。补全最成熟,Copilot、通义灵码、CodeGeeX都在用。你敲几个字母,它给你补一整段——准确率嘛,看运气。我统计过自己过去一个月的使用记录,补全接受率大概六成,其中能直接跑通的大概四成。剩下两成?改改也能用。这个体验已经比两年前强太多了。
代码问答场景主要解决“祖传代码看不懂”的问题。你把一个函数扔进去问“这段在干嘛”,模型能给你掰扯出个大概。但注意——它经常一本正经地胡扯。比如把递归说成循环,把异步说成同步。所以我现在养成了习惯:它说的每一句,我都得对照源码再确认一遍。心累。
Agent方向最热闹。SWE-bench基准就是让模型自动修GitHub上的真实issue,2024年好几个模型宣称解决了20%以上的问题。听着挺震撼对吧?但你仔细看,那些issue大多边界清晰、复现步骤明确。真实企业里的bug?往往牵扯十几个服务、一堆历史包袱。模型一进去就迷路。不过话说回来,Agent在自动化写单测、补注释、做简单重构上确实能省时间。我最近用某个代码大模型Agent批量给旧项目补类型注解,虽然它偶尔会加错,但总体效率提升了大概三倍。真香。
 代码大模型在IDE中生成单元测试的界面截图
短板:幻觉、长上下文、评估,一个都跑不掉
代码大模型的幻觉跟聊天模型不一样——它不编事实,它编API。你让它调用一个库函数,它给你拼出一个压根不存在的参数名。或者更绝:它把Python的list方法安到Java的ArrayList上。你编译报错,它一脸无辜。我试过让某个模型写一段Kafka消费者代码,它给我返回了一个“KafkaConsumer.poll(Duration)”——这个签名在某个旧版本里确实存在,但新版本早改了。模型不知道。它只是把训练数据里最常出现的写法吐了出来。
长上下文也是老大难。现在动辄128K、200K上下文,理论上能塞进整个仓库。但实际测试下来,模型对长上下文的利用率并不高。你给它一个五千行的文件,它可能只盯着最后几百行看。中间那些关键依赖?忽略。所以业界在搞各种稀疏注意力、检索增强,但离“真懂整个项目”还差得远。
评估更是个泥潭。HumanEval、MBPP这些基准已经被刷烂了。SWE-bench虽然更真实,但测试用例本身也有局限。有研究者发现,代码大模型对变量名扰动极其敏感——你把函数名从“calculateSum”改成“calc_sum”,准确率能掉十几个点。这说明模型根本没理解语义,只是记住了模式。唉。
程序员会失业吗?我的答案有点扫兴
每次代码大模型发新版,朋友圈就一轮“程序员要完”。我劝你先别慌。高级语言出现的时候,汇编程序员也这么想过。结果呢?程序员数量反而暴增。代码大模型是个杠杆——它把重复性编码的门槛踩平了,但需求拆解、架构权衡、复杂系统调试这些活儿,它暂时还接不住。你让它写个CRUD,它唰唰给你生成。你让它设计一个高并发下不丢消息的架构?它给你的方案能把你送走。
不过,不拥抱工具的程序员确实会吃亏。我现在写代码已经离不开补全了,哪怕它偶尔犯蠢。关键是把心态放平:把它当成一个手速极快但经验不足的实习生。你审它的代码,你兜底。别指望它替你思考。真的。上次我偷懒让模型直接生成一个正则表达式,结果它给我写了个能匹配空字符串的玩意儿,线上跑了两天才发现。血的教训。
至于未来?我觉得代码大模型会越来越像“编译器+智能助手”的混合体。你写意图,它生成候选,你用测试和静态分析去筛。人还是那个拍板的人。反正我是这么看的——工具越强,人的判断力越值钱。就这样吧,我得去修那个模型给我埋的坑了。