被误读的长尾:Serverless冷启动的机制边界与工程取舍
冷启动被说烂了。九月底的南京,园区咖啡凉得很快。我听到第七个项目还在用“加内存”解释尾延迟。问题没这么简单。Serverless冷启动不是一个孤立的启动时间指标,它更像一段由调度、置备、运行时初始化、依赖加载、网络挂载和安全隔离共同构成的条件概率。你看到的P99,可能只是某个租户突增并发时,调度器在资源碎片里多绕了两圈。
一秒之外的账本
把冷启动理解成“函数从零启动”很容易漏账。请求到达之后,平台侧要完成节点选择、沙箱创建、镜像拉取或本地命中、网络与存储挂载;用户侧还要跑运行时初始化、框架加载、SDK建连、配置读取。任何一层出现抖动,都会落到调用方的尾延迟上。更麻烦的是,冷启动影响的是概率分布,不是平均值。稳定低频流量里,它可能被热实例池吸收;突发并发下,同一套配置却可能连续触发多次创建。
所以“加内存”有时有效,有时只是把创建阶段缩短了一点,却把成本推高。条件很重要:如果瓶颈在VPC弹性网卡挂载,内存翻倍未必有用;如果瓶颈在JVM类加载,预留并发可能比调规格更直接。反过来,预留实例也不是免费午餐,常驻资源在低利用率时会把按需计费的优势吃掉。这很要命。
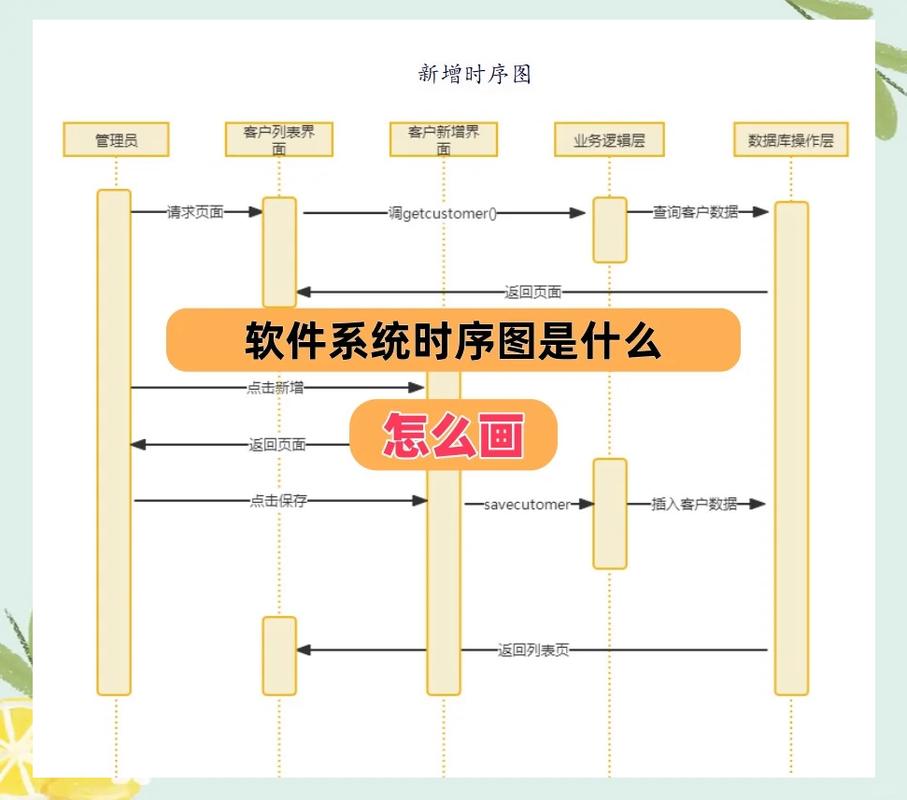 Serverless函数实例创建调度时序图
实例从无到有,究竟卡在哪几层
平台侧的第一层是调度。节点是否有足够资源、镜像是否本地命中、租户隔离策略是否允许混部,都会改变创建路径。第二层是沙箱。容器启动快,但多租户隔离要额外考虑;microVM隔离强,启动和快照恢复又引入新开销。第三层才是运行时。JVM的类加载、JIT预热和框架扫描,Python的import链和C扩展,Node的模块解析,Go和Rust相对轻的初始化,差异很大。把语言运行时当成同一种东西,测量就会失真。
再往下是应用初始化。数据库连接池、TLS握手、临时凭证、模型权重加载,这些代码往往藏在用户函数里,平台日志只看到“初始化耗时”,却看不到具体卡点。网络存储层也常被低估:挂载文件系统、拉取大镜像、建立加密通道,任何一项都可能把冷启动从百毫秒推到秒级。没有分层观测,优化很容易打偏。
快照是常见思路。进程快照、microVM快照、内存页共享与写时复制,都能把部分初始化工作前移。但快照有边界。恢复后的随机数状态、时钟、文件描述符、TLS会话、临时凭证、数据库连接,都可能已经过期或不一致。跨硬件恢复还要面对CPU特性、内核版本和驱动差异。安全上,快照共享内存页如果隔离不严,会放大侧信道风险。说实话,快照不是银弹。它适合初始化重、依赖稳定、恢复一致性可验证的场景;对频繁更新或强状态依赖的函数,收益可能被失效成本抵消。
 JVM类加载与Serverless冷启动火焰图
快照不是银弹,预热也有暗面
预热池、预留并发、分层镜像、依赖裁剪、延迟初始化、AOT编译、WASM轻量沙箱,都是可用的工程手段。它们解决的问题不同:预热池改变命中概率,分层镜像降低拉取体积,依赖裁剪减少初始化路径,AOT把部分编译开销前移。问题是,手段一多,系统就复杂。预热池命中率受流量分布影响,低流量下可能白养资源;分层镜像的缓存命中受节点局部性影响,跨节点调度会削弱收益;快照在版本发布后可能集体失效,恢复窗口里反而更脆弱。
GPU场景更典型。驱动初始化、CUDA上下文创建、模型权重加载,任何一项都不是简单“预热一下”能解决的。显存快照涉及设备状态和内存一致性,跨卡跨机恢复限制更多。这里要给出反例:如果模型权重远大于显存快照可共享部分,或者推理框架在初始化时做了硬件相关探测,快照恢复未必比冷加载快。优化要先确认瓶颈位置,再选手段,而不是反过来。
 GPU模型加载与显存快照冷启动示意图
测量先于优化:把“冷”拆成可观测事件
冷启动测量最怕采样偏差。主动探测会周期性预热实例,改变系统原本的冷热分布;只报平均值会掩盖长尾;只看平台侧创建耗时,会漏掉用户初始化。较稳妥的做法是把请求ID、实例ID、创建事件、初始化事件、首次执行事件关联起来,区分平台侧冷启动和用户侧冷启动。eBPF、OpenTelemetry、平台日志都可以用,但口径要一致。
指标上,冷启动比例、创建耗时、初始化耗时、首次执行耗时、P99尾延迟、并发突增时的创建失败率,需要一起看。条件不同,结论会变:低并发稳定业务可能感知不到冷启动;营销活动、定时任务、突发API场景则会把长尾放大。不过话说回来,测量本身也有成本,埋点过密会拖慢热路径。工程取舍就在这里。
被忽视的约束:隔离、状态与成本
 被忽视的约束:隔离、状态与成本
多租户隔离是冷启动优化的硬约束。池化越深,命中率越高,但租户边界也越难守;快照恢复越快,恢复后的状态一致性越需要验证。状态方面,数据库连接池、缓存客户端、文件句柄、临时凭证都有生命周期,不能假设快照恢复后它们仍然有效。成本方面,常驻预热资源与按需创建之间没有免费切换,流量可预测性决定了两者的相对优势。
趋势上看,轻量沙箱、硬件卸载、内存快照共享、调度感知的镜像缓存都在推进。但冷启动不会彻底消失。更现实的目标,是把不可控的长尾变成可定价、可观测、可降级的风险。这话不讨喜。但比“加内存”靠谱。