凌晨两点卡在99%的任务:大数据技术研发中被低估的数据倾斜
凌晨两点十七分,手机在床头柜上震得像个电钻。值班同事发来截图:一个Spark任务卡在99%,已经四十分钟。不是报错,是慢。那种慢特别气人——资源占着,队列堵着,下游报表全在等。你上去一看,Stage里有个task跑了38分钟,同批其他task三分钟收工。差距十倍。这时候要是有人张嘴就说“加内存”,我一般会让他先去洗把脸。
大数据技术研发里,这种场面太常见了。数据倾斜,四个字,听着像论文标题,落到生产上就是凌晨的夺命连环call。说实话,这活儿干久了,看到99%就条件反射。
先别急着加内存,看看谁在拖后腿
打开Spark UI,别只看Stage总时长。那玩意儿会骗人。看task耗时的分布,中位数和尾部。一个Stage两百个task,中位数两分半,有个家伙跑了42分钟。再看shuffle read size,它读了几GB,别人几十MB。基本坐实。
数据倾斜的本质是分布问题,不是总量问题。十GB数据均匀撒到两百个分区,每个五十MB,跑得飞快。一GB数据里有个key占九成,照样把某个分区撑爆。shuffle的时候,系统按key的hash取模分区,同一个key必须进同一个分区。某个key数据量特别大,或者大量空值、默认值挤在一起,那个分区就成堰塞湖。其他分区早早收工,它还在搬砖。并行度再高也没用,短板决定Stage完成时间。
类比一下食堂打饭。八个窗口,其中一个窗口前面排了三百人,其他窗口空了。你加再多人手也没用,因为那个窗口的菜只有一个人会打。对吧?分布式计算也是这个理。
 大数据技术研发Spark任务监控界面数据倾斜
不过话说回来,看到倾斜先别兴奋。得确认是key分布问题,还是文件大小不均、小文件太多、join膨胀。不同病根,下药不一样。
一个空值,能把整个集群拖进泥里
去年压测,订单表join用户维度表。订单表里有大量user_id空值,游客下单、埋点补传、老系统漏字段,反正一堆null。join之前没人当回事。跑起来之后,所有null的hash值一样,全挤进同一个分区。数据量从几千万膨胀到几亿。task疯狂spill——内存装不下,往磁盘倒。磁盘写满,整个集群跟着抖。
排查的时候先别猜。对join key做一次count group by,看分布。null占12%,剩下还有几个默认值比如0、-1,也抱团。问题清楚了:空值不是没数据,它在shuffle里是一个超级大key。
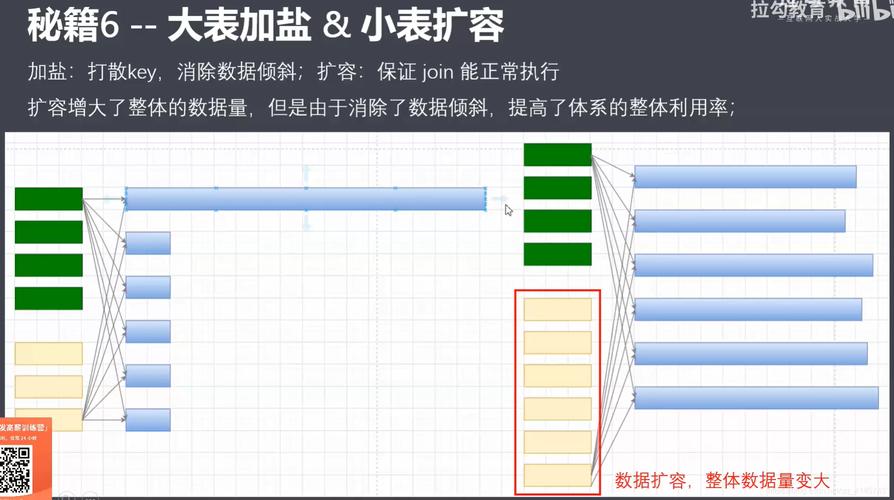
处理办法不复杂。如果业务不需要空值,join前直接filter掉。需要保留,就给空值加随机后缀,null_1到null_100,打散到不同分区,join完再去后缀。这就是加盐。原理说白了:给热点key拼一个随机前缀,先让数据散开做局部聚合,再去掉前缀做全局聚合。两阶段聚合,多一次shuffle,换并行度。
 大数据技术研发Shuffle分区数据倾斜原理图
还有个常见场景,热点商品ID。大促时某个爆款商品的日志量能顶半壁江山。你按商品ID分区,那个分区就是火山口。可以拆成productId_随机数,聚合两次。也可以自定义分区器,把热点key单独拎出来处理。方法不高级,关键是先定位。
加盐不是万能盐,这些坑我踩过
 加盐不是万能盐,这些坑我踩过
有人一听倾斜,上来就调大executor内存。内存大了,spill少了,但那个task要处理的数据量没变。原来跑40分钟,现在35分钟,资源还占得更久。治标都算不上。
还有人猛加partition数量。分区从200调到2000,看着并行度上去了。可热点key还是同一个,hash完还是进一个分区。除非你改分区逻辑,否则就是拿更多空转的task陪跑。
广播小表也是个坑。join倾斜时广播小表能避免shuffle,听着很美。但那个“小表”如果过滤后还有几个GB,driver直接OOM。广播表得真小,几百MB以内,还得看版本和配置。别拿生产环境赌。
更隐蔽的误区:只看Stage总时长,不定位具体task。有人把整个Stage并行度调低,结果更慢。有人把倾斜task杀掉重跑,碰巧过了,以为解决了。下次换个时间点,照样卡。
不是所有倾斜都值得治。一个批任务跑两小时,业务能接受,治理成本可能更高。加盐会增加网络和CPU,两阶段聚合多一次shuffle,延迟可能上升。流处理里倾斜可能是某个算子状态大,处理方式又不一样。
流处理另说。Flink任务keyBy之后,某个key的状态涨到几个GB,checkpoint超时,下游一慢,压力往回顶。你加并行度,那个key还是在一个subtask里。得看状态后端、key拆分,或者业务上把热点维度打散。批和流,药方不一样。边界得看清楚。
我现在遇到卡99%,下意识不是加资源,是打开UI看task分布。这毛病治不好,但至少能少熬几个夜。真的。