凌晨三点的重启风暴:容器化部署技术到底替我们挡了什么?
上周四凌晨两点半,我被手机震醒。群里一张图:某个业务Pod在十分钟里重启了十七次。不是流量高峰,也不是发版窗口。值班同事骂了一句:这容器化部署技术,怎么越上越像玄学?
我盯着监控看了会儿,心里大概有数。Pod是Kubernetes里调度的最小单元,你可以粗暴理解成“装容器的一个壳”。它重启,未必是K8s抽风,更多时候是应用、镜像、资源限制、探针几个东西在互相打架。
先别怪编排,重启风暴里藏着三层账
一层账在应用本身。那个服务启动时要加载一堆本地缓存,冷启动四十多秒。可它的liveness探针(存活检查)初始延迟只给了十五秒。K8s一看,哎,没响应,杀。重启,再杀。循环。
另一层账在资源。容器看着轻,但它还是进程。进程要内存,要CPU,要文件句柄。Requests和Limits写得太随意,节点一紧张,OOMKilled就来了。日志里只留一个冷冰冰的exit code 137。说实话,新手看到这个数字容易懵。
还有一层在镜像。有人图省事,镜像标签一直用latest。今天构建的latest和昨天的latest不是同一个东西。回滚?回滚到哪个latest?这就很尴尬。
你看,容器化部署技术不是把应用塞进盒子就完事。它把“环境一致性”这件事做成了基础设施,也把原来藏在运维手里的那本账,摊到了开发面前。
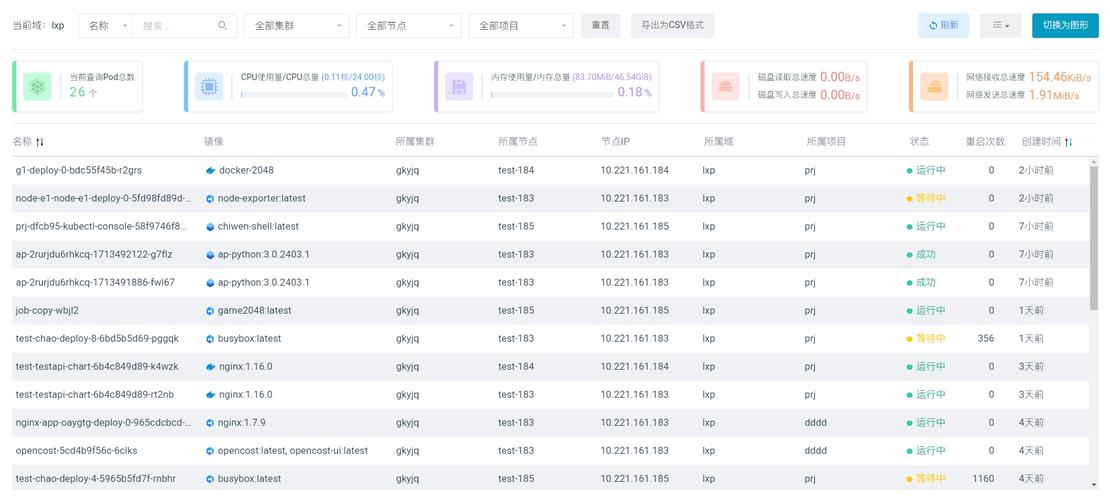 Kubernetes容器化部署Pod重启事件监控大屏
镜像不是压缩包,分层这玩意儿会记仇
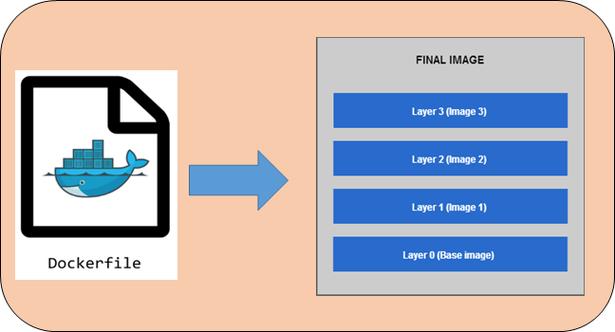 镜像不是压缩包,分层这玩意儿会记仇
很多人对镜像的理解还停留在“打包”。像把衣服塞进行李箱,拉链一拉,完事。可容器镜像更像一摞透明胶片,一层压一层。Dockerfile里每条指令,基本就是一层。底层是基础系统,上面是依赖,再上面是代码。运行时用联合文件系统把它们叠起来看,像一个完整目录。
分层有个好处:复用。你换个Java应用,基础镜像和依赖层没变,构建和拉取都能快不少。坏处也明显:层序写错,缓存就跟你翻脸。
我见过一个前端项目,Dockerfile上来就是COPY . .,然后才npm install。结果改一行README,依赖层缓存全失效,CI每次吭哧吭哧装包。后来把package.json先COPY进去,装完依赖再COPY源码,构建时间从十几分钟掉到几分钟。不是魔法,就是让缓存层别被无意义的文件改动冲掉。
还有个坑:容器里写日志。有人把应用日志直接往容器文件系统里怼。容器一重建,日志没了。麻烦的是,容器层可写层会膨胀,节点磁盘被吃满。日志应该往stdout/stderr走,交给日志采集,或者挂载到外部卷。别把容器当长期宿舍,它更像钟点房。
资源限制不是保险丝,是根橡皮筋
Limits设得太松,一个服务内存泄漏能把节点拖垮。设得太紧,应用又死得莫名其妙。这里常犯的错,是拿JVM应用开刀时只算堆内存。
比如给容器limit 2G,JVM参数写-Xmx2G。看起来严丝合缝,对吧?可JVM还有元空间、线程栈、直接内存、GC自身开销。堆外那部分一涨,容器整体超限,内核直接OOMKilled。应用日志里可能连一句遗言都没有。
我的习惯是留余量,堆内存别顶到limit。再把MaxRAMPercentage这类参数用起来,让JVM认容器限制。别让Java还以为自己看到的是宿主机那几百G内存。那是老黄历了。
CPU也类似。Requests影响调度,Limits影响节流。你把CPU limit压得很低,应用没死,但RT毛刺上来了。用户端感知就是“偶尔卡一下”。这种问题查起来很折磨。
探针也得说两句。liveness负责“要不要重启”,readiness负责“要不要接流量”。启动慢的服务,liveness的initialDelaySeconds和failureThreshold得给够。否则就是自己给自己制造重启风暴。还有,别把readiness写成依赖数据库强一致检查。数据库抖一下,全量Pod被摘流量,雪崩就这么来的。
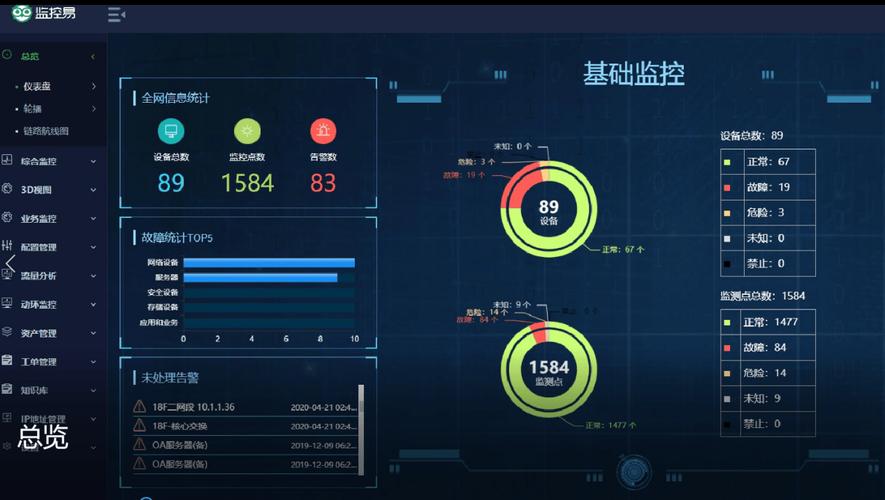 容器化部署资源限制CPU内存监控面板与OOMKilled告警
真正难的是有状态服务和那条边界
无状态服务容器化,爽。副本一扩,滚动更新,失败回滚。确实像集装箱,码头吊来吊去,不关心里面装的啥。
可数据库、消息队列、缓存这类有状态的东西,容器化部署技术就没那么轻巧了。存储卷、主从切换、备份恢复、网络标识,每个都得单独设计。不是不能跑,是别把它当无状态服务糊弄。数据放容器可写层?那是事故预告。
还有个常见误解:上了K8s就高可用。真不是。K8s能帮你调度、重启、扩缩容,但它不知道你的业务是否真健康。Pod Running不等于服务可用。一个死锁的应用,进程还在,端口还开,探针可能还活着。流量进去,全卡住。
隔离边界也得说清楚。容器不是虚拟机。它共享宿主机内核,namespace做视图隔离,cgroup做资源限制。安全隔离强度跟虚拟机不是一个量级。跑不可信负载,或者多租户强隔离场景,得多想一层。内核漏洞、特权容器、挂载宿主机目录,这些都是口子。
所以我现在看容器化部署技术,心态很平。它是个好东西,把交付物标准化了,把环境差异压小了,把部署动作变成了声明式。但它不替你写对代码,不替你设计好存储,也不替你补监控。
凌晨那场重启风暴,后来查清楚了:探针太急,加上JVM堆外内存没留余量。改完参数,Pod稳了。值班同事在群里发了句:行,今晚能睡了。
你看,容器化部署技术替我们挡了很多脏活。可边界画不清楚,它也会把脏活原样弹回来。对吧?