别再迷信99.999%可用性了:韧性技术系统才是企业扛住黑天鹅的真底牌
上周跟一个做跨境电商的朋友喝酒,他说去年旺季的时候,CDN节点被黑客打了3个小时,直接亏了700多万。我问他之前花大价钱做的"五个九可用性"容灾系统干嘛去了?他翻了个白眼说,那系统平时演练的时候顺得像开了倍速,真出事了切流量切了20分钟没切过去,运维一群人在机房里拍桌子都快哭了。
说实话,这种事我见太多了。
你花几百万买的“高可用”,根本扛不住真的故障
MIT在2024年的一份跟踪研究里,统计了全球1200个大中型企业的IT系统故障记录,发现那些标称能达到99.999%可用性的系统,在遇到非预设故障场景的时候,平均恢复时间是预设演练场景的17倍,更离谱的是,有超过6成的真实故障,是之前的演练预案里根本没覆盖到的。
远的不说,就说前几年AWS us-east-1区域的那次大规模宕机,谁能提前想到是底层冷却管道裂了?阿里云香港节点的那次故障,又有哪个企业的预案里写了“机房整体电力中断怎么办”?大家做的预案,全是照着理想状态写的,觉得只要节点挂了,切流量就行,数据库坏了,同步备份就行。可故障从来不会按你写的剧本走。
你花了三个月时间梳理所有可能的故障点,做了17套演练预案,结果真出事的时候,可能只是运维同学随手拔错了一根网线,或者某个第三方服务商的证书悄悄过期了没人提醒,又或者是你上个月刚上线的一个功能,在流量峰值的时候触发了一个没人注意的内存泄漏,直接把整个集群拖垮。
 企业IT系统预设故障与实际故障恢复时长对比柱状图
我之前接触过一个做金融支付的客户,他们的系统平时压测能扛每秒10万笔交易,结果去年遇到上游的银行接口突然返回格式变了,整个系统直接卡死,连降级都触发不了——因为他们的降级逻辑是写死的“接口超时超过3秒就切备用通道”,根本没考虑到接口能通但返回的数据全是乱码的情况。那天他们的运维在监控室坐了6个小时,眼看着交易成功率从100%掉到12%,一点办法都没有。
韧性技术系统,到底跟普通高可用有啥区别?
之前跟NIST做韧性系统框架的一个研究员喝咖啡,他说很多人对韧性的理解就是“坏了能修”,这完全是错的。韧性技术系统的核心从来不是追求“零故障”,而是在故障不可避免的前提下,就算系统坏了一半,还能像个正常人一样给用户提供核心服务,甚至能边坏边调整,不用等所有人都把问题查完才开始恢复。
跟传统的高可用系统比,韧性系统的逻辑从根上就不一样。
首先,它不是等“全损了才触发保护”,是实时感知系统的退化状态。普通系统是等整个服务挂了、监控指标飘红了才报警,韧性系统是从用户端开始埋点,只要发现某个接口的返回率掉了10%,就算技术层面的监控指标还没到告警阈值,系统就自动开始把流量往状态好的节点切,甚至自动把那些非核心的功能先临时关掉——比如电商网站发现支付链路有点晃,直接先把首页的直播弹窗、个性化推荐全关了,把所有带宽和算力留给支付和商品浏览的核心路径,用户根本感觉不到后台在做调整,只觉得网站没卡。
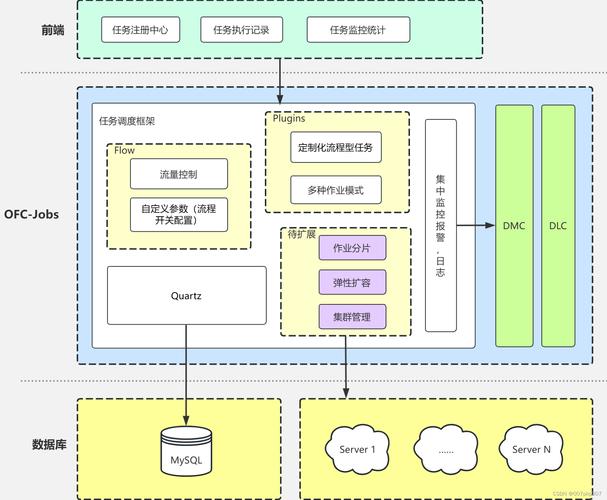 韧性技术系统核心服务流量自动调度逻辑示意图
其次,它不是要求“所有冗余节点都一模一样”,是节点之间要有差异化的冗余设计。很多企业做容灾,喜欢把两个机房的系统配得完全一样,觉得这样切流量的时候不会出问题,结果上次有个客户的两个机房同时被同一个网络运营商的骨干网故障影响,整个业务全停了——因为俩机房用的是同一家的带宽啊!韧性系统要求的是,每个冗余节点的技术栈、服务商、甚至地理位置都要有差异,就像你不能把所有鸡蛋放在同一个篮子里,还得每个篮子的材质都不一样,万一一个篮子被雨淋了,另一个还能保持干燥。
最后,它不是“故障了全靠人来救”,是系统自带自我修复能力。谷歌SRE团队之前分享过他们的存储系统案例,遇到某个节点的磁盘出现坏块的时候,根本不需要运维人工介入,系统会自动把坏块上的数据迁移到其他健康节点,甚至会自动给这个坏节点打个标记,后面所有新的请求都不会往上面发,等运维有空了再换硬盘就行。别跟我说你们的系统全靠运维熬大夜盯着,之前疫情封控的时候,多少运维被封在小区里,连机房门都进不去,全靠远程操作,要是系统没有自我修复能力,那真的是叫天天不应叫地地不灵。
现在的企业,为啥突然都开始卷韧性系统了?
说实话,以前大家做IT系统,追求的是“性能好、成本低、不出事”,现在环境变了啊。你想想,现在的外部环境有多复杂?黑客攻击越来越频繁,第三方服务商的可靠性根本不受你控制,极端天气、供应链问题,甚至是政策调整,都可能突然给你一下。
2024年上半年网信办更新的关键信息基础设施评估要求里,已经把“系统韧性能力”当成了强制考核项,不再是你做几次演练、备几个机房就算过了。再加上现在大家都在把大模型接进自己的业务流程里,之前有个做AI客服的公司,他们的系统全靠调用第三方的大模型接口,结果去年大模型服务商因为临时调整限流策略,接口直接降速到原来的10%,他们的客服系统直接瘫了,用户投诉堆了几千条。这种事你根本防不住,你总不能让大模型服务商给你写保证书说永远不会出问题吧?
很多人觉得做韧性系统要花很多钱,其实根本不是。你不用一上来就搞三个跨地域的机房,先从核心链路开始改就行——比如先把你最核心的下单、支付流程的监控埋点做细,从用户点击“支付”按钮开始,每一步的响应时间、返回状态都实时上报,然后做个简单的自动调度逻辑,只要某一步的成功率掉了5%,就自动把流量切到备用通道,甚至先把非核心的功能临时关了。这点改造花不了多少钱,但是遇到真故障的时候,能帮你省几百万甚至上千万的损失。
去年某头部电商在618峰值的时候,他们的系统有一个可用区的网络设备突然故障,导致那个可用区的30%的节点连不上数据库。换做以前的高可用系统,可能要花十几分钟把所有流量切走,再慢慢排查故障,结果他们的韧性系统在故障发生的12秒内,就自动把核心交易链路的流量全切到了其他三个可用区,甚至都没触发运维的告警——因为系统自己就把问题解决了,用户全程没感觉到任何卡顿,当天的GMV还超了预期。
上次跟那个跨境电商的朋友聊完,他回去就把之前那套花了几百万做的“五个九高可用”系统拆了一半,先把用户端的埋点补上,又给核心的下单链路加了自动降级的逻辑。上个月他跟我说,上次遇到CDN被攻击的故障,系统自己在10秒内就切了备用节点,非核心的推荐功能临时关了,整个过程用户根本没感觉,连个投诉都没收到。
你看。
哪有什么坚不可摧的系统啊。
所有的靠谱,都是因为你提前接受了“系统一定会出问题”这个事实,然后提前给它留好扛揍的余地而已。