熬了3个通宵做完的技术路线图更新,为啥上线第一周就被产品团队骂翻
上周四凌晨两点,我把电脑往桌上一砸,整层楼的保安都上来敲了三次门。
屏幕上是改了第八版的技术路线图更新文档,127页,光附的性能测试报告就占了40页,当时我还觉得,这次肯定能拿个满分——毕竟把新框架的推理速度、内存占用、上线风险全算得明明白白,连未来三年的技术演进路径都画得跟艺术品似的。
结果周一早会刚把PPT投到大屏幕上,负责现场交付的张哥直接把笔记本往桌上一放:“你这方案里说要全量迁到支持INT4量化的新框架,有没有算过我们现在在全国铺的1200多个边缘节点,有3成是2021年装的老硬件,根本不支持对应的指令集?”
我当时坐在会议室里,脸烧得慌。
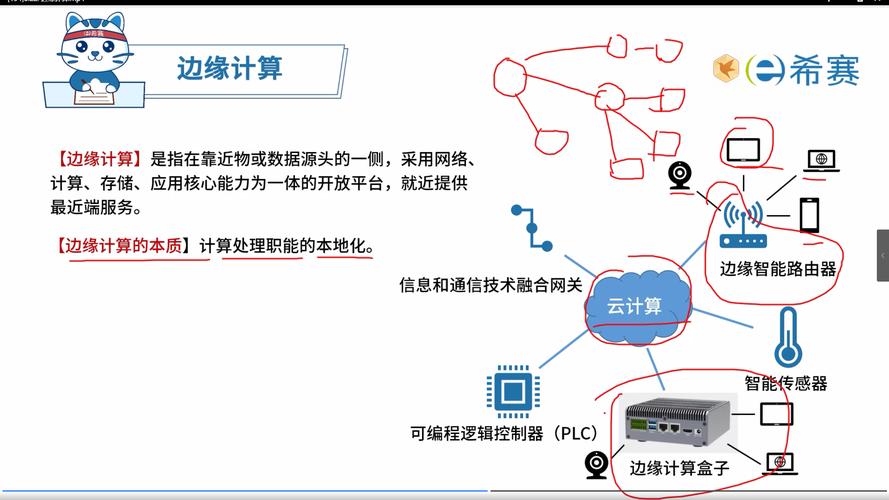 边缘计算节点硬件指令集兼容性排查表
说实话,之前我总觉得技术路线图更新,就是把上一版的排期表往后顺一顺,把没完成的任务挪到下一个季度,再添几个行业里最近火的技术点,凑够十几页PPT就能交差。那次被骂醒了之后我才反应过来,我之前做的根本不是什么技术路线图,就是个自说自话的技术自嗨清单。
技术路线图更新,根本不是改改排期表那么简单
之前组里有个刚毕业的小孩,上次帮我整理文档的时候问,说既然路线图是给技术团队看的,为什么要拉着产品、运维、甚至现场交付的人来评审?
我给他举了个上次踩的坑:当时定迁移方案的时候,我盯着测试环境里的性能数据看了三天,新框架比老框架快35%,内存占用少28%,怎么看都是个性价比极高的选择。但我完全忘了,测试环境里跑的全是2023年之后采购的新硬件,跟现场那些跑了四五年的老设备根本不是一回事。真按原来的方案推,等上线的时候,3成的节点直接跑不起来,到时候别说性能提升,连基本的业务连续性都保不住。
很多人对这个事的误解太深了。觉得技术路线图更新,就是技术负责人拍板定个方向,下面的人照着做就行。但真落地过的人都知道,你定的每一个技术选择,最后要扛结果的,从来不是坐在办公室里画PPT的人——是要爬电线杆装设备的运维,是要半夜起来处理故障的值班人员,是要对着客户解释为什么系统突然卡了的产品经理。
那次之后我再做更新,第一件事就是把所有一线的人拉到群里,先问三个问题:现在手上的活,哪个最耗时间?现在的系统,哪个地方出的故障最多?如果有一个技术功能能帮你少加两个小时的班,你最想要什么?
就这么三个问题,上次我收集上来的反馈里,有一半是我之前写在文档里根本没考虑到的——比如现场的运维说,每次要给边缘节点升级,都要远程连半小时才能把配置拉下来,要是能做个离线升级包,每次能省出来大半天的时间;比如产品的同学说,现在每次给客户加个小功能,都要等两周的开发排期,要是能把常用的功能做成可配置的组件,根本不用每次都动核心代码。
真正有用的更新,从来不是对着行业报告抄作业
上个月去南京参加产学研对接会,碰到个做工业视觉检测的团队,聊起他们去年做的技术路线图更新,全是一肚子苦水。
说当时几个研发负责人关在会议室里开了一下午会,对着网上的行业报告拍板,说大模型是未来的趋势,今年一定要把原来跑了五年的传统视觉算法全换掉,上工业大模型检测。为了这个事,整个团队停了手上所有的客户需求,花了整整六个月,把大模型的推理框架搭起来,测出来的检测准确率确实比原来的传统算法高了0.2%。
结果给客户演示的时候,人家工厂的技术主管直接摇头。
为啥?原来的传统算法跑一次检测只要10ms,完全能跟上产线一秒钟过两个零件的节拍;换了大模型之后,单次检测的延迟直接涨到了210ms,一个零件刚走到检测位,下一个已经堆在传送带上了。为了这0.2%的准确率提升,要把整个产线的速度降下来三分之一,谁干啊?
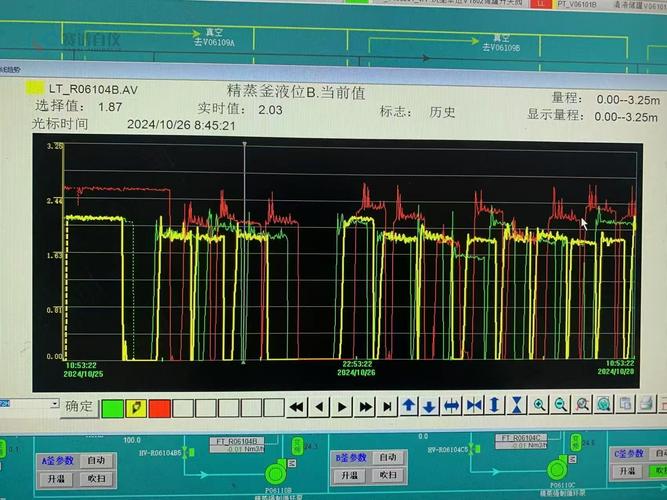 工业视觉产线算法检测延迟实测曲线
你说这叫什么事儿?
我后来帮他们翻了下他们原来的客户反馈,发现真正让客户头疼的根本不是那0.2%的准确率——毕竟原来的准确率已经到99.7%了,根本不会漏检什么次品。客户真正烦的是,每次换一个产品型号,就要把算法的参数重新调一遍,每次调参数要停线两个小时,一年下来光换型的损失就有几十万。
那他们的技术路线图更新,方向从一开始就错了。根本不是要追热点上什么大模型,是要把原来的参数配置,做成能自动学习的模块——哪怕还是用原来的传统算法,只要把换型的停线时间从两小时压到15分钟,给客户创造的价值,比追着热点上什么最前沿的技术高太多了。
不过话说回来,这种事真的太常见了。我见过太多团队做技术路线图更新的时候,把“跟上行业技术趋势”当成了最高目标,根本不管自己的业务到底需要什么。人家说云原生是趋势,就不管自己的业务量是不是真的需要,非要把所有的系统全上容器;人家说Rust是未来,就不管团队里有没有人会写,非要把原来跑的好好的Python服务全用Rust重写。最后钱花了,人累了,客户的问题一个没解决,全是自己感动自己。
别把更新后的路线图,当成不能碰的铁律
我之前在的那个老团队,去年做技术路线图更新的时候,把每个季度的任务都拆到了具体的周,连每个模块要写多少行代码都算好了。当时的技术负责人说,路线图一旦定下来,就像军队的作战命令,绝对不能随便改,不然就会乱了阵脚。
结果刚过了两个月,我们用的那个开源推理框架的社区,突然出了个优化补丁,能把我们当时卡了半年的性能问题,直接解决40%。当时我提出来,要不要抽两个人把这个补丁适配一下,结果负责人直接给我打回来了:这个补丁不在原来的路线图里,要等下一次季度更新的时候再排进去。
等了三个月,我们终于排上了这个任务,结果发现竞品早就把这个优化用上了,我们的三个大客户因为推理延迟的问题,直接转了别家。
现在想起来都气。
后来我自己带团队做更新的时候,根本不会把每个季度的任务拆到那么细。我只会在文档里写三个核心的硬指标——比如今年要把边缘节点的部署成本降30%,要把新功能上线的平均响应时间压到48小时以内,要把线上的故障复发率降到5%以下。至于中间用什么技术、走什么路径,完全给一线的开发留够调整的空间。
上次做更新评审的时候,刚进来半年的实习生提了个点,说原来的路线图里,要花两个月自研一套配置中心,但是现在有个开源的配置中心,只要花一周时间做个适配,就能满足我们80%的需求,根本没必要花那么多时间自己写。当时我们几个老研发一开始还觉得,自己做的东西才可控,结果拉下来测了一周,那个开源版本的稳定性,比我们之前自己写的那个版本还高。最后直接把原来排了两个月的自研任务砍了,省下来的时间做了那个客户盼了好久的换型自动配置功能。
很多人觉得,技术路线图更新完,就等于画了一条不能偏的直线,但凡稍微绕一点路,就是路线执行不到位。但真实的技术工作哪有那么顺?你永远不知道开源社区明天会出什么好用的工具,不知道客户的需求会不会突然变,不知道哪个原来以为没问题的技术选择,落地的时候会冒出来什么之前完全没预料到的坑。
上周我把之前熬夜写的那版127页的文档全删了,重新写了三页纸的技术路线图更新。没有华丽的架构图,没有密密麻麻的性能指标,就写了今年要解决的三个核心问题,还有每个问题对应的负责团队。
哪有那么复杂?