小样本学习:跳出数据量崇拜的模型训练路径
上个月在南京的产学研闭门会上,做农业虫害识别的张工站起来吐槽,他们要监测的本地入侵蛾类,整个华东片区的有效标注样本加起来才17张。
17张。
按以往监督学习的训练逻辑,这个数据量连个能跑的基线模型都凑不出来——别说上线做田间监测,哪怕是实验室里凑个能看的准确率都难。
标注成本的墙,早把垂直场景的团队逼到角落了
现在主流的计算机视觉模型,要训个能用的分类器,动辄要几千上万张标注图,背后的成本根本不是小团队能承担的。医疗影像领域,一张病理切片的标注要资深病理师花半小时,单张标注成本几十块;工业故障检测的样本,要等设备出故障才能录到,一次非计划停机的损失可能几十万,根本不可能为了攒样本特意制造故障。更别说很多小众场景,比如传统非遗技艺的动作识别,整个掌握核心技艺的老艺人就剩十几个,能拍的有效样本本来就少,还要标注关键动作节点,难度呈指数级上升。
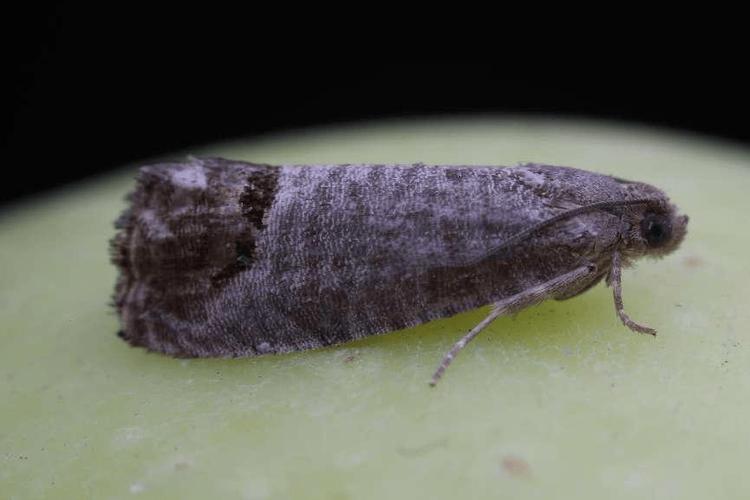 农业入侵蛾类标注样本实拍图
很多团队之前的解法是硬凑数据,要么爬取网上的同类型图凑数,要么用生成模型造批量假样本——但爬来的图域差异大,造的假样本特征不真实,最后训出来的模型看着实验室准确率漂亮,一到真实场景就崩。张工他们之前也试过用网上的飞蛾图凑了几千张,训出来的模型把田里的蝴蝶全认成了入侵蛾,误报率高到农户根本不敢用。
核心逻辑从来不是“从零学新东西”,是把旧经验快速搬过来
很多人对这类技术的误解,觉得它能让模型用几张图就学会完全陌生的知识,其实根本不是。它的本质是让模型先在海量的通用数据集里,练会“怎么快速识别一个新类别”的能力,而不是提前把所有可能遇到的类别都背下来。就像人之前见过猫、狗、松鼠这些带毛的哺乳动物,现在给你看一张从来没见过的耳廓狐照片,不用别人反复讲解,看一眼就能大概归类到犬科范畴——这种“快速迁移归类”的能力,就是模型要提前练好的核心技能。
预训练阶段学到的先验特征,和下游任务的特征匹配度,直接决定了少样本训练的上限。比如之前有团队把在自然街景数据集上预训练的模型,直接迁移到肝癌病理切片的分类任务上,哪怕给了50张标注的切片样本,准确率还不如随机猜测——因为街景图里学到的边缘、纹理特征,和病理切片里的细胞形态、病变分布完全不搭,旧经验根本搬不过去。
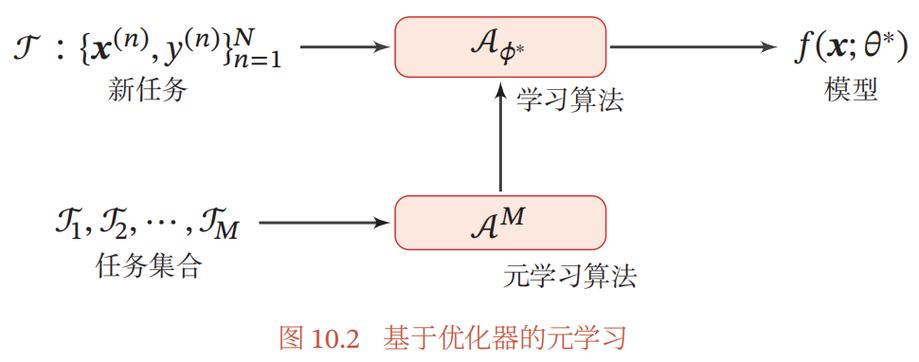 元学习任务适配机制流程图
反过来看张工的团队,后来换了个在海量昆虫图像上预训练过的模型,同样是17张蛾类的标注样本,只调整了最后两层的分类头参数,准确率直接从原来的30%多升到了82%——因为预训练阶段已经学会了识别昆虫的翅膀纹理、触角形态这些通用特征,只需要用少量样本微调下新类别的决策边界就行,根本不用从零开始教模型认虫子。
别吹得太神,它的边界其实划得很死
 别吹得太神,它的边界其实划得很死
现在不少对外宣传把这类技术吹成了万能解药,好像只要用了,多少样本都能训出高精度模型,其实根本不符合实际。如果下游任务和预训练的域差异太大,比如要用它识别量子计算机里的量子态分布,预训练阶段全是自然图像或者通用文本的特征,完全和量子态的物理特征不沾边,那哪怕给100张标注样本,效果也不会有质的提升。
样本太少的时候,模型特别容易过拟合到无关的噪声特征上。比如张工他们最开始用的17张样本,全是在阴天的大棚里拍的,背景都是灰绿色的塑料膜,模型训完之后,把所有灰绿色背景上的小虫子都认成了入侵蛾——哪怕那是个蚂蚁。后来他们特意补了几张在晴天田埂上拍的、背景是黄土和杂草的样本,误报率才降下来。还有个更隐蔽的风险:如果训练样本里存在标注偏差,比如某几张蛾类的图是被农药喷过的,翅膀有残缺,模型可能会把“翅膀残缺的飞虫”当成这个类别的核心特征,到了真实场景里,把其他被农药喷过的非目标蛾类全认成了入侵种。这些问题根本不是靠调算法能解决的,得靠真实场景的持续迭代验证。
落地的时候,先别等“完美算法”,先把小流程跑通
很多团队的误区,是总想着要等学术界出了个突破性的算法,再开始落地应用,其实根本没必要。现在可落地的路径已经非常清晰:选和下游任务领域尽量接近的预训练模型,不要硬套那种和任务完全不搭的通用大模型;把预训练模型的大部分参数冻住,只留最后几层的分类头做微调,这样能最大程度利用之前学到的先验特征,也不容易因为样本太少出现过拟合;不要把训练和测试的流程关在实验室里,要把模型放到真实场景里跑,收集那些预测错误的样本,挑几个关键的标注后补进训练集,迭代个两三轮,效果比在实验室里调半个月参数有用得多。
张工他们后来就是这么做的,把训出来的模型先放到几个试点田里跑,农户拍了虫子的照片上传,模型先给个初步预测结果,他们每天抽10%的预测错误的图标注后补进训练集,跑了一个月,有效样本从17张涨到了120多张,模型的准确率升到了91%,已经能给农户做初步的虫害预警用了。
技术从来都不是万能的。
它只是帮你把原本需要几百张样本才能做完的事,压缩到几十张的规模——剩下的坑,还是得自己一步一步踩。