当黑箱需要"交底":模型可解释性的落地困局与破局思路
上周在南京江北新区的产学研对接会茶歇区,我被一个做医疗影像AI的创业者堵在咖啡机旁边。他的团队做的早期肺癌结节检测模型,在三个公开数据集上的AUC都摸到了0.97的线,但是卡在三类医疗器械注册证上快半年了。药监的评审专家翻完他们的解释材料,只问了一句话:你告诉我,模型判断结节恶性的时候,到底依据的是影像里的哪部分特征?
他说他们当时准备了整整一百页的材料,里面全是Grad-CAM生成的热力图,红通通的色块精准覆盖在结节位置,看着特别专业。结果专家当场点了两组不同批次的测试集,同样的模型,热力图一会飘到结节边缘的毛刺上,一会盖到旁边的血管影上,连个稳定的关注区域都找不到。
真的。
三类证卡在哪了?
很多人对这事儿的第一反应是,不就是给黑箱套个可视化的壳吗?至于卡半年?还真至于。
现在行业里谈的相关能力,其实从根上就分成了完全不同的两类。一类是内在的透明性——也就是模型从设计之初,每一步决策的逻辑都是人能读懂的,比如线性回归的权重、决策树的分支规则,你顺着模型的计算路径走一遍,就能完全复现它为什么会输出这个结果,根本不需要事后做任何加工。另一类是事后的归因——也就是模型本身是个完全不透明的黑箱,等它跑完输出结果了,你再用LIME、SHAP这类方法,去局部拟合一个简单的近似模型,反推它"可能"是看了哪些特征才做出的决策。
那个创业者踩的坑,本质上就是把第二类方法当成了第一类来用。他的深度模型本身的推理过程根本没有任何透明度,事后生成的热力图,本质上是一种"近似猜测",根本不是模型真实的决策依据。就像你猜一个人为什么生气,可能猜他是因为被人踩了脚,但实际上他是早上出门忘带了钥匙,哪怕你猜的表情和动作再像,也不是真实的原因。
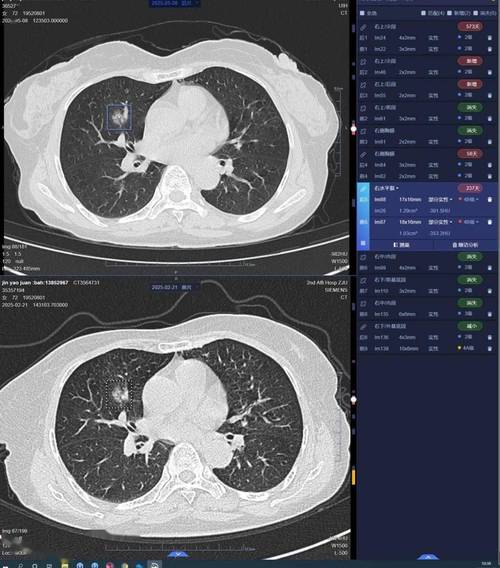 医疗影像AI肺癌结节识别热力图跨批次对比图
他当时跟我吐槽,说之前找了个团队做解释模块,花了快小一百万,做出来的界面漂亮得像科技发布会的演示页,结果专家翻了两页就扔回来,说"你这个图你自己敢信吗?"。他说他现在才明白,监管要的根本不是好看的可视化,而是解释结果和模型真实决策的一致性——你说模型看了结节的毛刺,那换任何一批数据,这个判断标准都不能变,不然就是在骗自己。
别把"解释"做成了"装饰"
这种把解释当装饰的事儿,根本不是医疗领域独有。我接触过的好几个做金融风控的团队,给用户展示的拒贷理由,永远是那几句套话:"您的征信存在逾期记录""您的收入水平未达到准入要求"。但你真去翻模型的决策日志就会发现,很多时候触发拒贷的核心原因,是用户的设备ID和之前的欺诈团伙有重合,或者用户在填申请表的时候,打字的间隔时间和之前的欺诈样本高度相似——这些根本不能给用户看的理由,才是模型真正的决策依据。
说白了,这些团队做解释模块,从来不是为了搞清楚模型到底在想什么,而是为了应付合规检查,做个能拿出去给人看的"门面"。这种装饰性的解释,有两个特别大的隐患。一是根本没法排查模型本身的偏见。之前有个做简历筛选的团队,他们的模型会自动把所有简历上带"女性""已婚已育"标签的候选人优先级压到最低,但是他们的事后解释系统给出来的理由,全是"候选人毕业院校不符合要求""工作年限不达标"——这种完全错位的解释,让他们直到被劳动监察部门找上门,都没发现模型早就学到了简历里的性别偏见。二是这种错位的解释,会直接把用户的信任耗光。明明是因为设备关联欺诈被拒贷,你跟用户说他征信有问题,用户一查自己的征信干干净净,转头就去投诉,最后平台还要花更高的成本去公关。
 金融风控拒贷场景下事后解释与真实决策偏差示意图
现在很多人吹的各种事后解释方法,其实都有一个绕不开的前提假设:模型的决策边界是局部线性的。但深度模型的决策边界,是在高维空间里堆出来的高度非线性的曲面,你在某一个点附近拟合的那个简单线性模型,根本代表不了整个决策边界的逻辑。我们之前在合作的风控项目里做过测试,当模型的拒贷率超过15%的时候,事后解释和真实决策的一致性会跌到30%以下——也就是说,你给用户看的十个解释理由,有七个是编的。
真的太扯了。
你说这叫解释吗?这叫编理由。
没有通用的适配方案,只有场景下的取舍
我经常听到有人说,可解释性是个伪命题,只要模型的性能足够高,黑箱就黑箱,没必要花精力去拆。这话其实只说对了一半。
根本不存在一个能适配所有场景的通用方案。你得先想清楚,你做这个解释,到底是给谁看的,要解决什么问题。
比如在自动驾驶的场景下,你根本不需要给坐在车里的乘客解释为什么要踩刹车——乘客只需要知道车开得稳就行。但是你必须在发生事故的时候,能完整还原模型当时的感知逻辑:是真的识别到了横穿马路的行人,还是把路边的广告牌反光当成了行人?这个解释是用来定责的,要求的是全链路的可追溯,根本不需要做什么花里胡哨的可视化。再比如在刑事司法的量刑辅助场景下,你根本不能用纯黑箱的深度模型。因为司法决策的核心是正义,你必须把每一个影响量刑的因子的权重都列得明明白白,为什么这个被告人判了三年,那个判了两年,每一个情节贡献了多少刑期,这种场景下,哪怕你用的线性模型性能比黑箱低5个点,你也必须用内在透明的模型,因为逻辑的透明性本身就是司法正义的一部分。
上个月在南京生物医药园跟一个做AI制药的团队聊天,他们现在根本不用端到端的大模型做小分子筛选。他们把所有候选的分子,都拆成已知的官能团组合,每一个官能团和靶点蛋白的结合力,都是有明确的物理化学机制支撑的,模型只是在这些已知的机制框架下,去搜索能达到最高结合力的分子组合。这种方式生成的解释,根本不是事后贴上去的,是和模型的每一步推理完全绑定的——你说这个分子能成药,是因为哪几个官能团和靶点的哪个结构域结合,有什么物理机制,讲得明明白白,所以他们的项目很快就拿到了临床前的批件。
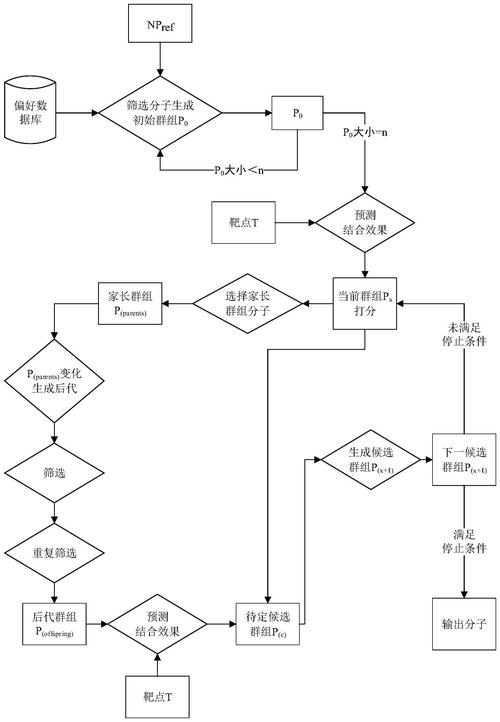 基于官能团约束的AI分子筛选模型推理流程图
很多人有个误区,觉得可解释性是模型训练完之后,再加个模块就能搞定的功能。根本不是。你从一开始就想着要做个性能拉满的黑箱,等所有指标都达标了,再回头想怎么解释它的决策逻辑,基本是不可能的。解释性必须是在模型设计的最开始,就嵌进去的约束条件——就像你盖房子,不能等楼盖完了,再去给每一层装消防通道,那时候根本装不上。
现在总有人说,等模型的参数规模到了一定程度,黑箱的问题就自然解决了。我真的劝这些人醒醒。参数越多,模型的决策逻辑就越复杂,你需要追溯的链路就越长,根本不是参数少的时候那种简单的线性关系。现在大模型的上下文窗口都开到百万token了,你要解释模型为什么在某一个位置突然触发了幻觉,难道要把所有注意力头的权重都逐行翻一遍?
说白了,所谓的可解释性,从来不是什么高科技的噱头。就是你做出来的模型,得敢把自己的决策逻辑摊开了给人看,不能出了问题就躲在黑箱后面说"我也不知道为什么会输出这个结果"。