从城市积水到候鸟迁徙:复杂系统建模为什么不能解决所有问题
2023年9月23日,我在南京新街口。那场暴雨说来就来,不到一小时积水没过了脚踝。
前一天市政官推还说,新的泄洪模型已经优化过,能应对五十年一遇的小时降雨量。结果呢?排水工人掏了三个小时,从主干管网的进水篦子里掏出三个外卖盒、两个破塑料袋,还有半只被冲走的拖鞋。
那时候我就想,我们对着一堆公式调参数,画了无数张漂亮的趋势图,最后让整个系统瘫掉的,居然是三个没人在意的外卖盒。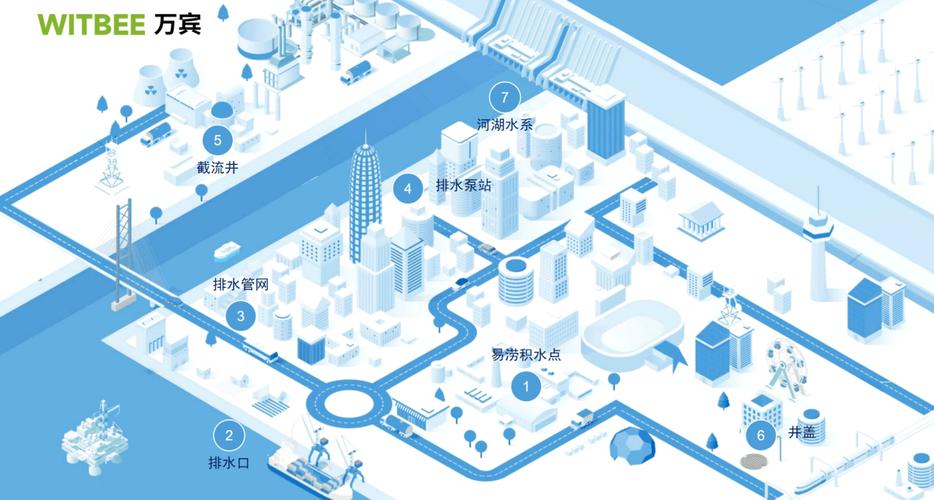 城市内涝复杂系统变量关联图
初始输入的微小偏差,在多轮连锁反应之后,能把最终结果带偏到十万八千里。洛伦兹的蝴蝶效应说了几十年,可真到落地做项目的时候,所有人还是会下意识忽略那些细碎的、看起来不重要的连接。
说实话,我见过至少三个项目,前期汇报的时候说覆盖了九成以上的核心变量,现场一跑就翻车。不是漏了人行为的随机性,就是没算清楚变量之间会互相触发。疫情初期的传播预测模型,很多都没算封控之后跨区流动的概率,更别说不同社区管理强度对传播路径的干扰,最后出来的结果差了好几倍,成了圈子里的笑柄。
没有任何一个模型能装下真实世界的所有连接。这不是技术不够先进,是复杂系统本身的特质决定的。
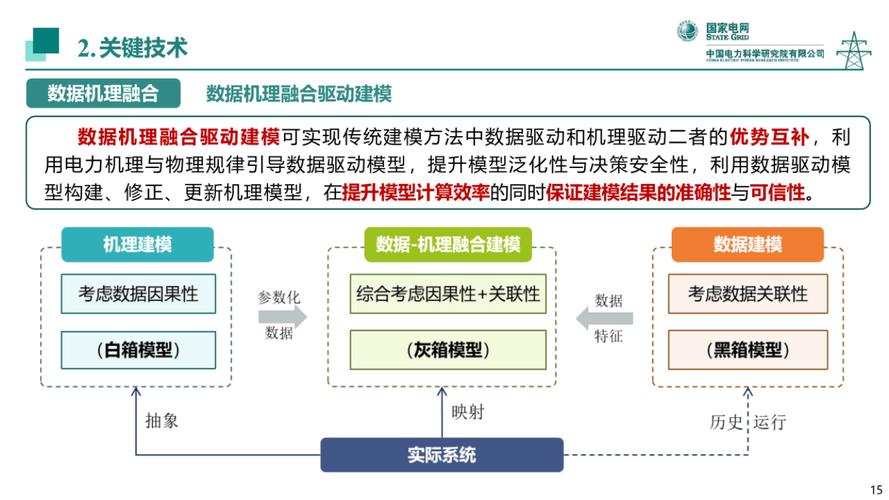 复杂系统机理模型与数据驱动模型对比图
有学者做过测试,同一个生态预测模型,把参数精度从99%提高到99.9%,算力翻了五倍,最终预测准确率只提升了不到两个百分点,投入产出比低到离谱。所以现在业内好用的模型,基本都是机理搭框架,数据调参数,先把核心的作用机制定下来,再用实际观测数据修正参数偏差,比走任何一个极端都靠谱。
不过话说回来,哪怕把两种思路捏合得再好,你也得接受一个事实:它永远不可能100%准确。因为复杂系统最核心的特征就是涌现性——单个个体不具备的特征,数量足够多的个体凑到一起,就会突然冒出来。你把每一只蚂蚁的行为模式都摸得一清二楚,也算不出来整个蚁群什么时候能找到新的食物源。交通拥堵也是一样,三五辆车的速度变化根本不会影响全局,可突然多出来的十几辆车,就能让整座桥堵上一两个小时,这个临界点,没人能精准算到。
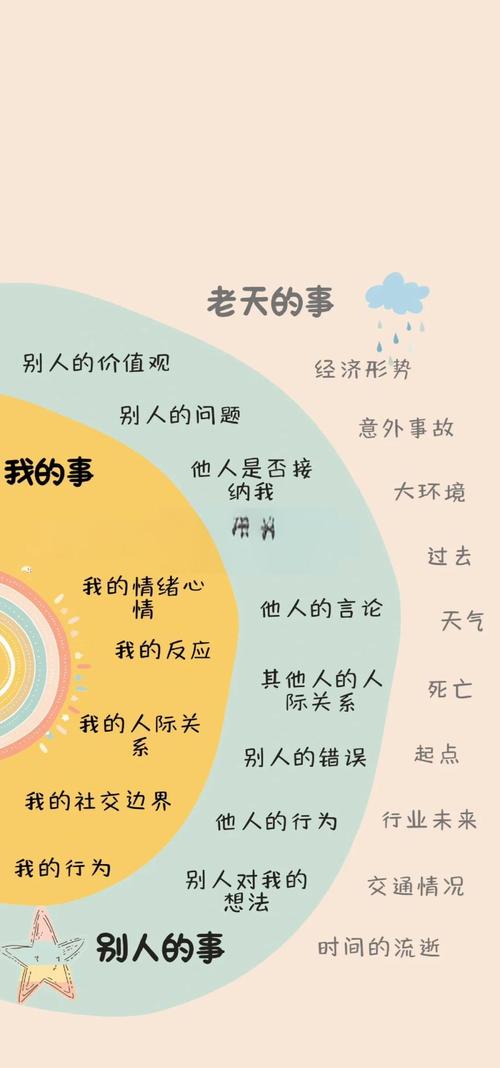 画清楚边界比算出精准结果更重要
我跟年轻工程师聊天,最常说的就是,别上来就追求完美的精准结果,先想清楚你的模型能用在什么地方,不能用在什么地方。太多人搞反了顺序,上来就要算得准,结果用错了场景,出了错反过来骂模型没用。
你要算城市片区十年尺度的人口变化,不需要精准到某一栋楼某一个人,模型适当简化,误差控制在十个百分点以内,完全够用,足够给规划做参考。可你要算明天早高峰某一座桥的实时车流量,那就得把临时封路、交通事故、甚至周边商场促销带来的额外车流都考虑进去,差五个百分点都可能引发大拥堵。
还有容易被忽略的偏见风险。很多模型看起来是冰冷的数字,其实藏了建模者的主观选择。比如城市更新项目里的拆迁评估模型,要是一开始就把老城区的文化价值权重压得极低,把土地出让收益权重拉得极高,最后算出来的结果肯定是拆了重建,这哪里是模型得出的结论,这是用模型给预先想好的结论套了个数字外衣而已。
模型永远只是工具,它输出的结果,从一开始就带着建模时的假设、权重选择、变量取舍。把模型输出当成绝对真理,本质上是偷懒,出问题是必然的。长三角某新城前几年做规划,模型算出来十年后人口能到三百万,结果五年过去实际入住才不到一百万,核心问题就是模型一开始假设人口年均增速能保持在八个百分点,完全没考虑全国人口增速下滑的大趋势,假设前提错了,结果再漂亮也没用。
现在到处都在吹各种新技术,说能搞定所有复杂问题,我不信。真的在这行摸爬滚打过的人都知道,我们能做的,不过是在有限的范围、有限的假设下,给出一个大概率正确的参考,从来不是什么标准答案。
那天躲雨的时候我看着排水工人掏垃圾,就想起这个事。我们建了那么复杂的模型,算了那么多漂亮的曲线,最后卡脖子的,还是三个被人随手扔掉的外卖盒。这就是最真实的样子——你永远算不到所有细节,所以得接受不完美,也得时刻盯着那些模型之外的小事。
为什么还原不了真实世界的混沌连接
大部分建模工作起步时,都会默认走还原论的路子:把整个系统拆成若干独立模块,给每个模块定参数,再把模块连起来出结果。 城市泄洪模型拆成降雨量、管网直径、地面坡度、河道容水量几个模块,每个模块的参数都调得精准无比,小数点后三位都对得上。谁会想到加一个“周末新街口外卖垃圾产生量”“行人乱扔垃圾堵塞篦子概率”这种变量?加进去倒也不是不行,可变量多一倍,算力需求可能翻十倍,项目预算直接超了,甲方也不会给你加钱。城市内涝复杂系统变量关联图
初始输入的微小偏差,在多轮连锁反应之后,能把最终结果带偏到十万八千里。洛伦兹的蝴蝶效应说了几十年,可真到落地做项目的时候,所有人还是会下意识忽略那些细碎的、看起来不重要的连接。
说实话,我见过至少三个项目,前期汇报的时候说覆盖了九成以上的核心变量,现场一跑就翻车。不是漏了人行为的随机性,就是没算清楚变量之间会互相触发。疫情初期的传播预测模型,很多都没算封控之后跨区流动的概率,更别说不同社区管理强度对传播路径的干扰,最后出来的结果差了好几倍,成了圈子里的笑柄。
没有任何一个模型能装下真实世界的所有连接。这不是技术不够先进,是复杂系统本身的特质决定的。有限算力下的妥协:找规律还是找概率
现在圈子里其实分成了两种完全不同的路径,一派坚持做机理模型,非要把每个作用机制都讲得清清楚楚,另一派直接把所有数据扔给大模型,让机器自己找关联。两种路都走,也两种路都有绕不开的边界。 机理模型的问题刚才说过了,变量太多算力扛不住,只能做简化,一简化就容易丢掉最关键的那个连接。那纯数据驱动的模型呢?我去年帮朋友看过一个园区人流预测的项目,用过去三年的历史数据训出来,离线测试准确率能到九十五 percent,所有人都觉得没问题,结果落地第一个月,园区旁边开了个露天音乐节,周末人流直接比预测值多了三倍,整个园区的停车系统直接崩了。 为什么?历史数据里根本没有露天音乐节这个场景。数据驱动模型永远跳不出训练数据的框架,遇到没见过的黑天鹅事件,直接输出乱码。复杂系统机理模型与数据驱动模型对比图
有学者做过测试,同一个生态预测模型,把参数精度从99%提高到99.9%,算力翻了五倍,最终预测准确率只提升了不到两个百分点,投入产出比低到离谱。所以现在业内好用的模型,基本都是机理搭框架,数据调参数,先把核心的作用机制定下来,再用实际观测数据修正参数偏差,比走任何一个极端都靠谱。
不过话说回来,哪怕把两种思路捏合得再好,你也得接受一个事实:它永远不可能100%准确。因为复杂系统最核心的特征就是涌现性——单个个体不具备的特征,数量足够多的个体凑到一起,就会突然冒出来。你把每一只蚂蚁的行为模式都摸得一清二楚,也算不出来整个蚁群什么时候能找到新的食物源。交通拥堵也是一样,三五辆车的速度变化根本不会影响全局,可突然多出来的十几辆车,就能让整座桥堵上一两个小时,这个临界点,没人能精准算到。画清楚边界比算出精准结果更重要
画清楚边界比算出精准结果更重要
我跟年轻工程师聊天,最常说的就是,别上来就追求完美的精准结果,先想清楚你的模型能用在什么地方,不能用在什么地方。太多人搞反了顺序,上来就要算得准,结果用错了场景,出了错反过来骂模型没用。
你要算城市片区十年尺度的人口变化,不需要精准到某一栋楼某一个人,模型适当简化,误差控制在十个百分点以内,完全够用,足够给规划做参考。可你要算明天早高峰某一座桥的实时车流量,那就得把临时封路、交通事故、甚至周边商场促销带来的额外车流都考虑进去,差五个百分点都可能引发大拥堵。
还有容易被忽略的偏见风险。很多模型看起来是冰冷的数字,其实藏了建模者的主观选择。比如城市更新项目里的拆迁评估模型,要是一开始就把老城区的文化价值权重压得极低,把土地出让收益权重拉得极高,最后算出来的结果肯定是拆了重建,这哪里是模型得出的结论,这是用模型给预先想好的结论套了个数字外衣而已。
模型永远只是工具,它输出的结果,从一开始就带着建模时的假设、权重选择、变量取舍。把模型输出当成绝对真理,本质上是偷懒,出问题是必然的。长三角某新城前几年做规划,模型算出来十年后人口能到三百万,结果五年过去实际入住才不到一百万,核心问题就是模型一开始假设人口年均增速能保持在八个百分点,完全没考虑全国人口增速下滑的大趋势,假设前提错了,结果再漂亮也没用。
现在到处都在吹各种新技术,说能搞定所有复杂问题,我不信。真的在这行摸爬滚打过的人都知道,我们能做的,不过是在有限的范围、有限的假设下,给出一个大概率正确的参考,从来不是什么标准答案。
那天躲雨的时候我看着排水工人掏垃圾,就想起这个事。我们建了那么复杂的模型,算了那么多漂亮的曲线,最后卡脖子的,还是三个被人随手扔掉的外卖盒。这就是最真实的样子——你永远算不到所有细节,所以得接受不完美,也得时刻盯着那些模型之外的小事。