从眩晕到沉浸:虚拟现实技术研发绕不开的三道坎
现在打开任何一个科技展会,几乎都能看到它的身影。头显摆出来,你戴上去逛两分钟,所有人都喊“未来已来”。摘下来,该解决的问题一个都没少。
感知端的矛盾:头显渲染的带宽悖论
人眼感知的沉浸感,本质上是信号的匹配。视觉动了,前庭神经也要跟上,差个几十毫秒,眩晕感立马就上来了。为了消除眩晕,行业内的共识是端到端延迟必须控制在20ms以内,同时刷新率要跑到120Hz以上,双眼分辨率要达到单眼4K才能避免纱窗效应。
算一笔很简单的账:单眼4K是3840*2160像素,双眼就是近1600万像素单帧,乘以120帧每秒,每秒要输出近19.2亿像素。就算砍掉一半冗余信息,压缩后的码率也需要1.5Gbps以上的稳定带宽支撑。
有线头显能解决这个问题,但是拖着一根线,永远做不到真正的自由移动。无线头节能解决线材问题,但是带宽跟不上。
去年我体验过一款标称8K分辨率的消费级无线头显,实际拆开看参数,是单眼2K通过算法插值放大到4K,标称120Hz刷新率,实际动态场景下会自动降到70Hz,在我家客厅隔着一堵墙连WiFi,玩20分钟射击游戏,下来直接恶心了半小时。
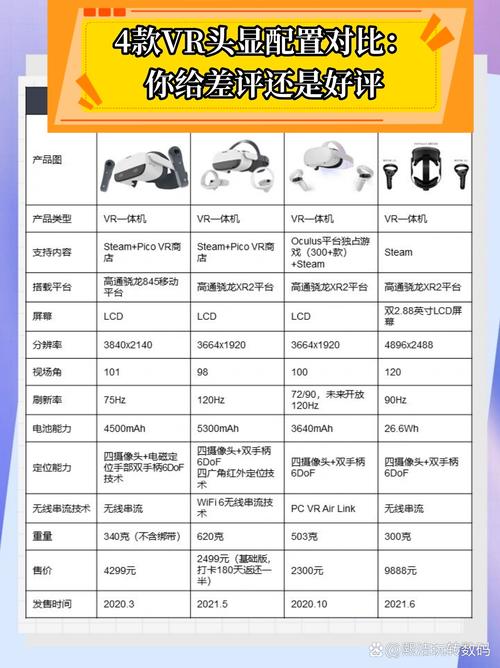 虚拟现实头显双眼渲染带宽需求对比图
不是做不到更高的参数,是做不到参数、体积、价格三者的平衡。你把专业级工作站塞进头显里,当然能做,但是一台头显卖十几万,有几个人买?大多数消费级产品,本质上都是参数上的拆东墙补西墙,补到最后,该晕还是晕。
内容生产的陷阱:动捕成本的不可降维
技术问题解决了,还有内容的问题。所有人都喊着要做虚拟世界,但是虚拟世界的内容从哪来?
现在很多人说AI生成内容能降本,AI生成个静态场景还行,生成带动态交互的真实人物,细节全是糊的。就算是AI生成,也要有高精度的训练素材,素材从哪来?还是要靠动作捕捉。
专业级光学动捕棚,十几个摄像头加上后期处理软件,一套下来几百万,中小工作室根本碰不起。就算是入门级的惯性动捕套装,一件衣服加十个传感器也要小两万,动捕的时候穿在身上浑身闷汗,稍微动快一点数据就飘,后期修数据就要花掉一半的制作时间。
我之前认识一个创业团队,拿了几百万天使轮,要做虚拟偶像的互动内容,第一年光是动捕设备和场地租金就花掉了三分之二的钱,做了三个内容就没钱了,最后团队散伙,设备卖了抵工资。
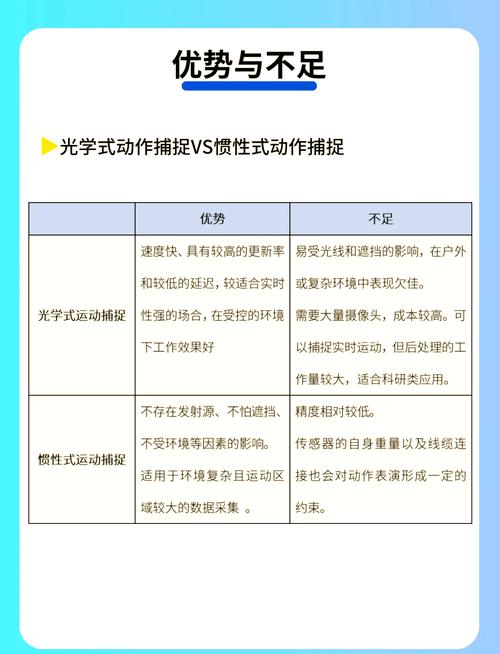 惯性动作捕捉与光学动作捕捉精度对比图
说实话,很多人都低估了内容生产的隐形成本。扫个10平米的房间,看起来很简单,出来的模型面数动不动就几百万,普通手机运行起来直接卡成PPT,还要减面修纹理,又是好几天的工作量。UGC喊了这么多年,真正能产出可用内容的,还是那少数专业团队,成本根本降不下来。
应用边界的迷思:到底什么场景非它不可
 应用边界的迷思:到底什么场景非它不可
现在很多项目,为了拿融资硬蹭概念,好好的线下培训,套个VR壳就变成了高科技项目,实际上根本没人用。
举个例子,普通的机床操作培训,VR能教你哪个按钮在哪个位置,能教你操作顺序,但是教不了你拧螺丝的手感,教不了你刀具碰到工件的阻力反馈。现在能做到千牛级力反馈的设备,一台就要几十万,不可能给每个培训学员配一台。说白了,这个场景就是伪需求,用个PPT加视频培训,效果更好,成本还低。
那哪些场景是真需求?高危行业的模拟训练是真的。消防救援培训,不可能真炸一栋楼让消防员练进场搜救,化工行业的应急演练,不可能真泄漏有毒气体让练处置,用VR模拟,想练多少遍练多少遍,不会出安全事故,成本还低。
还有临床康复领域。中风患者的肢体运动恢复,传统方法是康复师一对一带着练,一个康复师一天带不了几个病人,用VR做动作捕捉和实时矫正,患者自己就能跟着系统练,康复师只需要远程调整方案,效率能翻好几倍。
不过话说回来,现在行业的风向已经变了。前几年所有人都盯着C端消费市场,想着做下一个爆款硬件,砸了几百亿进去,没几个跑出来的。这两年越来越多的团队开始转做B端垂直场景,不追求极致参数,只解决具体问题,反而活的很舒服。
工业仿真领域,只要能把设备的尺寸、参数做准,延迟控制在50ms以内,就能帮企业提前测试新产品的装配流程,省下几百万的开模费用,企业愿意掏钱。展厅展馆的互动项目,只要能做出来让游客能沉浸式体验本地文化,体验完能拍照发朋友圈,主办方就满意,也不需要多高的参数。
绕了一大圈,才发现最开始的路走反了。不是先有极致的技术再找场景,是先有真实的需求再打磨技术。好多团队现在还在卷8K卷16K,其实根本没必要,大部分落地场景,单眼2K 90Hz就够用,能把成本降下来,把稳定性做好,比什么都强。