拆而不碎:微服务架构设计的核心边界
很多人做拆分的第一反应,就是按着业务模块一刀切,切完上线才发现,调用链绕得像缠了三个月的耳机线,出问题排查要走十几个节点,改一个小需求要动三个服务,运维成本涨了三倍,性能还掉了一半。
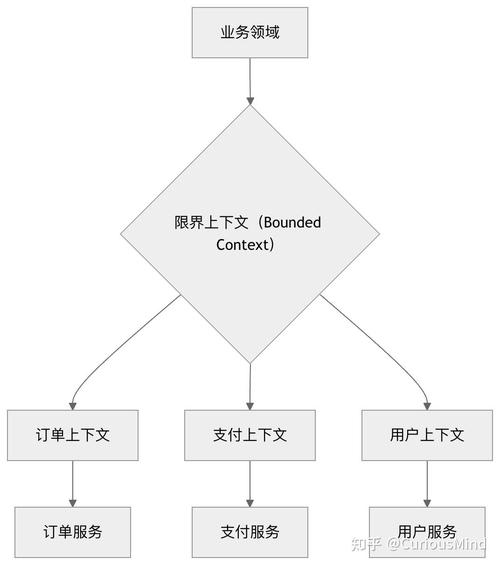 DDD限界上下文微服务拆分示意图
拆分的核心逻辑从来不是把代码分到不同仓库,而是把变化频率一致、上下文边界清晰的逻辑圈在一起。改支付规则的时候,不需要碰商品库存的代码,新增营销活动的时候,不会影响下单核心流程,这才是拆分的意义。
如果两个服务总是要一起发版,改一个需求必须同时改两个服务,那就是拆错了。别为了凑“微服务”的概念硬撑,宁愿暂时合回去,等业务真的走到那一步再拆,也比现在留下一堆烂摊子强。
不少人迷信粒度越细越好,把一个简单的内容管理拆成七八个服务,最后连开发环境启动都要等十几分钟,纯粹是给自己找麻烦。
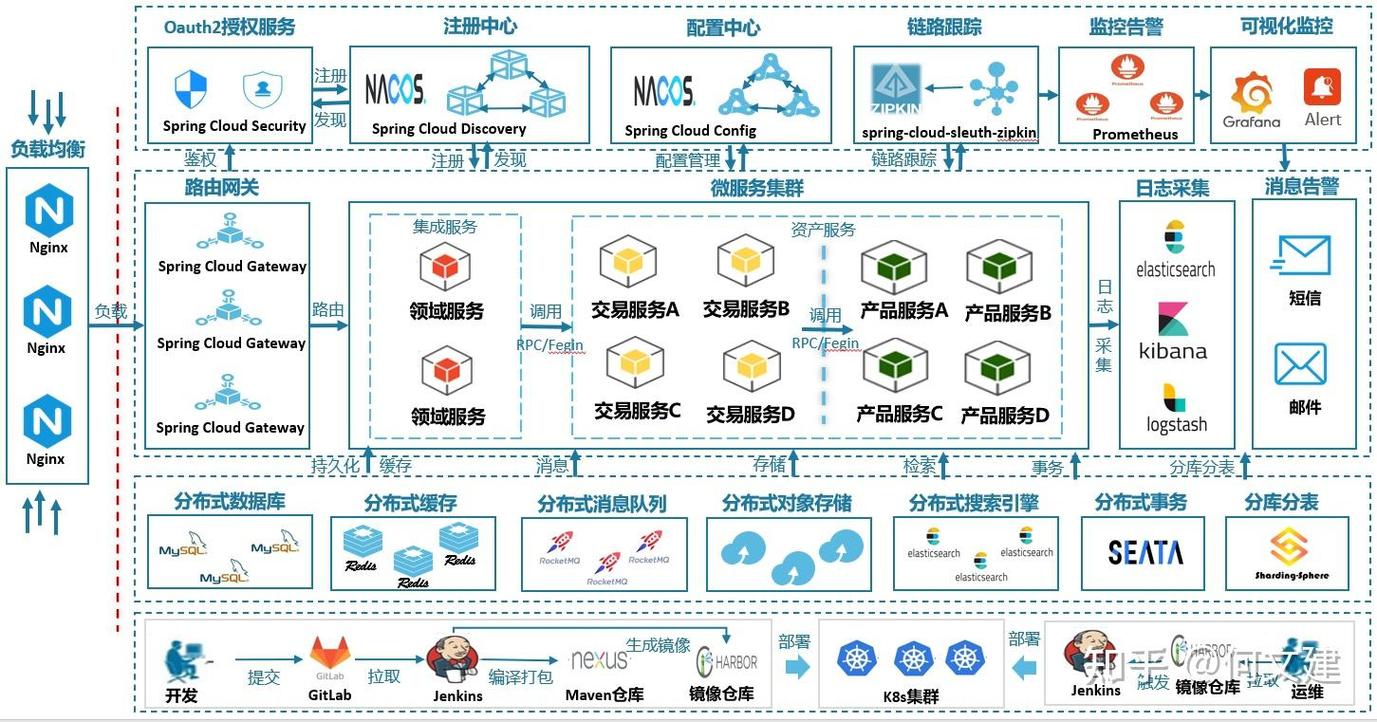 微服务分布式事务方案选型对比图
任何方案都有应用边界。如果你的核心业务要求强一致,比如金融的扣款记账,那要么把强一致的逻辑放到同一个服务里,要么就上可靠的分布式事务方案,不能含糊。如果只是商品上下架和用户积分发放这种逻辑,不一致个三五分钟根本不会影响用户体验,直接发个异步消息就行,没必要非要追求百分之百的实时一致。
还有个误区,就是服务拆分必须拆数据库。我见过不到一万行核心代码的项目,拆成三个服务分了三个库,连个简单的关联查询都要跨服务调用,开发效率直接掉了一半,真的没必要。拆库是数据库性能撑不住了才要做的事情,不是为了拆分而拆分,别把手段当成了目标。
不过话说回来,该拆的时候不拆,也会出问题。之前有个做同城配送的项目,高峰期单量涨了五倍,单体数据库扛不住,又没提前做拆分,最后临时扩容花了整整一周,错过一波大流量,损失不小。
 容错不是加个熔断就万事大吉
现在大家都知道加熔断降级,随便找个开源框架配置一下参数,就觉得容错做好了。很多人配置的降级逻辑就是直接返回空或者抛错误,结果一个非核心服务挂了,把整个核心链路拖垮,用户一打开页面全是报错,直接就走了。
容错的核心,是降级对业务无害,而不是单纯的切断调用。举个例子,你打开商品详情页,推荐服务挂了,那大不了不展示推荐位,总不能让整个商品详情页都打不开吧?做个兜底缓存,把热门商品的推荐数据存在本地,就算远程服务挂了,也能返回旧数据凑合用,比直接报错强一百倍。
还有很多人不做依赖优先级排序,一个核心支付服务,硬生生依赖了积分、营销、标签三个非核心服务,随便一个挂了,支付就用不了,出故障的时候直接损失真金白银。这种问题本质就是架构设计的时候没理清主次,把非核心逻辑绑在了核心流程上。
合理的依赖逻辑很简单,核心服务尽量少依赖,非核心依赖允许出问题,弱依赖全部异步加载,别把所有服务绑在一艘船上。哪怕一个沉了,其他的还能正常跑。
现在行业里一会儿说微服务过时,一会儿说单体复活,其实哪有什么绝对的对错。技术本来就是解决问题的工具,你的团队几十上百人,代码上百万行,一个单体改一次要等半小时编译,那拆分肯定是对的。你十几个人小团队,业务还在快速试错,那一个单体跑着香得很,没必要硬凑微服务的热闹。
拆对了,拆得刚刚好,就是好设计。拆错了,为了概念硬拆,再时髦的架构也是坑。
拆分不是切蛋糕,是找血管
很多团队拆分的依据,要么是部门划分,要么是功能名称,硬生生把逻辑切开。就说我之前接触的一个电商项目,仅仅因为两个团队各管一块,就把用户中心拆成了用户账号和用户画像两个独立服务,结果每次下单要跨服务调两次接口,改个用户等级要发两个事件,出问题的时候两边甩锅,定位个bug花了整整一天。DDD限界上下文微服务拆分示意图
拆分的核心逻辑从来不是把代码分到不同仓库,而是把变化频率一致、上下文边界清晰的逻辑圈在一起。改支付规则的时候,不需要碰商品库存的代码,新增营销活动的时候,不会影响下单核心流程,这才是拆分的意义。
如果两个服务总是要一起发版,改一个需求必须同时改两个服务,那就是拆错了。别为了凑“微服务”的概念硬撑,宁愿暂时合回去,等业务真的走到那一步再拆,也比现在留下一堆烂摊子强。
不少人迷信粒度越细越好,把一个简单的内容管理拆成七八个服务,最后连开发环境启动都要等十几分钟,纯粹是给自己找麻烦。
分布式事务不是洪水,是要选对船票
现在行业里有种奇怪的风气,一讲拆分就要谈CAP,就要上最终一致性,好像不用Saga或者TCC就是不合格的架构。说实话,我见过太多创业团队,QPS连一万都不到,非要搞复杂的分布式事务流程,本来一次本地事务能搞定的逻辑,非要拆成四五个事件监听,出了问题回滚都找不到节点,平白多出无数bug。微服务分布式事务方案选型对比图
任何方案都有应用边界。如果你的核心业务要求强一致,比如金融的扣款记账,那要么把强一致的逻辑放到同一个服务里,要么就上可靠的分布式事务方案,不能含糊。如果只是商品上下架和用户积分发放这种逻辑,不一致个三五分钟根本不会影响用户体验,直接发个异步消息就行,没必要非要追求百分之百的实时一致。
还有个误区,就是服务拆分必须拆数据库。我见过不到一万行核心代码的项目,拆成三个服务分了三个库,连个简单的关联查询都要跨服务调用,开发效率直接掉了一半,真的没必要。拆库是数据库性能撑不住了才要做的事情,不是为了拆分而拆分,别把手段当成了目标。
不过话说回来,该拆的时候不拆,也会出问题。之前有个做同城配送的项目,高峰期单量涨了五倍,单体数据库扛不住,又没提前做拆分,最后临时扩容花了整整一周,错过一波大流量,损失不小。
容错不是加个熔断就万事大吉
容错不是加个熔断就万事大吉
现在大家都知道加熔断降级,随便找个开源框架配置一下参数,就觉得容错做好了。很多人配置的降级逻辑就是直接返回空或者抛错误,结果一个非核心服务挂了,把整个核心链路拖垮,用户一打开页面全是报错,直接就走了。
容错的核心,是降级对业务无害,而不是单纯的切断调用。举个例子,你打开商品详情页,推荐服务挂了,那大不了不展示推荐位,总不能让整个商品详情页都打不开吧?做个兜底缓存,把热门商品的推荐数据存在本地,就算远程服务挂了,也能返回旧数据凑合用,比直接报错强一百倍。
还有很多人不做依赖优先级排序,一个核心支付服务,硬生生依赖了积分、营销、标签三个非核心服务,随便一个挂了,支付就用不了,出故障的时候直接损失真金白银。这种问题本质就是架构设计的时候没理清主次,把非核心逻辑绑在了核心流程上。
合理的依赖逻辑很简单,核心服务尽量少依赖,非核心依赖允许出问题,弱依赖全部异步加载,别把所有服务绑在一艘船上。哪怕一个沉了,其他的还能正常跑。
现在行业里一会儿说微服务过时,一会儿说单体复活,其实哪有什么绝对的对错。技术本来就是解决问题的工具,你的团队几十上百人,代码上百万行,一个单体改一次要等半小时编译,那拆分肯定是对的。你十几个人小团队,业务还在快速试错,那一个单体跑着香得很,没必要硬凑微服务的热闹。
拆对了,拆得刚刚好,就是好设计。拆错了,为了概念硬拆,再时髦的架构也是坑。