藏在冗余里的底气:重新理解抗风险技术设计
被错放的定位:从补丁到原生
业界最早的相关实践,其实起源于航天工程。上世纪六十年代的阿波罗登月计划,敢把人送到38万公里外,靠的不是赌元器件100%不出错,而是在核心控制模块里提前留了三倍的冗余计算单元——只要有一个模块坏了,剩下的能立刻顶上去,整个系统不会停摆。
说实话,现在绝大多数互联网系统的设计逻辑,还是反过来的。先做正常流程,跑通用户可用的核心路径,剩下的再说风险的事。
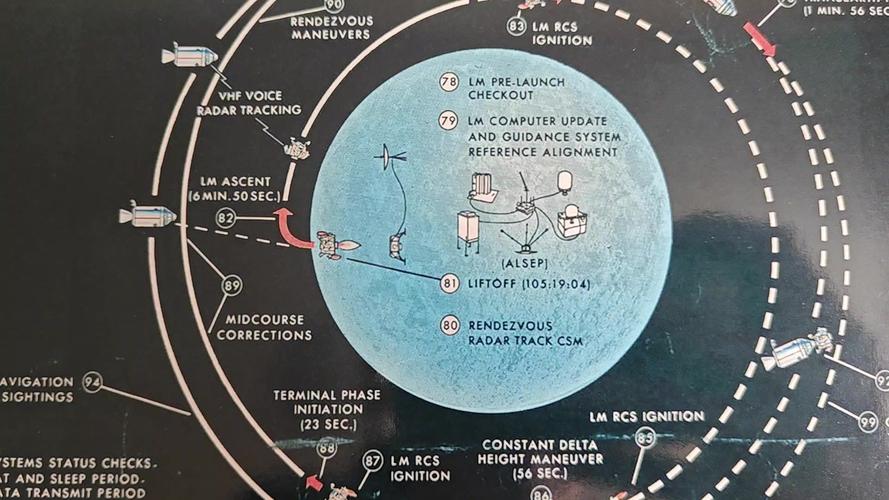 Apollo登月计划控制模块冗余设计图
这种逻辑做小项目没问题,一旦你的系统要承载千万级用户,或者涉及资金、生命安全相关的业务,就是裸奔。
去年我接触过一个做同城生鲜配送的团队,高峰的时候单量突然翻了六倍,本来预留的缓存顶不住,数据库直接挂了,整个平台停了四个小时,老用户流失了快三成。事后复盘,CTO说当时觉得加读写分离和灾备实例要多花三十万服务器钱,想着反正大促才几次,忍忍就过去了。
结果一次出事,亏的钱是这点成本的几十倍。
原生设计的核心,是从需求阶段就把"风险发生的概率"算进去,而不是出了问题再补窟窿。很多人觉得加冗余会推高成本,其实算上故障发生后的损失,原生设计的平均成本反而更低。
核心逻辑:容纳风险而非消除风险
没有人能消除所有风险。黑天鹅之所以叫黑天鹅,就是因为你根本预判不到它会从哪冒出来。
抗风险设计的本质,从来不是"不让风险发生",而是"风险发生之后,系统不会彻底死掉"。
比如说,现在云服务商常用的多可用区部署,就是把你的服务同时跑在地理位置隔开的两个机房里。如果其中一个因为地震、火灾断电了,DNS解析会自动把流量切到另一个,整个过程用户几乎无感知。
反过来,很多中小团队把所有服务都放同一个可用区,看起来省了钱,只要机房出一次维护事故,就是全挂。
还有芯片设计里的热冗余,晶圆生产出来总会有几个核心坏了,高端芯片会直接把坏的核心屏蔽掉,用剩下的好核心继续出厂,不会因为一两个坏点就直接报废整个晶圆。这也是典型的思路。
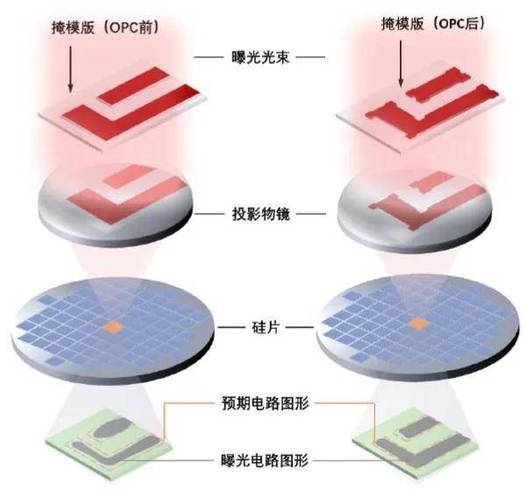 芯片晶圆坏核屏蔽修复示意图
不过话说回来,这个思路也不是万能的。它有一个核心前提:你得把系统拆成足够小的独立模块,一个模块出问题,不会牵连整个系统崩掉。
很多单体应用,整个业务逻辑都揉在一个进程里,哪怕你留了冗余,只要核心进程挂了,整个系统还是没了。这个道理说出来人人都懂,但真到做的时候,多少团队为了快,就是这么堆代码的对吧?
我见过最夸张的,一个做政务系统的项目,整个几百万行代码都在一个git仓库里,上线五年没人敢动核心逻辑,一出问题就是全员加班排查,折腾一周才能好。这种设计,再怎么补风险补丁,都是治标不治本。
踩过坑才懂的应用边界
 踩过坑才懂的应用边界
我见过太多团队走极端,为了做抗风险,堆了一堆冗余,最后反而把自己玩死了。
去年某股份制银行做灾备升级,为了够"安全",硬生生做了五级异地灾备,每一级切换都要走三个部门的审批流程,从支行行长到科技部总经理签字才能切。去年上半年他们主机房出了线路故障,等审批走完,已经停了两个多小时,比没做灾备的时候损失还大。
过度设计的风险,一点都不比不做设计小。你加的每一层冗余,都会带来额外的复杂度,额外的运维成本,甚至额外的故障点。
比如说,你为了抗缓存击穿,加了两层缓存,第一层挂了切第二层,那你就要考虑两层缓存的数据一致性问题,就要做额外的同步机制,这个同步机制本身就可能出问题。
那度在哪?
核心的判断标准其实很简单:风险的影响程度,要和冗余的成本匹配。如果一个小功能出问题,只会影响千分之一的用户,也不会带来资金损失,你没必要给它做三层灾备,留个降级开关,出问题关了就行,不影响核心业务。
如果是核心支付、核心交易链路,那哪怕多花一倍的成本,也要把冗余做足,做多路备份,做自动切换。
现在的新趋势,其实是从静态冗余往动态弹性演变。以前你得提前预留好冗余的容量,不管用不用都得付钱,现在云原生时代,可以根据流量动态弹性扩容,平时不用的容量可以随时释放,既降低了成本,也能扛住突发的流量冲击。还有混沌工程,主动往系统里注入小故障,测试系统的抗风险能力,把问题提前曝出来解决,比真出大事了再救强多了。
哦对了,别觉得这只是互联网或者高科技行业才要考虑的事。开个实体店,你留个备用的收款码,留个手动记账的本子,万一POS机坏了网络断了,你照样能收钱做生意。做制造业,你留一两个核心配件的备货,供应商断供了你也能撑到找新货源,不耽误生产。
本质上都是同一个逻辑。风险从来不会消失,它只会换个样子来找你。你提前给系统留够了底气,真出事的时候,才不会慌得手脚发麻,才能够慢慢收拾。