医学影像分割:AI砸进临床的第一块实锤
从“医生看片”到“AI帮切”,到底变了啥
你去医院拍个CT或者核磁,出来的就是一堆灰黑白的像素图。医生要找病灶,首先得把你要研究的器官、病变从周围一堆乱七八糟的组织里分出来。这个把目标区域“抠出来”的过程,就是医学影像分割。
原来全靠医生一笔一画标。就拿肝脏肿瘤来说,一个病人的CT有两三百层,一层一层画,熟练的医生也要半个多小时。一天接十个会诊,眼睛都能看出重影。
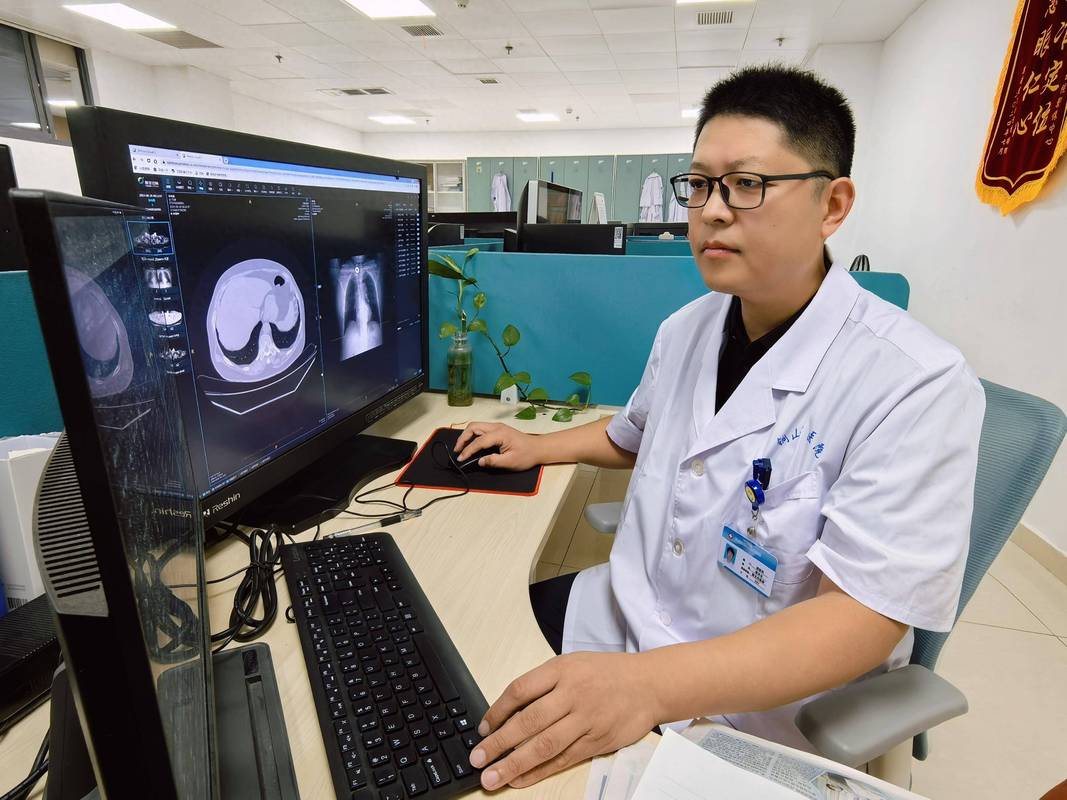 放射科医生人工标注肺部CT影像
说实话,人工分割不止慢,误差还大。同一个结节,两个医生标出来的大小能差出好几个毫米,直接影响后续的治疗方案定夺。AI进来之后呢?训练好的模型,不到十秒就能输出完整的分割结果,误差大多控制在1个毫米以内,稳定性比人工高太多。
现在很多早癌筛查,都是AI先把可疑的病灶分割出来,给医生复核,效率直接翻了十几倍。多少医生的下班时间,就是这么被救回来的。
技术迭代快,现在到底够用了吗
早在上个世纪,医学影像分割就已经起步了。那时候都是手工设计特征,什么阈值分割、区域增长,只能对付边界特别清楚、对比度特别高的病灶,稍微复杂一点就直接歇菜。直到2015年 U-Net 出来,直接把整个领域的玩法掀了个天翻地覆。
之前做深度学习分割,都需要成千上万的标注数据才能训得动,可是医学影像哪来这么多标注?U-Net设计了跳跃连接,把底层的细节特征和高层的语义特征拼在一起,很少的标注就能训出不错的结果,直接解决了医学领域数据少的痛点。直到现在,大部分落地的医学影像分割模型,背后还是U-Net的变种。
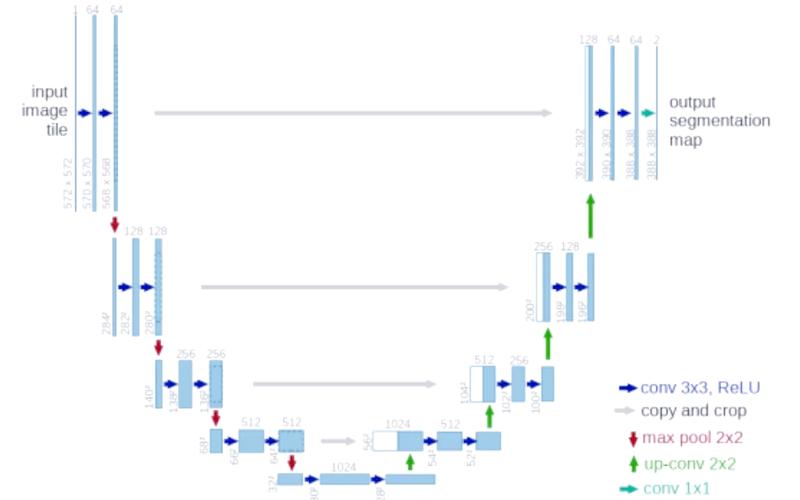 U-Net医学影像分割网络结构示意图
最近几年更热闹了,transformer架构进来,又搞出来一堆性能更好的分割模型。就连OpenAI那个大火的“分割一切”SAM,都有人快速改出了Med-SAM,专门做医学影像分割,刷了好几个公开数据集的榜。
不过话说回来,榜上面的分数好看,不代表临床能用。我见过太多模型,在公开数据集上准确率能到98%,换一个医院不同机器拍的片子,准确率直接掉到70%多,切出来的病灶缺一块少一块,医生还得手动改。
对吧?数据分布不一样啊。你用一线城市大医院的机器拍的CT训练,拿到基层医院老机器拍的片子,对比度、噪声全不一样,模型哪见过这个。通用模型就是这点不好,水土不服是常态。现在拿到国内NMPA三类证的产品,都是针对特定病灶、特定机型优化了好几年的,野路子出来的模型真比不了。
卡脖子的痛点,还是那两个老问题
 卡脖子的痛点,还是那两个老问题
第一个,像素级标注太贵了。
想要训一个好的分割模型,就得有大量像素级的标注。一个资深放射科医生,标一个3D的肝脏CT,要四十分钟以上,按医生的时薪算,一个样本的标注成本就大几百。做一个通用器官分割模型,需要几万样本,这成本,没点融资根本扛不住。更坑的是,很多罕见病灶,根本就没那么多病例给你标,巧妇也难为无米之炊。
第二个,临床适配性差。
很多科研人员做模型,就盯着公开数据集刷榜,根本不去临床看医生实际怎么干活。我之前听过一个事儿,某个创业公司做了一个脑肿瘤分割的模型,找医院试点,主任用了一次就不用了。为什么?模型输出的分割结果,只能在AI自己的工具里看,不能直接导进医院的PACS系统,医生要来回切换软件,反而更麻烦。还有的模型,切出来的轮廓有好多小锯齿,医生要修半天,还不如自己画快。
现在学界也在想办法解决。半监督、弱监督分割就是大热门,你不用给每个像素都标,只要给个框、标几个点就能训模型,标注成本直接降了十分之九都不止。还有联邦学习,多个中心不用交换原始数据,就能一起训模型,既解决了数据隐私的问题,又能让模型见过不同中心的数据,泛化性一下子就上去了。
不过这些技术,大多还在科研临床试验阶段,真正大规模落地的还没几个。路还长着呢。
现在不少人吹AI要替代医生,至少在医学影像分割这块,我们的目标从来不是替代,是给医生打辅助。把医生从最枯燥最累的手工标注里解放出来,让他们把时间花在更重要的诊断和治疗上。这就够了。
最近两年,越来越多针对不同病灶的医学影像分割AI产品拿证进院,能看出来,这块是真的落地了。接下来,肯定还有更多惊喜等着我们。