硅基迷宫里的新出口:类脑芯片研发的冷思考
去年秋天在南京浦口的一个小型学术沙龙上,听一个做流片的老教授拍桌子骂,说现在好多做概念的,把FPGA搭个神经元网络就敢叫类脑原型,骗经费骗流量,把真正做落地的路都带歪了。当时没太在意,今年看了好几份产业报告才回过味来——这话没错。
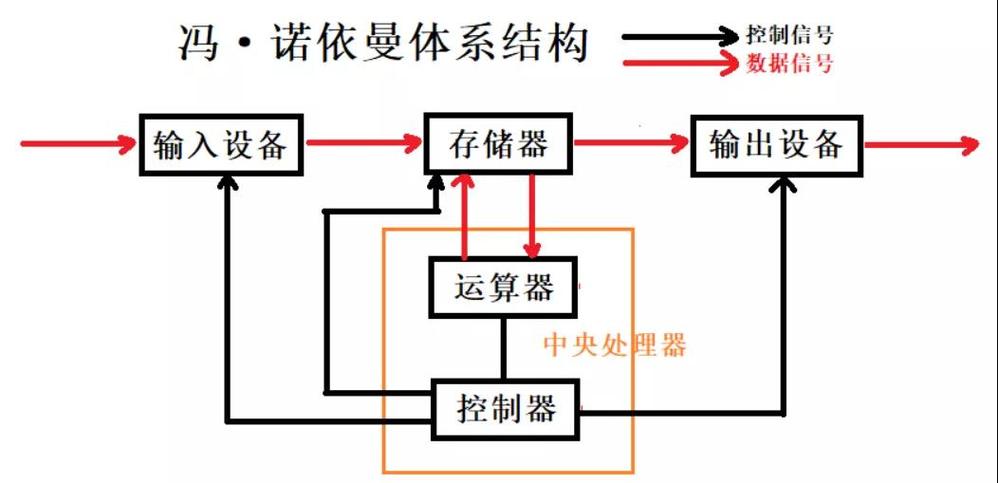 传统冯诺依曼架构存储墙原理示意图
不过话说回来,把生物脑的逻辑搬到硅基上,哪有那么容易。太多人只看到了“仿生”的噱头,没看到骨头里的难点。
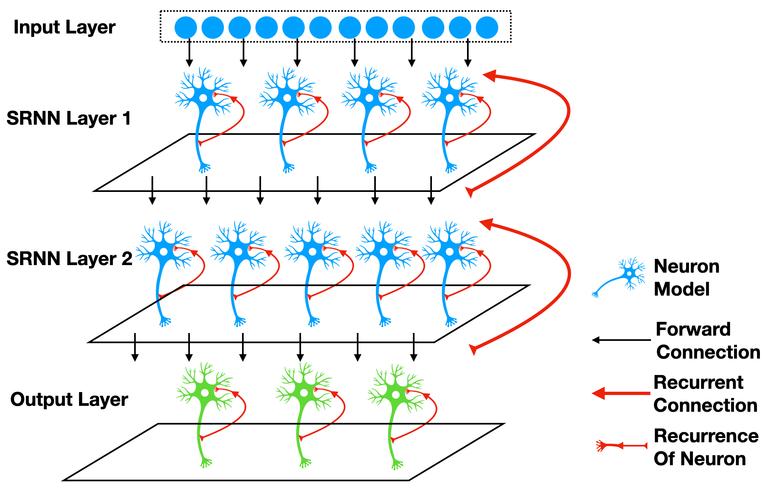 脉冲神经网络类脑芯片神经元连接布局图
器件层面的坑更多。现在主流的技术路线分两条,各有各的限制:一条是用已经成熟的CMOS工艺做全数字类脑,好处是良率高,容易做大规模神经元阵列,问题是异步逻辑设计难度极高,大部分团队还是离不开全局时钟,事件驱动的优势根本发挥不出来;另一条是用新兴器件比如忆阻器做模拟类脑,忆阻器本身就能同时实现存储和计算,天然符合类脑的需求,问题是忆阻器的器件一致性太差,良率上不去,现在流片一片一百万神经元规模的忆阻器芯片,坏损率能到一成以上,就算加上冗余修复,精度掉得也没法满足商用需求。
还有第三条混合路线,数字加模拟各取所长,可设计复杂度直接翻了一倍,流片成本也涨得吓人,中小团队根本玩不起。
 看得见的前景,踩得到的坑
现在圈子里最歪的风气,就是一开口就是颠覆现有计算体系,就要替代GPU替代CPU,仿佛明天就能把传统芯片都扫进垃圾堆。这都是吹给资本听的鬼话。
至少未来十年,类脑都不可能在通用计算领域撼动传统架构的位置。它的优势从来都不是大规模模型训练,也不是通用高性能计算,它的主场天生就在低功耗边缘端,在对延迟和功耗有极致要求的细分场景。
比如植入式脑机接口,芯片要连续处理颅内脑电信号,整体功耗不能超过1毫瓦,传统芯片根本做不到,类脑就有可能啃下这块硬骨头;比如野外部署的生态监测传感器网,一块电池要撑三五年,还要实时处理图像和声纹信号,传统AI芯片功耗扛不住,类脑就能适配这个场景。
错把通用性当目标,才是现在很多研发走歪的核心原因。明明是适合做低功耗边缘感知的路线,非要赶大模型的风口,硬说自己能跑百亿参数大模型,最后算下来功耗比GPU还高,除了骗一轮融资,什么用都没有。
更大的风险在泡沫,现在资本太热,什么阿猫阿狗挂个类脑的牌子就能拿到钱,都不用流片,只画个PPT就能吹成技术突破,等潮水退了,裸泳的人现形,反而会让资本对整个方向失去信心,坑了真正埋头填坑的团队。
最务实的路径,其实从来都不是喊口号,而是扎进具体的细分场景,针对需求一点点优化。做脑电处理就专门优化脉冲编码对生物神经信号的适配,做机器人触觉感知就专门优化事件驱动的低延迟特性,先做出能用、好用的产品,把优势验证出来,再谈升级和扩张。
沙龙上那个老教授最后说,生物脑进化了几亿年才变成现在的样子,我们才仿了不到三十年,哪那么容易就搞出颠覆性的成果。现在能做的,就是一个坑一个坑往前填,把编码的坑填了,把器件的坑填了,把良率的坑填了,走着走着,说不定就真的在硅基迷宫里,走出一条完全不一样的新路。
哪有那么多一蹴而就的革命。都是熬出来的。
冯诺依曼墙不是玄学,是真卡脖子
现在的AI芯片不管是GPU还是专用ASIC,本质还是冯诺依曼架构,计算和存储物理分开。存储墙不是学术界造出来骗经费的词,是真真切切每个做端侧AI的人都要碰的南墙。 你拿旗舰手机跑离线大模型,十分钟掉电15%,不是电池容量做不大,是超过九成的功耗都耗在了存储单元和计算单元之间来回搬数据上,真正用在计算上的电还不到十分之一。 卡了快十年了。 摩尔定律放缓之后,这个问题被放大得无以复加,我们不能靠堆晶体管堆出指数级的性能提升了,只能往架构找新路。这个时候类脑方向才从实验室的边角料,变成了产学研都盯着的核心赛道,不是资本炒出来的风口,是被逼出来的出口。 生物脑的整体功耗才二十多瓦,就能处理比顶尖超级计算机还复杂的感知、认知、推理任务,核心逻辑就是神经元靠脉冲传递信息,存储和计算都在突触连接上完成,根本不需要专门搬数据。这个能效比,是传统架构想都不敢想的。传统冯诺依曼架构存储墙原理示意图
不过话说回来,把生物脑的逻辑搬到硅基上,哪有那么容易。太多人只看到了“仿生”的噱头,没看到骨头里的难点。
仿生不是画皮,要仿到骨子里
现在不少公开的原型产品,其实只是把人工神经元做成了可复用IP核,本质还是传统的同步数字计算,所谓脉冲也是用时钟模拟出来的,根儿上就没摆脱冯诺依曼的框架,自然发挥不出类脑的优势。 说实话,我见过不少公开Demo,跑个简单的手写数字识别任务,功耗比同制程的传统AI芯片还高30%,这不是挂羊头卖狗肉吗? 真正的类脑核心,是脉冲神经网络的异步事件驱动机制,只有让神经元只在收到有效脉冲的时候才工作,只有把存储和计算真正整合在突触单元里,才能把功耗降到传统芯片达不到的水平。 但就是最基础的脉冲编码,现在都没找到完美的解法。怎么把连续的视觉、听觉、神经电信号转换成低冗余的脉冲序列,现有的方法要么损失大量精度,要么编码过程本身就耗掉了大半功耗,进退两难。脉冲神经网络类脑芯片神经元连接布局图
器件层面的坑更多。现在主流的技术路线分两条,各有各的限制:一条是用已经成熟的CMOS工艺做全数字类脑,好处是良率高,容易做大规模神经元阵列,问题是异步逻辑设计难度极高,大部分团队还是离不开全局时钟,事件驱动的优势根本发挥不出来;另一条是用新兴器件比如忆阻器做模拟类脑,忆阻器本身就能同时实现存储和计算,天然符合类脑的需求,问题是忆阻器的器件一致性太差,良率上不去,现在流片一片一百万神经元规模的忆阻器芯片,坏损率能到一成以上,就算加上冗余修复,精度掉得也没法满足商用需求。
还有第三条混合路线,数字加模拟各取所长,可设计复杂度直接翻了一倍,流片成本也涨得吓人,中小团队根本玩不起。
看得见的前景,踩得到的坑
看得见的前景,踩得到的坑
现在圈子里最歪的风气,就是一开口就是颠覆现有计算体系,就要替代GPU替代CPU,仿佛明天就能把传统芯片都扫进垃圾堆。这都是吹给资本听的鬼话。
至少未来十年,类脑都不可能在通用计算领域撼动传统架构的位置。它的优势从来都不是大规模模型训练,也不是通用高性能计算,它的主场天生就在低功耗边缘端,在对延迟和功耗有极致要求的细分场景。
比如植入式脑机接口,芯片要连续处理颅内脑电信号,整体功耗不能超过1毫瓦,传统芯片根本做不到,类脑就有可能啃下这块硬骨头;比如野外部署的生态监测传感器网,一块电池要撑三五年,还要实时处理图像和声纹信号,传统AI芯片功耗扛不住,类脑就能适配这个场景。
错把通用性当目标,才是现在很多研发走歪的核心原因。明明是适合做低功耗边缘感知的路线,非要赶大模型的风口,硬说自己能跑百亿参数大模型,最后算下来功耗比GPU还高,除了骗一轮融资,什么用都没有。
更大的风险在泡沫,现在资本太热,什么阿猫阿狗挂个类脑的牌子就能拿到钱,都不用流片,只画个PPT就能吹成技术突破,等潮水退了,裸泳的人现形,反而会让资本对整个方向失去信心,坑了真正埋头填坑的团队。
最务实的路径,其实从来都不是喊口号,而是扎进具体的细分场景,针对需求一点点优化。做脑电处理就专门优化脉冲编码对生物神经信号的适配,做机器人触觉感知就专门优化事件驱动的低延迟特性,先做出能用、好用的产品,把优势验证出来,再谈升级和扩张。
沙龙上那个老教授最后说,生物脑进化了几亿年才变成现在的样子,我们才仿了不到三十年,哪那么容易就搞出颠覆性的成果。现在能做的,就是一个坑一个坑往前填,把编码的坑填了,把器件的坑填了,把良率的坑填了,走着走着,说不定就真的在硅基迷宫里,走出一条完全不一样的新路。
哪有那么多一蹴而就的革命。都是熬出来的。