从代码到决策:自主系统研发绕不开的三道坎
看不见的边界:自主不是“放飞自我”
很多人对这类系统的最大误解,就是把“自主”等同于把所有决策权完全交给机器,不需要人插手。实际上,任何能落地的系统,都必须有清晰的决策边界——什么情况可以自己决策,什么情况必须立刻移交人工,规则写得死死的,不能有半点模糊。
举个最常见的例子,开放道路的场景,结构化高速路车道线清晰,车流稳定,车速变化小,完全可以放开让系统自己运作;但进了没有统一标线的老城区,路边有流动摊贩,路口有乱跑的非机动车,随时可能窜出来一个横穿马路的行人,这就是预设边界之外的场景,必须第一时间提示驾驶员接管。
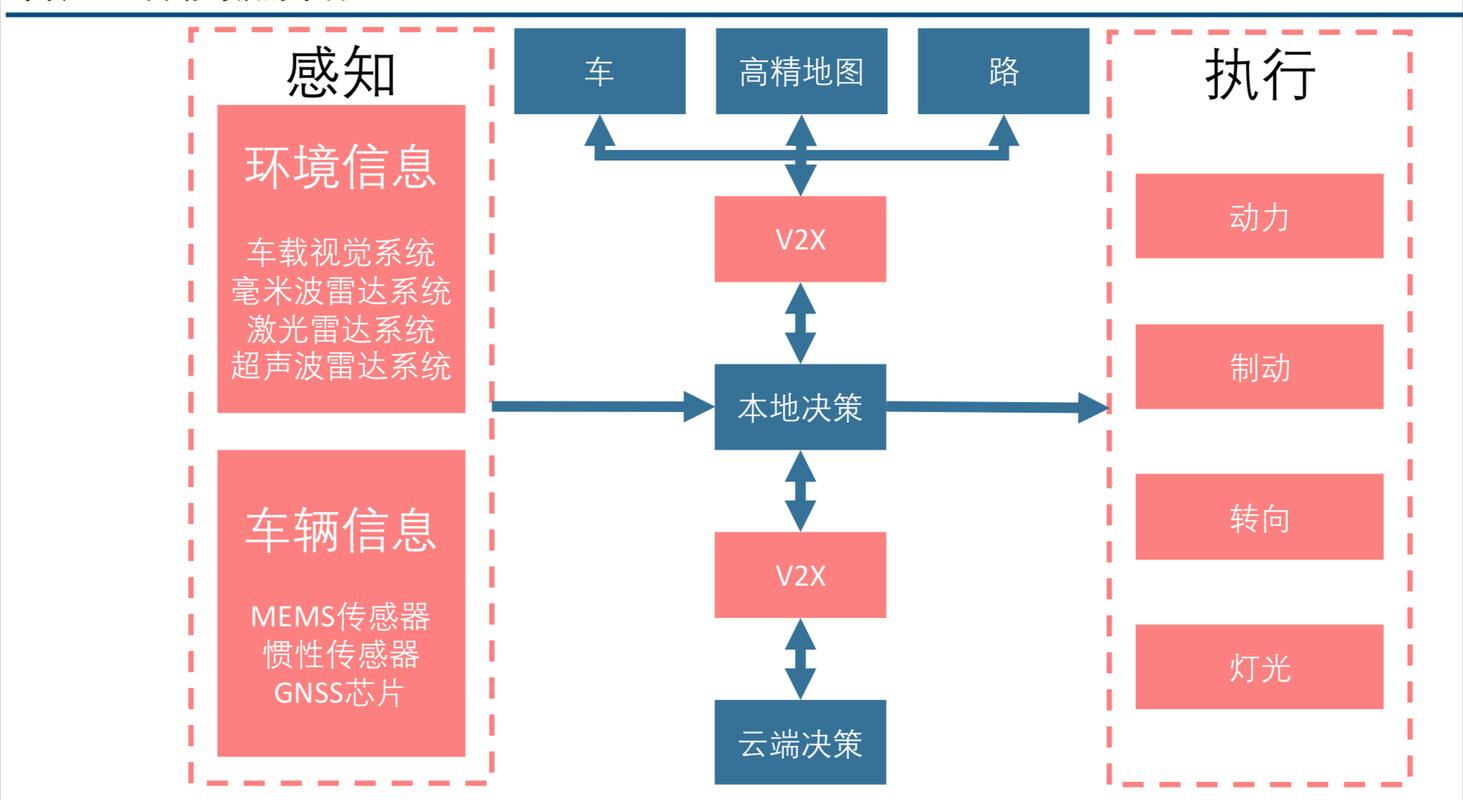 自动驾驶自主系统决策边界划分示意图
很多研发踩的第一个坑,就是在这里。为了凑概念、博关注度,故意模糊边界,喊出“全场景全自主”的口号,真到落地的时候,遇到边界外的异常,就是实打实的事故。去年北方某港口发生的自动集卡撞桥事故,溯源下来就是系统把逆光下轮廓模糊的桥柱,判定成了空无一物的开放道路,边界触发规则没有写死,才酿成了损失。
说实话,现在很多拿融资的概念验证项目,都在这一步偷懒。把边界留得大到没边,仿佛机器真的能搞定一切,骗一波热度可以,真要落地商用,根本站不住脚。
这就是第一关。过不了,再漂亮的demo都是摆设。
脆弱的鲁棒性:原型机为什么怕“脏数据”
过了边界这一关,第二个坑就在鲁棒性这里等着你。实验室里做测试,数据都是提前洗好、标注整齐的,就像高考前给你划了所有重点,考一百分一点都不奇怪。到了真实的生产场景,全是没出过的偏题怪题,根本没在训练集里出现过。
做快递分拣的团队应该都有这个体会,训练数据里的包裹都是方方正正、面单清晰的,实际分拣线上,有揉成一团的黑色快递袋,有沾水发软透了的纸箱,有贴了两层面单的退件,还有包裹表面反光根本扫不出码的,这些异常样本在训练集里占比往往不到1%,系统见得少,根本认不出来,一遇到就卡壳。
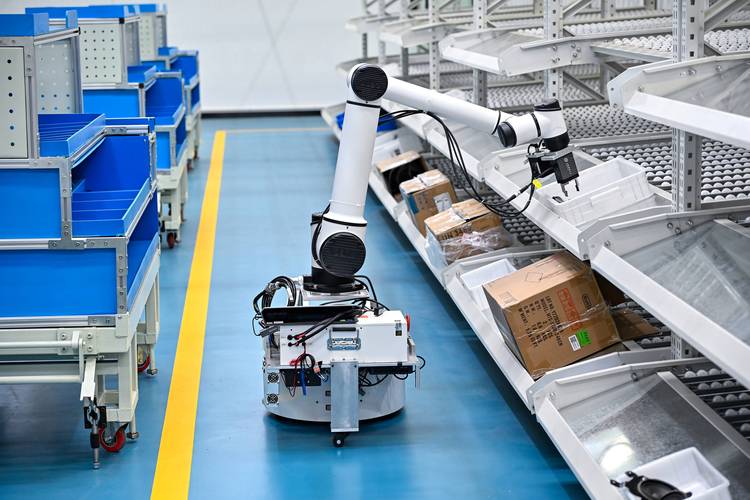 工业自主快递分拣机器人脏样本测试实景图
有人说,那把这些异常样本都加进训练集不就行了?哪有这么简单。真实场景的异常是无穷无尽的,今天加了沾水的,明天就能出个冻成冰疙瘩的,后天还能有贴了广告纸的,你永远不可能把所有情况都覆盖到。
现在很多团队的思路错得离谱,拿着大模型就往里面堆,参数堆到几千亿,就觉得能把所有问题都解决了。实际上,分布外样本的识别问题,靠堆参数只能降低概率,不能根治,只是把问题藏起来了,真遇到了还是错。我见过好几个项目,测试集准确率能到99%,拉到现场跑一周,准确率直接掉到80%以下,根本没法用。
绕不开的落地路径:从人工标注到自主闭环
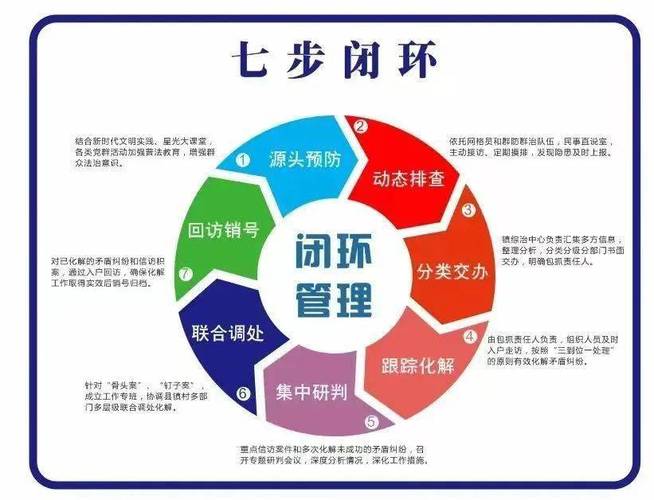 绕不开的落地路径:从人工标注到自主闭环
现在业内慢慢走通的方向,其实不是靠人穷举所有异常样本,而是给系统搭一套自主数据闭环。简单说,就是让系统自己把那些判不准、判错的样本筛选出来,只需要人给这些少量的样本做标注,快速更新模型,不停循环迭代。
还是说港口自动集卡的例子,我知道的一个团队,最早是半年更新一次模型,每次要几百个标注员整理一个月的数据,成本高,更新慢,异常问题改完,下一波新的异常又出来了。后来改成自主筛选机制,系统每天自动把自己拿不准的几千个样本挑出来,只需要两三个工程师做标注,每周就能更新一次模型,不到半年,复杂逆光场景的识别准确率从76%涨到了98%,成本降了大半,稳定性提了好几个档次。
当然,这条路也不是所有场景都通用。高风险领域比如外科手术辅助、核电设备运维,哪怕准确率到了99.99%,也必须把最终决策权留给人,自主系统只是做辅助决策,不能取代人的最终干预。应用边界卡死,才能谈安全落地。
现在业内讨论最多的风险,其实也不是技术问题,是规则问题。系统自己迭代更新了模型,出了问题,责任算研发方的还是运营方的?到现在都没有清晰的定论,很多项目卡在这里,不是技术走不通,是责任没人担。
不过话说回来,技术落地本来就是一步步趟出来的,哪有一开始就完美的规则。接下来几年,风口退了,虚的概念少了,大家自然会沉下来,在细分场景里一点点磨边界、磨闭环,磨出真正能用的东西。对吧?