韧性技术系统:为什么说它是数字化时代的"救命稻草"
别把韧性和冗余搞混了,很多人都错了
一提韧性技术系统,多数人的第一反应就是“多做几份备份呗”。这话对一半错一半。备份是冗余,不是韧性。
冗余是什么?就是我多放一份一模一样的东西在那,原来的坏了我手动切过去。韧性呢?是系统从根上就认为“我一定会出问题”,不用人动手,自己发现问题,自己绕开问题,自己修复问题,甚至坏了一部分还能接着干活,用户根本感觉不到。
 韧性技术系统与冗余系统对比图
去年河南暴雨那会我看过一个案例,运营商的核心光缆被冲断,同一个机房的备用光缆也断了——毕竟都埋在同一条沟里。原来按冗余思路做的灾备,直接全废了。用了韧性设计的区域基站呢?自动断开受损链路,把附近闲置的微波频段调出来,还发动周边正常的手机终端做Mesh自组网补盲,不到三分钟就恢复了核心区域的通信。
实话实说,现在国内百分之七十以上的企业灾备项目,都是拿着冗余当韧性卖。花了大几百万,真出事了照样歇菜。找谁说理去?
AI大模型时代,韧性技术系统成了刚需
这两年大模型火得一塌糊涂,不管是大厂还是创业公司,都在攒GPU集群搭服务。可你有没有发现,ChatGPT动不动就宕机,国内好多二三线的大模型服务,高峰时段根本连不上?
不是GPU不够,是架构没韧性。
大模型是分布式部署,少则几十个节点多则上千个,一个节点出问题,要是按原来的架构,很容易引发雪崩,流量全堵死,整个服务直接挂。韧性技术系统怎么处理?实时监控每个节点的负载和健康度,一旦发现异常,毫秒级就把流量切到空闲节点,坏节点直接隔离出来自动重启,整个过程用户连加载转圈都看不到。
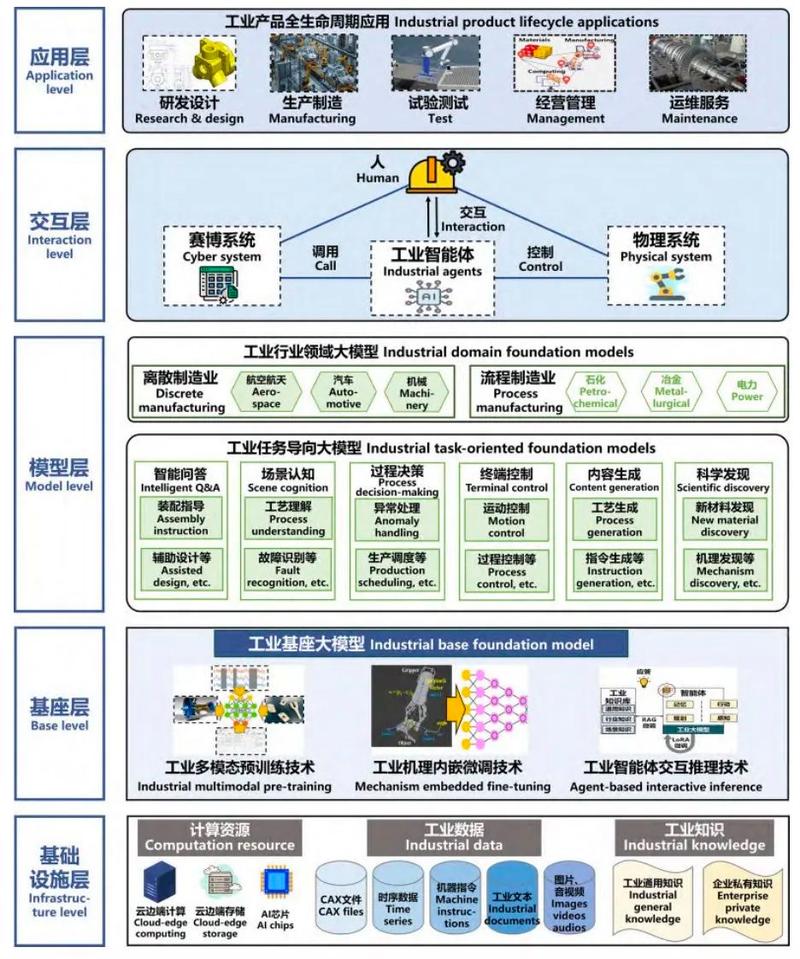 大模型集群韧性技术系统架构图
我上个月跟一个头部互联网的运维聊天,他说他们部门现在一半的KPI都跟韧性挂钩。之前做大模型内测,一次突发某个GPU节点漏液报警,换做以前整个集群都要停了排查,现在呢?系统自动切走流量,隔离坏节点,后台发个告警给运维,连夜班都不用加。
省下的精力,能多做三个功能迭代。这不香吗?
韧性不是有钱人的专利,是一种设计思路
 韧性不是有钱人的专利,是一种设计思路
很多人觉得,韧性技术系统就是给大厂准备的,中小企业花不起这钱。其实真不是。
韧性从一开始就是设计思路,不是砸钱堆设备。你做一个小电商,没必要搞三个城市的异地集群,但你可以提前设计好:要是支付接口出问题了,自动切到备用支付渠道,不用你半夜起来改代码。你做一个ToB的SaaS,没必要搞多豪华的灾备,但你可以做成分块的架构,一个客户的实例出问题,不会影响全平台的用户。
你看疫情那会的外卖平台,一下子半个城市的骑手不能接单,韧性差的平台,调度系统直接乱了,派单派不出去,用户投诉炸了。韧性好的呢?自动缩小配送范围,优先保障医院、社区的订单,自动给远单用户推延迟通知,整个系统照样转,没出大乱子。
不过话说回来,现在整个行业都在追增速,追降本,谁都不愿意花精力在这种“不出事就没用”的东西上。都觉得哪那么巧出事轮到我?
可真轮到你,一次就够了。
前几年某跨境电商大促,就是为了降本砍了冗余缓冲,结果流量超预期百分之二十,系统直接卡了四个小时,多少卖家的货没卖出去,平台亏了快一亿的营收,口碑掉了大半年才回来。
数字化走得越远,我们对技术系统的依赖就越深。一次宕机,丢的不只是订单,还有用户的信任。
毕竟,能扛事的系统,才敢接更大的活。