韧性技术系统:为什么越复杂的业务,越需要能扛事的技术底座
前阵子跟一位做电商技术的朋友吃饭,他吐槽去年大促踩的坑。花了小两百万加机器做扩容,自信满满的等订单进来,结果一个第三方推送接口挂了,连锁反应拖垮了整个下单系统,三个小时没恢复,直接亏了快一千万。他说,原来总觉得“不出事”就是好系统,现在才明白,出事之后能扛住,才是真本事。这本事,就是现在圈子里天天说的韧性技术系统。
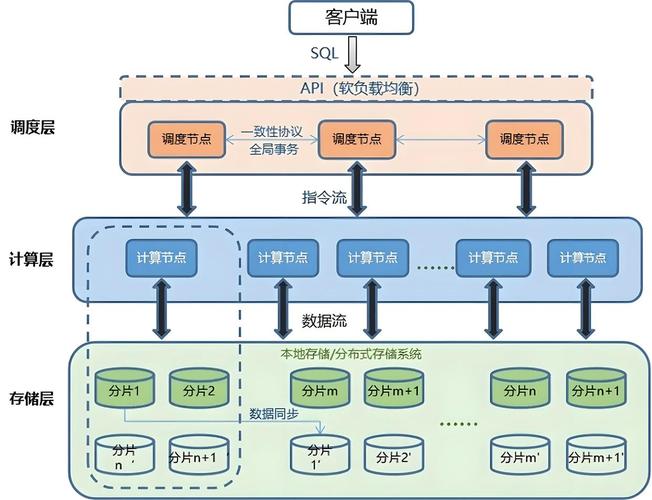 传统高可用架构与韧性技术系统对比示意图
韧性技术系统的思路从根上就不一样。它从一开始就承认:故障一定会来。你要做的不是消灭它,是别让它把整个系统带走。
比如说12306,现在春运一天几亿的访问量,你说哪个节点还没个小故障?前年我记得有一次某个区域的核心节点出问题,不到十秒就把流量切去了备用节点,核心的买票、退票业务一点没受影响,连很多用户都没感觉出来。
这就是韧性。不是不出错,是错了不影响核心,能快速兜住。说实话,很多企业花了大价钱做高可用,到头来核心业务都保不住,这不就是找错了方向吗?
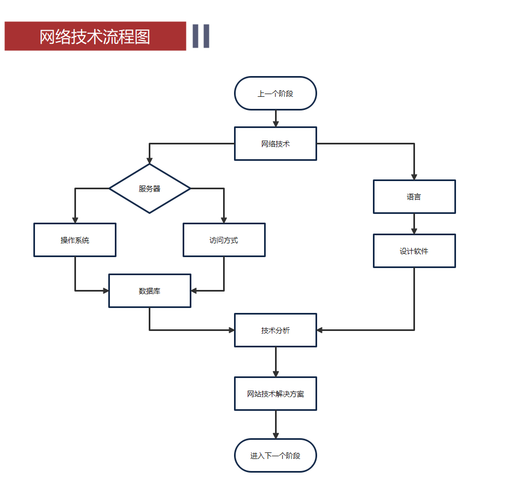 互联网企业韧性技术系统混沌演练流程图
不过话说回来,现在很多中小公司一听到“韧性建设”就觉得是大公司烧钱玩的,小公司玩不起。真不是这样。现在主流云服务商都提供现成的多可用区、故障隔离的配置,花不了多少额外的成本,你先把核心业务的隔离做好,遇到故障至少能保住命。
之前我见过一个不到一百人的SaaS公司,就是给中小企业做财务软件的,早早把核心的记账报税模块做了分舱隔离,去年他们一个云服务商某个可用区断网,别的同类型公司停了大半天,他们二十分钟就恢复了核心服务,不少客户就是冲着这个转过来的。这不是赚了吗?
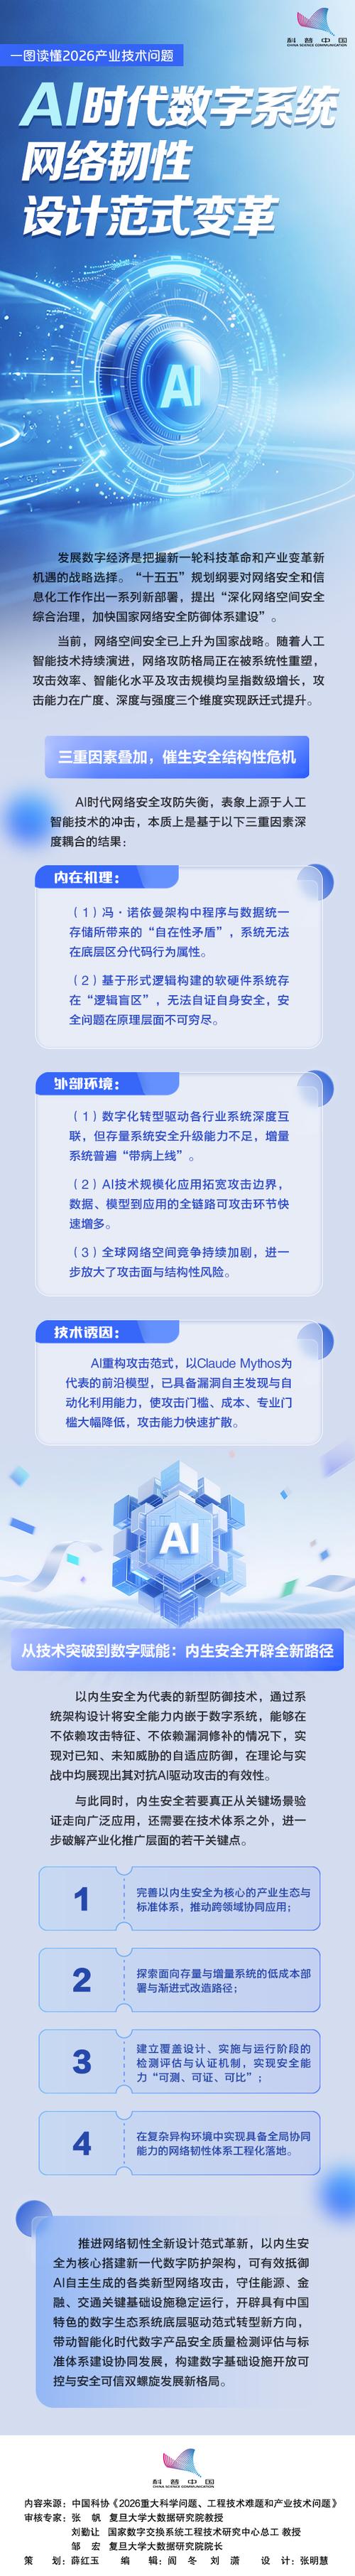 韧性会成为下一代技术系统的核心门槛
这两年大模型火了,你知道做大规模分布式训练的团队,最头疼的是什么?不是模型精度不够,是跑着跑着某一张卡坏了,整个训练任务中断,几天的进度全没了,损失几十万上百万的算力成本。
现在头部的大模型团队,全都在做训练系统的韧性设计,节点故障自动切换,任务不中断,把损失控制在几分钟以内。OpenAI之前透出来的信息,GPT-4训练的时候,韧性设计占了整个架构工作量的三成多。可见人家有多重视。
现在国内不管是做企业服务,还是做To C的互联网,甚至是金融、交通这些传统行业,都开始把韧性技术系统的建设提上日程了。中科院软件所去年发的一份行业报告说,未来三年,国内超过70%的中大型企业会把韧性建设纳入年度IT核心预算,这个风口已经起来了。
我接触过几个金融机构的技术负责人,他们说现在选系统供应商,第一个问的不是性能有多高,是你出故障之后多久能恢复,有没有韧性设计。原来拼价格拼性能,现在拼抗打击能力,这个趋势变了。
很多企业到现在还觉得,我运气好,不会出事,韧性建设能拖就拖,能省就省。真出事一次,亏的钱够你做十年韧性建设了。你说值不值?
技术发展到今天,我们早就过了追求“完美无错”的阶段了。系统越复杂,连接越多,出问题的概率就越高。真正的好系统,从来不是一辈子不摔倒。是摔了之后,爬起来的速度,比摔倒的速度还快。这就是韧性技术系统最值钱的地方。
别把“零宕机”当终极目标,韧性本来就不是为了“不出事”
原来我们做技术架构,张口就是高可用、五个九六个九,堆了一堆冗余备份,花了好多钱,可真遇上点事,该崩还是崩。 为啥?现在的系统太复杂了。微服务拆成几十个上百个模块,跨云跨机房部署,还要连一堆第三方接口,牵一发动全身,你怎么可能保证每一个环节都不出错?传统高可用架构与韧性技术系统对比示意图
韧性技术系统的思路从根上就不一样。它从一开始就承认:故障一定会来。你要做的不是消灭它,是别让它把整个系统带走。
比如说12306,现在春运一天几亿的访问量,你说哪个节点还没个小故障?前年我记得有一次某个区域的核心节点出问题,不到十秒就把流量切去了备用节点,核心的买票、退票业务一点没受影响,连很多用户都没感觉出来。
这就是韧性。不是不出错,是错了不影响核心,能快速兜住。说实话,很多企业花了大价钱做高可用,到头来核心业务都保不住,这不就是找错了方向吗?
韧性技术系统的核心,是学会和故障好好共存
前阵子看ACM分布式计算大会的最新研究,把韧性系统的设计原则归纳成了三条,头一条就是接受故障的必然性。 现在业内常用的几个实践,说出来其实很好懂。第一个就是故障分舱隔离,说白了就是把系统拆成一个个互不影响的独立舱室,一个舱进水了,别连累其他舱。就像刚才说的,第三方接口出问题,只会影响推送,别让它把下单系统带崩。第二个就是核心业务降级,真遇上大故障了,先把非核心的功能砍掉,保住核心。比如电商大促的时候,你先保住下单支付,什么推荐、收藏、评价这些,哪怕暂时用不了,也比整个站挂了强。 很多人不知道,支付宝每年都会做好几次全链路容灾演练,说白了就是故意断掉几个机房的电力,看看核心支付能不能在几十秒内切到别的机房。这个就是练韧性的。互联网企业韧性技术系统混沌演练流程图
不过话说回来,现在很多中小公司一听到“韧性建设”就觉得是大公司烧钱玩的,小公司玩不起。真不是这样。现在主流云服务商都提供现成的多可用区、故障隔离的配置,花不了多少额外的成本,你先把核心业务的隔离做好,遇到故障至少能保住命。
之前我见过一个不到一百人的SaaS公司,就是给中小企业做财务软件的,早早把核心的记账报税模块做了分舱隔离,去年他们一个云服务商某个可用区断网,别的同类型公司停了大半天,他们二十分钟就恢复了核心服务,不少客户就是冲着这个转过来的。这不是赚了吗?
韧性会成为下一代技术系统的核心门槛
韧性会成为下一代技术系统的核心门槛
这两年大模型火了,你知道做大规模分布式训练的团队,最头疼的是什么?不是模型精度不够,是跑着跑着某一张卡坏了,整个训练任务中断,几天的进度全没了,损失几十万上百万的算力成本。
现在头部的大模型团队,全都在做训练系统的韧性设计,节点故障自动切换,任务不中断,把损失控制在几分钟以内。OpenAI之前透出来的信息,GPT-4训练的时候,韧性设计占了整个架构工作量的三成多。可见人家有多重视。
现在国内不管是做企业服务,还是做To C的互联网,甚至是金融、交通这些传统行业,都开始把韧性技术系统的建设提上日程了。中科院软件所去年发的一份行业报告说,未来三年,国内超过70%的中大型企业会把韧性建设纳入年度IT核心预算,这个风口已经起来了。
我接触过几个金融机构的技术负责人,他们说现在选系统供应商,第一个问的不是性能有多高,是你出故障之后多久能恢复,有没有韧性设计。原来拼价格拼性能,现在拼抗打击能力,这个趋势变了。
很多企业到现在还觉得,我运气好,不会出事,韧性建设能拖就拖,能省就省。真出事一次,亏的钱够你做十年韧性建设了。你说值不值?
技术发展到今天,我们早就过了追求“完美无错”的阶段了。系统越复杂,连接越多,出问题的概率就越高。真正的好系统,从来不是一辈子不摔倒。是摔了之后,爬起来的速度,比摔倒的速度还快。这就是韧性技术系统最值钱的地方。