抗风险技术设计:为什么大多数企业的应急预案都是摆设?
去年帮一家做独立站的跨境电商梳理系统架构,大促前三天,核心支付服务商突然因为合规问题停了对接。整个技术团队翻出去年就写好的应急预案,打开一看全是正确的废话——写着"备用支付渠道切换",却没说备用渠道的额度限制、汇率换算怎么对接,最后临时找接口亏了近两百万销售额。
说实话,这种事太常见了。
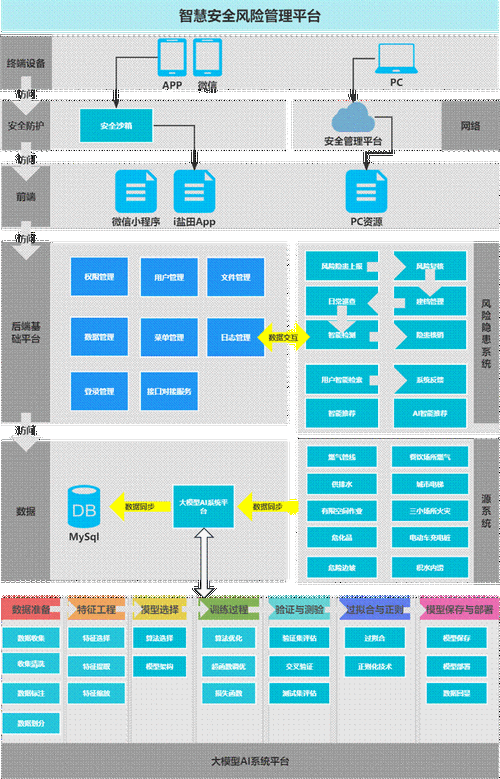 软件系统分层原生抗风险设计示意图
我去年看过北大软微实验室发布的一篇分布式系统抗风险科研成果,核心思路我印象特别深:抗风险不是外挂的补丁,是原生嵌进架构里的属性。他们做的模块隔离设计,每个业务单元自带容错能力,一个模块出问题,自动切断和其他模块的连接,根本不用人工手动切流量,整个过程不到十秒。
这不比你存个几十页的应急预案有用一万倍?
很多企业花几百万买顶级灾备服务,结果连最基础的核心业务和非核心业务拆分都没做。一次小的服务器波动,连带着官网博客一起把用户数据库拖垮,这不是笑话吗?
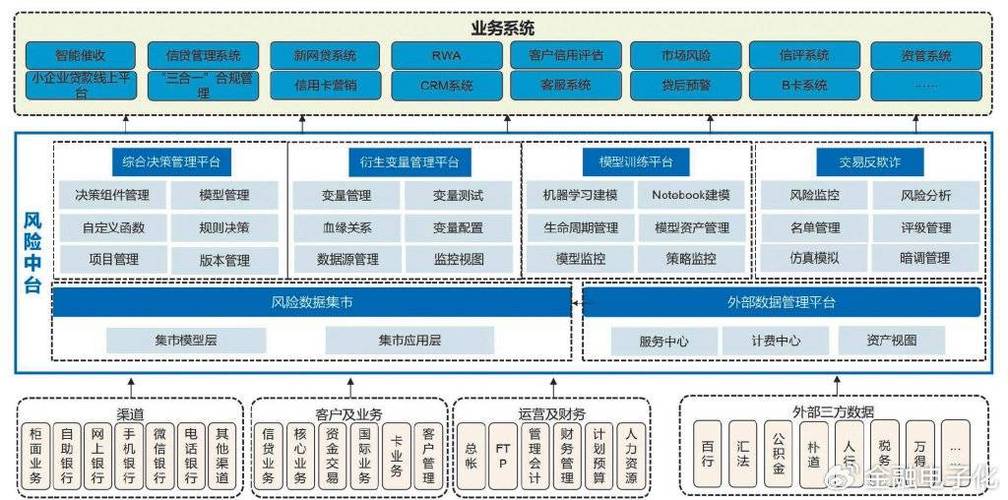 企业全链路业务抗风险节点分布图
说白了,抗风险技术设计从来不是纯技术活,是嵌进整个业务流程里的系统工程。从需求立项的时候就得考虑风险,不是技术团队最后擦屁股补补丁。
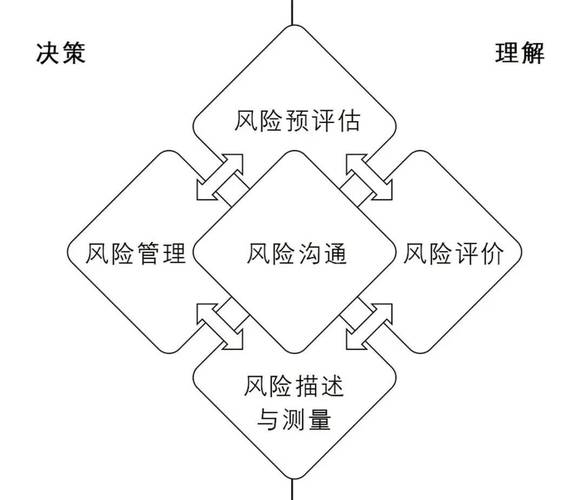 从最新科研成果看,抗风险设计的新方向
这两年AI和分布式架构起来之后,抗风险设计的思路也变了,有两个方向我觉得特别值得关注。
第一个就是动态自适应抗风险。原来的设计思路是“我预设这里会出问题,所以留个后手”,但现在风险的变化太快,你根本预设不完。今年ACM发布的最新自适应架构论文里提到的思路,就是让系统自己实时感知异常,自动调整架构,不用人提前写死规则。
举个例子,中科院计算所去年做的大模型训练集群抗风险设计,原来大模型训练的时候,一个GPU硬盘出故障,整段训练都得重来,几千块一小时的算力就打水漂了。现在他们的设计能自动隔离故障节点,把任务无缝切到空闲节点,断点续训,损失不到十分钟的算力,这省的都是真金白银。
现在多少企业忙着做大模型私有化部署,眼睛只盯着怎么把模型跑起来,根本忘了做抗风险设计。等你跑了三天,一个硬件故障全部重来,那钱烧的,心疼不心疼?
第二个方向就是轻量抗风险,适合大多数中小企业。不是谁都有国企大厂的预算做全链路灾备,对于中小公司来说,抗风险不需要搞那么复杂,只要抓住核心:把你最赚钱、最不能出问题的两三个节点,做足隔离和冗余,非核心的比如官网、内部OA,挂了就挂了,先保住命再说。
说实话,我见过太多中小公司,学着大厂的样子搞全套抗风险,钱花了几十万,最后一点用没有,反而把现金流拖垮了。抗风险设计本身也要抗风险,不能把自己搞死了对吧?
不过话说回来,所有的技术设计,本质都是人的认知。上个月见一个连续创业的朋友,他说经历过一次疫情倒闭又重来之后,才明白,公司能走得远,从来不是看你跑的有多快,是看你摔了一跤之后,能不能爬起来。
抗风险技术设计,说白了,就是你提前给自己拴的那根保命绳子。你可以一辈子不用,但不能没有。
抗风险设计不是“灾后救火预案”,是“把风险焊死在出厂前”
很多人对这件事的理解从根上就错了。一提到抗风险,第一反应就是写个文档存起来,出了事照着走。或者花大价钱买个异地灾备,就觉得万事大吉了。 这哪叫抗风险设计?这叫买安心丸,不管用的那种。 现在行业变化有多快?上半年用的第三方供应链,下半年说断供就断供。你刚把大模型嵌进业务,转头就出数据泄露的风险。真出了事,几个小时的宕机就能把你半年的利润烧光,等你翻预案找流程,黄花菜都凉了。软件系统分层原生抗风险设计示意图
我去年看过北大软微实验室发布的一篇分布式系统抗风险科研成果,核心思路我印象特别深:抗风险不是外挂的补丁,是原生嵌进架构里的属性。他们做的模块隔离设计,每个业务单元自带容错能力,一个模块出问题,自动切断和其他模块的连接,根本不用人工手动切流量,整个过程不到十秒。
这不比你存个几十页的应急预案有用一万倍?
很多企业花几百万买顶级灾备服务,结果连最基础的核心业务和非核心业务拆分都没做。一次小的服务器波动,连带着官网博客一起把用户数据库拖垮,这不是笑话吗?当前抗风险技术设计的三个反常识误区
我踩过坑也见过太多企业踩坑,总结下来,大多数人都绕不开这三个坑。 第一个误区:冗余越多越安全。不对。冗余堆得越多,架构复杂度越高,出连锁问题的概率反而越大。我之前接触过一家区域性银行,为了防单点故障,硬生生堆了七层冗余,结果一次小的配置更新,七层冗余的校验机制互相触发bug,直接全系统宕机四个小时,本来很小的事,变成了大事故。 第二个误区:抗风险就是防黑天鹅。不对。百分之九十的企业出问题,死的都是天天看得见的灰犀牛。数据库的慢查询一天天堆着没人管,峰值一来直接崩;第三方接口的调用限额从来不做监控,大促流量一爆直接被限流;这些风险天天摆在你脸上,没人当回事,最后攒成大爆炸。 第三个误区:抗风险是技术部门一个人的事。更不对。去年某头部新式茶饮爆出来的原料安全问题,根子在哪?技术部门本来做了原料库存的过期预警,但是运营和供应链部门不愿意配合录入数据,预警机制直接成了摆设,最后爆出几十万杯问题产品,品牌口碑直接掉了三个档位。企业全链路业务抗风险节点分布图
说白了,抗风险技术设计从来不是纯技术活,是嵌进整个业务流程里的系统工程。从需求立项的时候就得考虑风险,不是技术团队最后擦屁股补补丁。从最新科研成果看,抗风险设计的新方向
从最新科研成果看,抗风险设计的新方向
这两年AI和分布式架构起来之后,抗风险设计的思路也变了,有两个方向我觉得特别值得关注。
第一个就是动态自适应抗风险。原来的设计思路是“我预设这里会出问题,所以留个后手”,但现在风险的变化太快,你根本预设不完。今年ACM发布的最新自适应架构论文里提到的思路,就是让系统自己实时感知异常,自动调整架构,不用人提前写死规则。
举个例子,中科院计算所去年做的大模型训练集群抗风险设计,原来大模型训练的时候,一个GPU硬盘出故障,整段训练都得重来,几千块一小时的算力就打水漂了。现在他们的设计能自动隔离故障节点,把任务无缝切到空闲节点,断点续训,损失不到十分钟的算力,这省的都是真金白银。
现在多少企业忙着做大模型私有化部署,眼睛只盯着怎么把模型跑起来,根本忘了做抗风险设计。等你跑了三天,一个硬件故障全部重来,那钱烧的,心疼不心疼?
第二个方向就是轻量抗风险,适合大多数中小企业。不是谁都有国企大厂的预算做全链路灾备,对于中小公司来说,抗风险不需要搞那么复杂,只要抓住核心:把你最赚钱、最不能出问题的两三个节点,做足隔离和冗余,非核心的比如官网、内部OA,挂了就挂了,先保住命再说。
说实话,我见过太多中小公司,学着大厂的样子搞全套抗风险,钱花了几十万,最后一点用没有,反而把现金流拖垮了。抗风险设计本身也要抗风险,不能把自己搞死了对吧?
不过话说回来,所有的技术设计,本质都是人的认知。上个月见一个连续创业的朋友,他说经历过一次疫情倒闭又重来之后,才明白,公司能走得远,从来不是看你跑的有多快,是看你摔了一跤之后,能不能爬起来。
抗风险技术设计,说白了,就是你提前给自己拴的那根保命绳子。你可以一辈子不用,但不能没有。