强化学习技术:从棋盘走到产业,那些被吹爆和被隐藏的真相
去年跟一位在顶流AI实验室做研究的朋友吃饭,隔壁桌创业团队聊融资,开口第一句就是“我们项目用了最先进的强化学习技术”。朋友偷偷跟我翻了个白眼,说现在这词都快跟“大数据”“元宇宙”一样,成了圈钱的万能膏药了。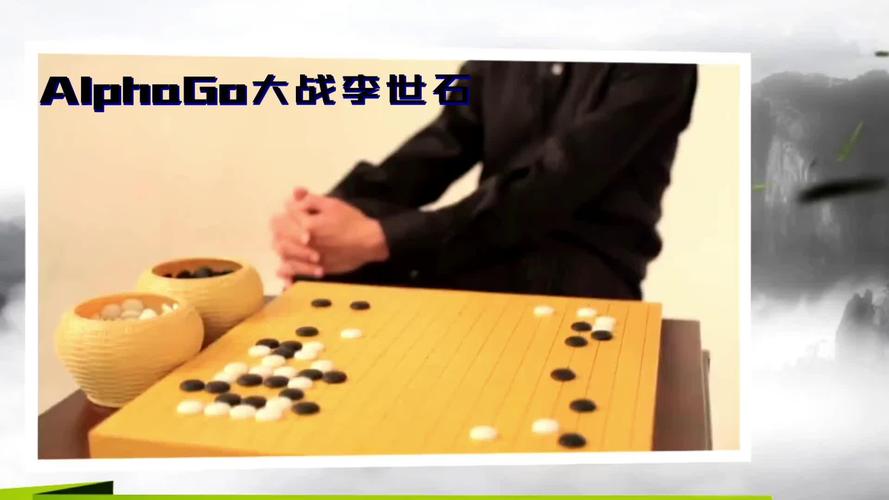 AlphaGo对战李世石对弈现场图
之前我看过一份行业调研,说超过七成的强化学习项目,死在了“试错成本太高”这一步。现在离线强化学习为什么突然成了学界顶流?说白了就是解决这个问题——不用实时和环境交互试错,直接用已经收集好的历史数据就能训模型,一下子把试错成本打下来了。
哪怕这样,坑还是不少。很多论文里刷到新高分的SOTA模型,换一个真实场景的数据集,准确率直接掉三十个点,这种事在arxiv上天天见。很多研究员都在吐槽,现在强化学习的论文,水活比别的领域高多了。
 ChatGPT RLHF强化学习训练流程图
除了大模型,很多你没注意到的地方已经用上了。抖音的推荐系统,现在就用强化学习实时调整策略,你每一次点赞、停留、划走,都是在给模型喂信号,用不了多久就能摸准你到底爱吃哪口瓜。波士顿动力的人形机器人,关节的动态控制,现在也是用强化学习调,过个坑坑洼洼的地面,比传统控制方法稳太多。国内的电网调度,现在几家省级电网都在用强化学习优化风光发电的出力调配,一年下来能省好几个点的损耗,算下来就是好几亿的收益,真金白银。
这些跑通的项目都有同一个特点:要么试错成本足够低,要么有足够逼真的仿真环境提前训。推荐系统在线上AB测试,错一次也就是给用户推一个不喜欢的视频,没啥大损失;电网调度先在仿真系统里训到准确率够高,再上线,不会出安全问题;大模型本身就是在虚拟空间里训练,试错成本几乎为零。找对了场景,强化学习才能发挥作用。
 强化学习技术的下一站,到底能走多远
现在学界和产业界都在卡的一个点,就是泛化性太差。模型在你给的训练环境里能上天,换个稍微不一样的场景,直接原地发呆。比如你训了一个抓杯子的机器人,换个红色的杯子它就不认识了,这不扯呢吗。
现在大家找的方向,一个是跟大模型结合,把大模型已经学到的世界知识当做强化学习的先验,不用从零开始摸瞎。比如训机器人开门,大模型已经知道门有把手,开门要转把手再拉,模型只需要学具体的动作控制就行,试错次数直接降一个量级。另一个方向就是做通用的强化学习基座,一个模型能搞定一堆同类型的任务,不用每个任务都从头训一遍,真做出来的话,落地成本能砍一大半。
我前阵子碰上个创业者,说要用强化学习优化大棚种蔬菜,连光照浇水都要用强化学习调,我算了算,一套设备下来比菜本身都贵,纯纯交智商税。
说白了,技术从来没有什么颠覆一切的魔力,它就是个工具。传统方法能做好的事,没必要硬凑强化学习的热闹。现在很多人把强化学习吹成万能AI,我看就是资本造势的结果。未来十年,强化学习会慢慢在适合它的场景落地,一点点替换旧方法,不会一下子改变全世界。
你说对吧?
别被AlphaGo的神话误导,强化学习的坑远没被说完
很多人只记得AlphaGo打败李世石那天铺天盖地的报道,说强化学习终于搞定了最复杂的智力游戏,却没人提这场胜利是建立在千万局自我对弈、固定规则完全信息的封闭场景下的。 换环境都不好使。 说实话,放到现实世界里,99%的问题都不满足封闭、固定规则、可无限试错这三个条件。你训练一个自动驾驶模型,总不能真让车撞上千次才能学会躲行人吧?你做一个供应链调度模型,总不能让公司亏个几千万试错吧?AlphaGo对战李世石对弈现场图
之前我看过一份行业调研,说超过七成的强化学习项目,死在了“试错成本太高”这一步。现在离线强化学习为什么突然成了学界顶流?说白了就是解决这个问题——不用实时和环境交互试错,直接用已经收集好的历史数据就能训模型,一下子把试错成本打下来了。
哪怕这样,坑还是不少。很多论文里刷到新高分的SOTA模型,换一个真实场景的数据集,准确率直接掉三十个点,这种事在arxiv上天天见。很多研究员都在吐槽,现在强化学习的论文,水活比别的领域高多了。那些真的跑通的强化学习技术应用,都长什么样
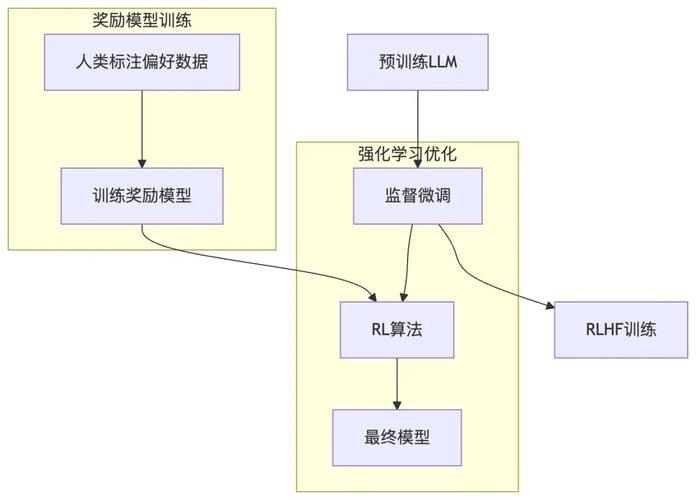
不过话说回来,这两年也确实有一批实打实用起来的项目,不是骗融资的噱头。 最出圈的就是大模型的RLHF,也就是基于人类反馈的强化学习。没有这一步,现在的ChatGPT根本没法用。 你想啊,大模型预训练就是学文字的统计规律,你问它问题它能给你编出八百个答案,哪个对哪个好用,人类说的算。RLHF就是把人类的偏好反馈灌进去,让模型慢慢学会输出符合人类需求的回答,而不是瞎扯。ChatGPT RLHF强化学习训练流程图
除了大模型,很多你没注意到的地方已经用上了。抖音的推荐系统,现在就用强化学习实时调整策略,你每一次点赞、停留、划走,都是在给模型喂信号,用不了多久就能摸准你到底爱吃哪口瓜。波士顿动力的人形机器人,关节的动态控制,现在也是用强化学习调,过个坑坑洼洼的地面,比传统控制方法稳太多。国内的电网调度,现在几家省级电网都在用强化学习优化风光发电的出力调配,一年下来能省好几个点的损耗,算下来就是好几亿的收益,真金白银。
这些跑通的项目都有同一个特点:要么试错成本足够低,要么有足够逼真的仿真环境提前训。推荐系统在线上AB测试,错一次也就是给用户推一个不喜欢的视频,没啥大损失;电网调度先在仿真系统里训到准确率够高,再上线,不会出安全问题;大模型本身就是在虚拟空间里训练,试错成本几乎为零。找对了场景,强化学习才能发挥作用。强化学习技术的下一站,到底能走多远
强化学习技术的下一站,到底能走多远
现在学界和产业界都在卡的一个点,就是泛化性太差。模型在你给的训练环境里能上天,换个稍微不一样的场景,直接原地发呆。比如你训了一个抓杯子的机器人,换个红色的杯子它就不认识了,这不扯呢吗。
现在大家找的方向,一个是跟大模型结合,把大模型已经学到的世界知识当做强化学习的先验,不用从零开始摸瞎。比如训机器人开门,大模型已经知道门有把手,开门要转把手再拉,模型只需要学具体的动作控制就行,试错次数直接降一个量级。另一个方向就是做通用的强化学习基座,一个模型能搞定一堆同类型的任务,不用每个任务都从头训一遍,真做出来的话,落地成本能砍一大半。
我前阵子碰上个创业者,说要用强化学习优化大棚种蔬菜,连光照浇水都要用强化学习调,我算了算,一套设备下来比菜本身都贵,纯纯交智商税。
说白了,技术从来没有什么颠覆一切的魔力,它就是个工具。传统方法能做好的事,没必要硬凑强化学习的热闹。现在很多人把强化学习吹成万能AI,我看就是资本造势的结果。未来十年,强化学习会慢慢在适合它的场景落地,一点点替换旧方法,不会一下子改变全世界。
你说对吧?