深度学习技术:跳出玄学滤镜,看真实的科研与落地
上周跟实验室刚进组的师弟师妹吃饭,聊起深度学习,一半人说这不就是调参炼丹,全靠运气?另一半说现在都是大模型的天下,普通人根本碰不到核心。
听完我就笑了。老印象该更新了。
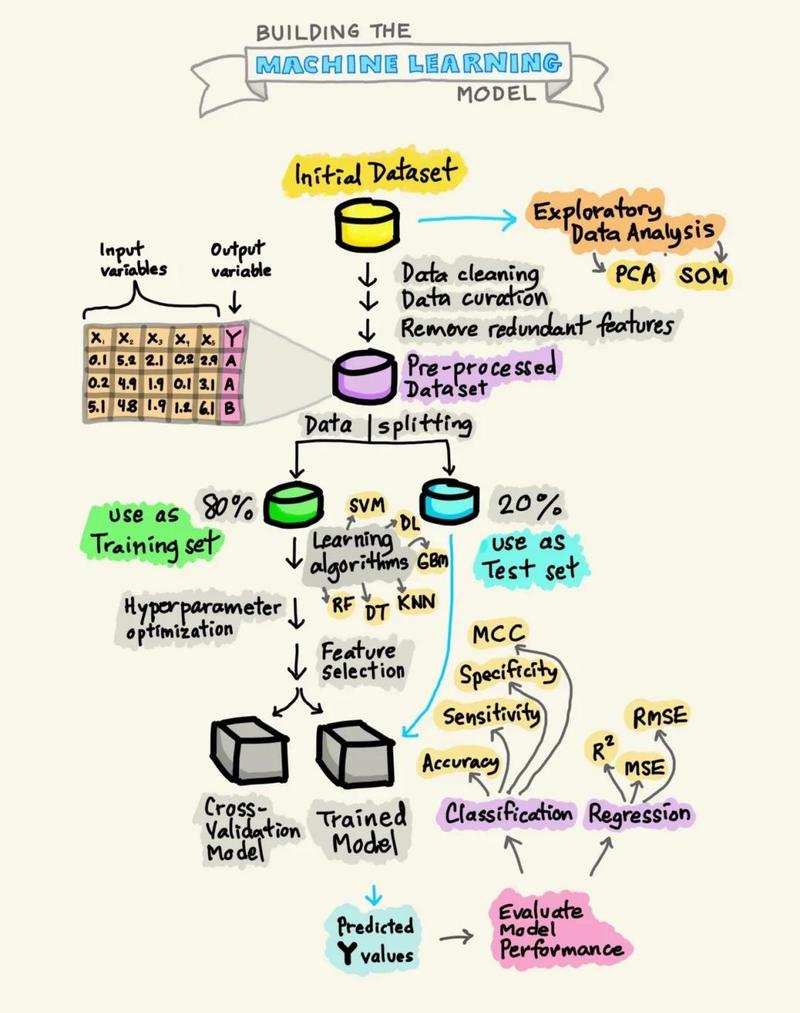 深度学习大模型预训练数据清洗流程图
上个月刷ICML2024的最新论文,有一篇专门给小样本场景做了误差边界的量化推导。原来大家靠手感调了十几年的正则项系数,人家直接用数学推出来最优区间,实际跑下来误差比经验调参还低3%左右。
说实话,现在顶会评审卡得越来越严,纯堆算力堆数据涨点的文章,基本都中不了。第一句话就问你,技术原理上的贡献到底在哪里?还拿着“炼丹”当标签说事儿,那都是停留在五年前的老黄历,跟不上趟了。
当然,调参经验还是有用,但早就不是核心了。核心是技术原理的突破,是对模型行为的量化理解。
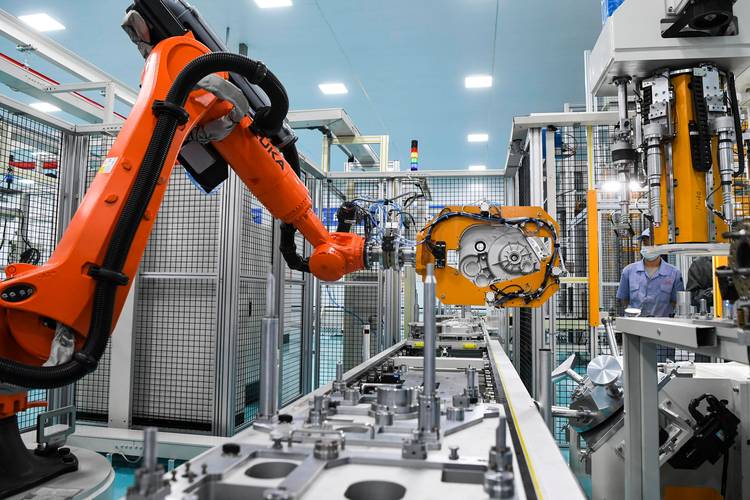 工业AI质检深度学习域自适应效果对比图
我们没换模型,只是把特征对齐那一步,用2023年出的动态对抗域自适应方法改了一遍,又补了一百多组不同环境下的标注样本,半个月调完,漏检率直接降到1.8%,满足工厂的出货要求。就这一点改动,帮工厂一年省了几百万的人工成本。
不过话说回来,现在好多做AI落地的公司,都喜欢吹自己的模型参数有多大,训练数据有多少T,从来不提这种脏活累活。好像参数堆上去了,问题自然就解决了。
哪有这么好的事。能落地的深度学习技术,从来都是拿着真金白银在现场堆出来的,不是在算力集群上吹出来的。
 下一个五年,深度学习技术会往哪冲?
现在好多人说,大模型就是深度学习的终点了,再搞也搞不出什么新东西了。我不这么看。
最近一年看顶会顶刊的成果,两个方向真的让人惊喜。一个是端侧小型化深度学习技术,一个是结合物理规则的神经符号深度学习。
端侧这个好理解,现在大家都要把大模型装到手机、汽车、工业控制器里,什么都往云端传,一来隐私没保障,二来延迟还高,用户根本没法用。现在的量化剪枝技术早就不是当年随便剪几层那种玩法了,会根据不同层的任务敏感度动态调整剪枝比例,10B的大模型剪完不到1B,精度掉不到1%,直接就能跑在最新的旗舰手机里,日常用起来根本感觉不到差别。
另一个结合物理规则的方向,真的惊到我了。原来深度学习是纯数据驱动,模型学的就是数据里的关联,遇到训练集里没见过的场景,直接就瞎输出。现在把物理公式、领域规则直接嵌到神经网络的结构里,相当于给模型套了个“紧箍咒”,让它输出不能违反最基本的物理规律。
就说天气预报,原来纯数据驱动的模型,遇到百年一遇的极端天气,预测偏差大得离谱。现在把流体力学的基本方程嵌进模型,预测偏差直接降了三成,计算速度还比传统数值模拟快了一百多倍。上个月Nature子刊刚发了一篇湍流预测的成果,就是这个思路,业内反应特别大。
当然,乱象也有。现在不管什么课题,都要蹭一下大模型、深度学习的热度,本来一个线性回归就能解决的小问题,非要整个千亿参数模型凑热点,说白了就是骗经费骗融资。这种风气真的让人讨厌,好好的技术,被这帮人搞成了圈钱的工具。
其实回头看,深度学习从最早的感知机出来,到现在快七十年了,中间冷了两次,火了三次,哪次起来不是因为解决了真实世界的硬问题?最早搞定图像识别,然后搞定语音翻译,现在搞定大语言理解,下一步呢?能不能把新药研发的周期从十年缩到两三年?能不能帮我们搞定可控核聚变的等离子体预测?能不能真的把癌症的早期筛查准确率提上去?
这些才是深度学习技术真正该去的地方。不是朋友圈的融资通稿,不是实验室里炫技的花活,是真刀真枪解决人类解决不了的难题。
对吧。
别骂“炼丹”了,深度学习技术早已经不是瞎蒙
早五六年,确实是这么回事。那会你改个学习率,提交任务跑三天,出结果不行,再改了重新跑,全靠经验撞大运。遇到不收敛,只能对着电脑骂街。 真的不一样了。 现在从大模型预训练到小样本学习,每一步的技术边界都被科研人员摸得越来越清楚。深度学习大模型预训练数据清洗流程图
上个月刷ICML2024的最新论文,有一篇专门给小样本场景做了误差边界的量化推导。原来大家靠手感调了十几年的正则项系数,人家直接用数学推出来最优区间,实际跑下来误差比经验调参还低3%左右。
说实话,现在顶会评审卡得越来越严,纯堆算力堆数据涨点的文章,基本都中不了。第一句话就问你,技术原理上的贡献到底在哪里?还拿着“炼丹”当标签说事儿,那都是停留在五年前的老黄历,跟不上趟了。
当然,调参经验还是有用,但早就不是核心了。核心是技术原理的突破,是对模型行为的量化理解。
产业落地里,被资本泡沫掩盖住的深度学习技术细节
这两年AI落地吹得凶,十个创业项目九个说自己用了大模型,深度学习多么牛逼。真到落地现场,一跑就拉胯的,不在少数。 我去年帮长三角一家做汽车零部件质检的工厂调模型,他们花几十万买了某大厂的AI检测系统,公开数据集上准确率99%,到工厂车间里一跑,漏检率直接干到12%。为啥?车间的灯光一会儿亮一会儿暗,零件表面还容易沾切削液的灰尘,跟训练集的环境完全不一样。 域自适应不是论文里凑引用的炫技名词,是工业落地必须跨过的生死坎工业AI质检深度学习域自适应效果对比图
我们没换模型,只是把特征对齐那一步,用2023年出的动态对抗域自适应方法改了一遍,又补了一百多组不同环境下的标注样本,半个月调完,漏检率直接降到1.8%,满足工厂的出货要求。就这一点改动,帮工厂一年省了几百万的人工成本。
不过话说回来,现在好多做AI落地的公司,都喜欢吹自己的模型参数有多大,训练数据有多少T,从来不提这种脏活累活。好像参数堆上去了,问题自然就解决了。
哪有这么好的事。能落地的深度学习技术,从来都是拿着真金白银在现场堆出来的,不是在算力集群上吹出来的。
下一个五年,深度学习技术会往哪冲?
下一个五年,深度学习技术会往哪冲?
现在好多人说,大模型就是深度学习的终点了,再搞也搞不出什么新东西了。我不这么看。
最近一年看顶会顶刊的成果,两个方向真的让人惊喜。一个是端侧小型化深度学习技术,一个是结合物理规则的神经符号深度学习。
端侧这个好理解,现在大家都要把大模型装到手机、汽车、工业控制器里,什么都往云端传,一来隐私没保障,二来延迟还高,用户根本没法用。现在的量化剪枝技术早就不是当年随便剪几层那种玩法了,会根据不同层的任务敏感度动态调整剪枝比例,10B的大模型剪完不到1B,精度掉不到1%,直接就能跑在最新的旗舰手机里,日常用起来根本感觉不到差别。
另一个结合物理规则的方向,真的惊到我了。原来深度学习是纯数据驱动,模型学的就是数据里的关联,遇到训练集里没见过的场景,直接就瞎输出。现在把物理公式、领域规则直接嵌到神经网络的结构里,相当于给模型套了个“紧箍咒”,让它输出不能违反最基本的物理规律。
就说天气预报,原来纯数据驱动的模型,遇到百年一遇的极端天气,预测偏差大得离谱。现在把流体力学的基本方程嵌进模型,预测偏差直接降了三成,计算速度还比传统数值模拟快了一百多倍。上个月Nature子刊刚发了一篇湍流预测的成果,就是这个思路,业内反应特别大。
当然,乱象也有。现在不管什么课题,都要蹭一下大模型、深度学习的热度,本来一个线性回归就能解决的小问题,非要整个千亿参数模型凑热点,说白了就是骗经费骗融资。这种风气真的让人讨厌,好好的技术,被这帮人搞成了圈钱的工具。
其实回头看,深度学习从最早的感知机出来,到现在快七十年了,中间冷了两次,火了三次,哪次起来不是因为解决了真实世界的硬问题?最早搞定图像识别,然后搞定语音翻译,现在搞定大语言理解,下一步呢?能不能把新药研发的周期从十年缩到两三年?能不能帮我们搞定可控核聚变的等离子体预测?能不能真的把癌症的早期筛查准确率提上去?
这些才是深度学习技术真正该去的地方。不是朋友圈的融资通稿,不是实验室里炫技的花活,是真刀真枪解决人类解决不了的难题。
对吧。