机器学习技术:别被神化了,它现在到底能干嘛?
上次跟做CV的师哥吃火锅,他吐槽了快一小时。
全是坑。
现在随便找个创业项目PPT,十页有八页要把“机器学习”四个大字打在封面上,拆开来看看,九成都是换皮忽悠,把Excel的线性拟合换个名字就敢叫AI预测。
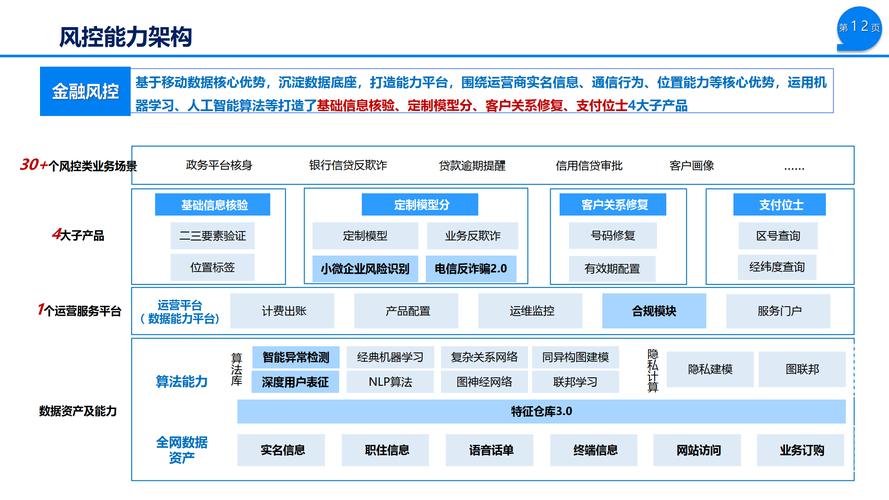 金融行业机器学习风控部署架构图
我前年帮一家区域连锁超市做日常客流预测,手上单店每天一个数据点,撑死了也就三百多条数据。抱着试试的心态搭了个Transformer模型调了三天,出来的结果忽上忽下,连去年国庆的客流高峰都预测错了。最后改了下用户特征,用了优化后的XGBoost,误差直接砍了一半,跑起来还不用占GPU,普通服务器就能带。
为什么?因为小样本场景下,复杂大模型纯属过拟合,白瞎算力和钱。
不过话说回来,老算法不代表没用,合适的技术解决合适的问题,这才是落地的核心。
 医疗领域联邦学习数据交互流程图
还有模型蒸馏技术,之前大家就是用来把大模型压缩到手机里省空间,现在早就玩出花了。我上周刷arXiv刚看到一篇新成果,把预训练好的蛋白质结构预测大模型,蒸馏成了只有几十兆的小模型,准确率只掉了不到2个点,普通实验室的PC就能跑,不用排队抢超算资源。
你知道这对多少做基础生物科研的学生意味着什么吗?之前多少人因为跑不动大模型,课题卡住延毕,现在一句话的事,成本直接降了几十倍。
哦对了,我也不是说大模型没用,就是觉得没必要什么问题都往大模型上凑。上个月碰到一个做农业物联网的朋友,他们想用机器学习预测大棚蔬菜产量,光清洗传感器数据就花了两个多月,一半的时间传感器坏了没换,数据缺得不成样子,再好的大模型也变不出结果。最后用了简单的时间序列模型加正则化,预测准确率比农户人工估产高了快三成,已经帮农户每亩多赚了小两百块,这不就是有用的技术?
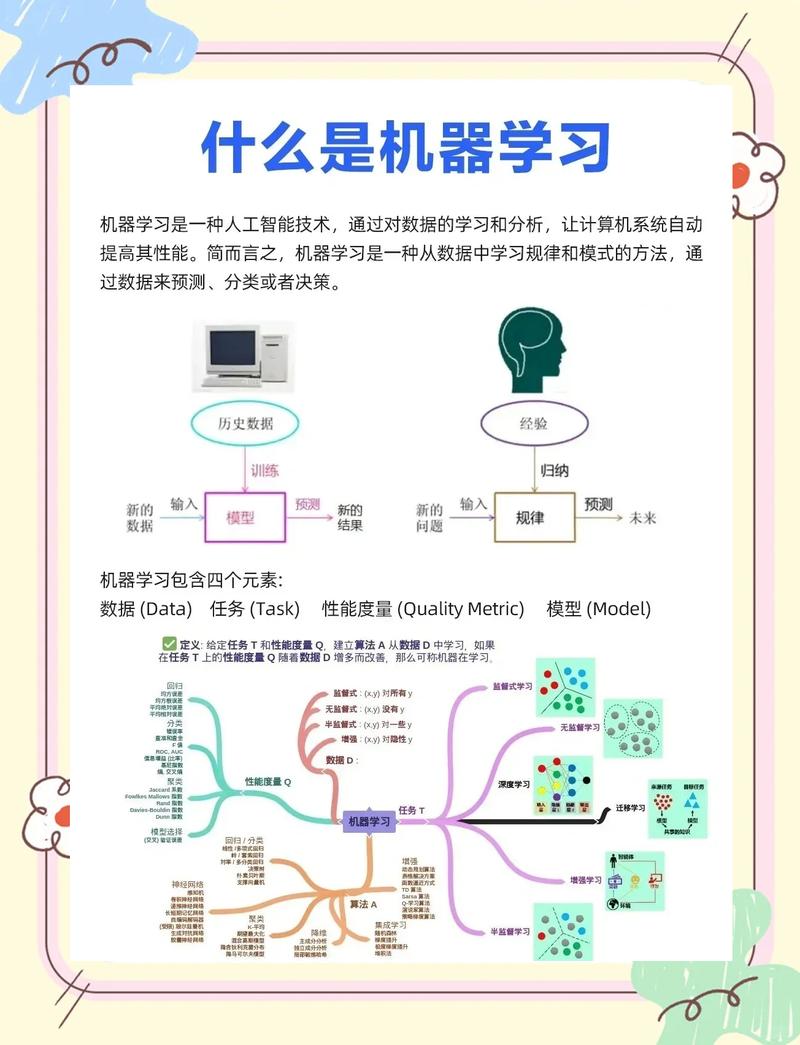 普通人入坑机器学习技术,别被网上的教程带歪了
现在打开短视频,一堆教程上来就是教你微调大模型,教你搭ChatGPT克隆,跟着学了大半年,真给你一堆脏数据,连怎么处理缺失值都不会。
真的,我面试过不少刚毕业的学生,十个有八个能把大模型的架构背得滚瓜烂熟,一问做建模前80%的时间要花在哪,一半答不出来。
答案是数据处理。绝大多数能落地赚钱的机器学习项目,80%的功夫都在清洗数据、整理特征,不是调参堆模型。
我之前认识一个二本毕业的小伙子,在杭州做电商第三方服务,人家不追风口不玩大模型,就安安稳稳把电商用户的浏览、购买、收藏、复购时间这些特征理得清清楚楚,用一个轻量的梯度提升树做复购预测,效果比甲方之前找某大厂做的大模型方案还好,收费只要十分之一,现在自己开个小工作室,每个月接两三个单,活得不要太舒服。
很多人问我,现在大模型这么火,是不是只有做大模型才有出路?
哪有这种说法。
我们国家那么多行业,从制造业到农业,从物流到医疗,大大小小的痛点数都数不过来,哪个不需要定制化的机器学习方案?这些场景里,根本不需要千亿参数的大模型,几百兆甚至几兆的小模型,只要能解决问题,就是好技术。
前阵子刷新闻看到,西北农林科技大学的几个学生,做了一个轻量机器学习模型识别果树蚜虫,果农拿手机拍张照就能识别,准确率九成多,还能告诉你打多少药合适,帮当地果农省了快三成的农药钱,这不比凑一堆人训大模型赚流量有价值?
机器学习技术从来都不是什么高高在上的魔法,它就是个工具。
能解决问题的工具,就是好工具。
现在工业界用的机器学习技术,根本不是你想的那样
很多人提起机器学习,第一反应就是ChatGPT那种千亿参数大模型,仿佛不堆参数就不配叫机器学习。 说实话,真不是这么回事。 现在工厂、零售、金融这些传统行业里跑的成熟方案,大多还是十年前就出来的老算法,稳得一批。比如金融风控场景,逻辑回归到现在还是主流,比很多花里胡哨的复杂模型表现还好,训练快,解释性强,出了问题能顺着特征一步步查到原因,刚好符合监管的合规要求,谁换谁傻。金融行业机器学习风控部署架构图
我前年帮一家区域连锁超市做日常客流预测,手上单店每天一个数据点,撑死了也就三百多条数据。抱着试试的心态搭了个Transformer模型调了三天,出来的结果忽上忽下,连去年国庆的客流高峰都预测错了。最后改了下用户特征,用了优化后的XGBoost,误差直接砍了一半,跑起来还不用占GPU,普通服务器就能带。
为什么?因为小样本场景下,复杂大模型纯属过拟合,白瞎算力和钱。
不过话说回来,老算法不代表没用,合适的技术解决合适的问题,这才是落地的核心。
最近两年机器学习技术的真突破,都在落地细节里
大模型的热闹都是资本炒出来的,真的实打实的科研进展,好多都在看起来不怎么起眼的小方向。 就说联邦学习吧,这个概念说了快十年,之前一直停留在论文里,落不了地。今年突然就在医疗领域火出圈了。 为什么?国内现在对医疗数据隐私卡得越来越严,不同医院的数据不能出域,更别说拿出来共享训模型了。而联邦学习刚好能让多家机构在不交换原始数据的前提下联合建模,完美解决了合规问题。去年广东省好几家三甲医院联合训出来的糖尿病早期风险预测模型,准确率比单家医院自己训的高了18个百分点,能提前三五年筛查出高危人群,这是真真正正能救命的成果。医疗领域联邦学习数据交互流程图
还有模型蒸馏技术,之前大家就是用来把大模型压缩到手机里省空间,现在早就玩出花了。我上周刷arXiv刚看到一篇新成果,把预训练好的蛋白质结构预测大模型,蒸馏成了只有几十兆的小模型,准确率只掉了不到2个点,普通实验室的PC就能跑,不用排队抢超算资源。
你知道这对多少做基础生物科研的学生意味着什么吗?之前多少人因为跑不动大模型,课题卡住延毕,现在一句话的事,成本直接降了几十倍。
哦对了,我也不是说大模型没用,就是觉得没必要什么问题都往大模型上凑。上个月碰到一个做农业物联网的朋友,他们想用机器学习预测大棚蔬菜产量,光清洗传感器数据就花了两个多月,一半的时间传感器坏了没换,数据缺得不成样子,再好的大模型也变不出结果。最后用了简单的时间序列模型加正则化,预测准确率比农户人工估产高了快三成,已经帮农户每亩多赚了小两百块,这不就是有用的技术?
普通人入坑机器学习技术,别被网上的教程带歪了
普通人入坑机器学习技术,别被网上的教程带歪了
现在打开短视频,一堆教程上来就是教你微调大模型,教你搭ChatGPT克隆,跟着学了大半年,真给你一堆脏数据,连怎么处理缺失值都不会。
真的,我面试过不少刚毕业的学生,十个有八个能把大模型的架构背得滚瓜烂熟,一问做建模前80%的时间要花在哪,一半答不出来。
答案是数据处理。绝大多数能落地赚钱的机器学习项目,80%的功夫都在清洗数据、整理特征,不是调参堆模型。
我之前认识一个二本毕业的小伙子,在杭州做电商第三方服务,人家不追风口不玩大模型,就安安稳稳把电商用户的浏览、购买、收藏、复购时间这些特征理得清清楚楚,用一个轻量的梯度提升树做复购预测,效果比甲方之前找某大厂做的大模型方案还好,收费只要十分之一,现在自己开个小工作室,每个月接两三个单,活得不要太舒服。
很多人问我,现在大模型这么火,是不是只有做大模型才有出路?
哪有这种说法。
我们国家那么多行业,从制造业到农业,从物流到医疗,大大小小的痛点数都数不过来,哪个不需要定制化的机器学习方案?这些场景里,根本不需要千亿参数的大模型,几百兆甚至几兆的小模型,只要能解决问题,就是好技术。
前阵子刷新闻看到,西北农林科技大学的几个学生,做了一个轻量机器学习模型识别果树蚜虫,果农拿手机拍张照就能识别,准确率九成多,还能告诉你打多少药合适,帮当地果农省了快三成的农药钱,这不比凑一堆人训大模型赚流量有价值?
机器学习技术从来都不是什么高高在上的魔法,它就是个工具。
能解决问题的工具,就是好工具。