自然语言处理:被大模型光环掩盖的真实机会
上周帮朋友改简历,她投算法岗,方向填自然语言处理,HR初筛直接打了个叉。理由写着“方向太卷,早就饱和了”。
我听完只觉得好笑。现在所有人张嘴闭嘴都是大模型,好像自然语言处理已经变成大模型的附庸了,连找工作都要被嫌弃。可事实呢?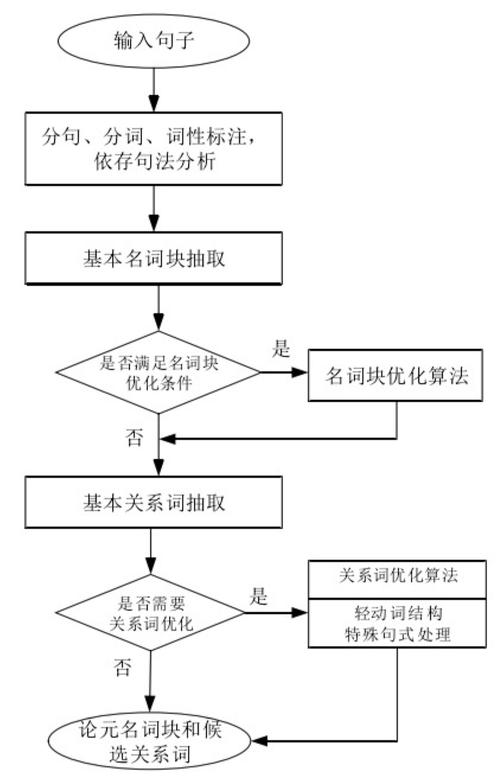 传统自然语言处理中文分词流程示意图
很多人瞧不上这些老技术,觉得过时了,没创新。可你去招聘网站搜一搜,不管是互联网公司还是传统企业,招NLP相关岗位,十有八九都要求你会这些基础活。大模型谁都能聊两句,真能把分词准确率提高一个百分点,能把实体抽取的速度提一倍,那就是真本事,企业愿意给钱。
不过话说回来,基础NLP确实卷,但那都是卷浮在表面的人,真沉下心把基础技术和具体场景结合,坑多的是,没人填。
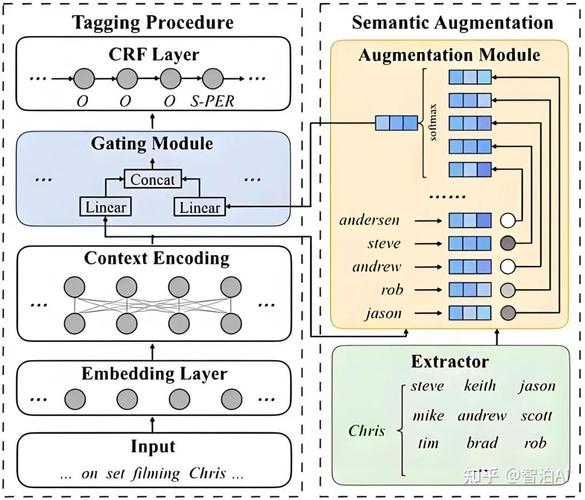 医疗领域自然语言处理实体抽取示例图
这种事情,通用大模型厂商不愿意做,嫌单子小,要攒数据太麻烦。普通小团队又做不了,因为你拿不到脱敏的医疗数据,也不懂医疗领域的术语规则。所以就给这种小而精的团队留了足够大的利润空间。
不止医疗,法律、金融、政务、工业,每个垂直领域都有大把的NLP需求。做法律的抽判决书要点,做金融的研报信息拆解,做政务的方言转写,做工业的设备维修对话整理……哪一个不是真金白银的需求?
我见过一个做潮汕方言NLP的小团队,给当地政务热线做转写,之前通用大模型对潮汕话的识别率不到70%,他们采了十几万小时的本地口音数据,把准确率拉到95%以上,政府直接包了三年的运维,躺着赚钱。
现在太多人挤破头去做通用大模型,拼参数拼算力,烧了几个亿还赚不到一分钱。回头看看,垂直领域的自然语言处理,安安静静赚大钱的人,多了去了。
 NLP的下一个破局点,在多模态语义理解
当然,纯文本的自然语言处理确实快摸到天花板了,未来真正的大机会,肯定在多模态融合这块。
别觉得这是炒概念,我们人理解语言,本来就不是只看文字的。你跟朋友聊天,要听语气,看表情,看周围的场景,才能听懂对方真正的意思。机器为什么不能?之前NLP走了几十年的纯文本路线,本质上是受限于算力和数据,只能先从最简单的情况入手。现在算力够了,多模态数据也多了,自然要往更贴近人类的方向走。
举个最简单的例子:直播带货的内容审核,主播拿着商品说“这个东西效果特别好”,纯文本NLP只能拿到转写出来的文字,根本不知道“这个东西”指的是什么,有没有违规宣传,也就没法审核。可如果把主播画面里的商品信息提取出来,和文本语义融合在一起,一下子就能知道主播在说什么产品,符不符合规范。
再比如,现在很多人做AI家教,要给学生讲题,题目是图片,学生问的问题是语音,AI要先看懂图片里的题目是什么,再听懂学生问的点在哪里,才能给出正确的讲解,这本身就是多模态自然语言处理的活。
我之前看过一篇DeepMind的最新研究,他们做多模态NLP,能直接读懂漫画里的人物对话和表情动作,判断人物的情绪,准确率比纯文本模型高了整整二十八个百分点。看到结果的时候真的挺惊喜,原来我们离机器真的懂人话,又近了一步。
可惜现在国内很多做多模态的,都是炒概念,大部分就是把文本特征和图像特征简单拼一下,就敢叫多模态大模型出来骗融资,真正沉下心做多模态语义融合的,没几个。这块的坑和机会,都大得很。
前几天跟一个做了二十年NLP的老教授喝茶,他说,自然语言处理从出生那天起,目标就是让机器真正懂人话。不是比谁参数大,不是比谁发的顶会多,能解决真实世界里的问题,才不算走错了路。
想想也是,现在这个圈子太浮躁了,大模型的光环太亮,亮到很多人都忘了自然语言处理本来要做什么。说不定再过十年,回头看,那些没去凑大模型热闹,沉在基础技术、垂直领域和多模态融合里的人,才真的把这件事往前推了一大步。你说呢?
人人都抢大模型,没人填基础NLP的坑
说实话,现在网上能搜到的自然语言处理教程,十篇有九篇开头就是GPT,就是Llama,教你怎么微调大模型,怎么搭对话机器人。好像不做千亿参数模型,你都不好意思说自己做NLP。 可真到行业落地你就会发现,百分之九十的中小商家、传统企业,根本用不起千亿大模型。我前两年在一家电商创业公司待过,要给平台上几百万个商品标题自动打分类标签,老板一开始拍板要接OpenAI的API,算完账大家都傻了:打一个标签三分钱,一天十万个商品就是三千块,一个月九万,赶上两个算法工程师的工资了。 最后怎么解决的?找了个预训练好的1亿参数的BERT,针对电商数据微调,再加一套简单的规则校验,准确率只比GPT低两个百分点,成本直接降到原来的五十分之一。一个月电费加API钱才不到两千。 说白了,现在大部分行业场景,要的不是能写作文能聊天的大模型,要的是稳定、便宜、准确率够高的基础NLP能力:分词、实体抽取、情感分类、文本对齐……这些几十年前就出来的技术,至今还是行业落地的主力。传统自然语言处理中文分词流程示意图
很多人瞧不上这些老技术,觉得过时了,没创新。可你去招聘网站搜一搜,不管是互联网公司还是传统企业,招NLP相关岗位,十有八九都要求你会这些基础活。大模型谁都能聊两句,真能把分词准确率提高一个百分点,能把实体抽取的速度提一倍,那就是真本事,企业愿意给钱。
不过话说回来,基础NLP确实卷,但那都是卷浮在表面的人,真沉下心把基础技术和具体场景结合,坑多的是,没人填。最赚钱的自然语言处理,都在垂直领域
去年年底跟一个做医疗NLP的朋友吃饭,他们团队一共八个人,一年接了三个三甲医院的项目,净利润破了千万。我当时挺惊讶,问他们做什么高大上的东西,要价这么高? 其实很简单:医院要把几十年累积的纸质病历、医生口述的病程记录,全部转成标准化的结构化数据,方便科研和医保结算。大模型做不了吗?能做,但医疗这个领域,错一个术语就是大问题,大模型胡说八道的毛病,谁敢直接用? 他们的方案说穿了也不复杂:大模型做初稿转写,然后用医疗领域微调的垂直NLP模型做实体校验,最后再抽一层规则卡敏感错误,整体准确率能到99.7%,完全符合医院的要求。医疗领域自然语言处理实体抽取示例图
这种事情,通用大模型厂商不愿意做,嫌单子小,要攒数据太麻烦。普通小团队又做不了,因为你拿不到脱敏的医疗数据,也不懂医疗领域的术语规则。所以就给这种小而精的团队留了足够大的利润空间。
不止医疗,法律、金融、政务、工业,每个垂直领域都有大把的NLP需求。做法律的抽判决书要点,做金融的研报信息拆解,做政务的方言转写,做工业的设备维修对话整理……哪一个不是真金白银的需求?
我见过一个做潮汕方言NLP的小团队,给当地政务热线做转写,之前通用大模型对潮汕话的识别率不到70%,他们采了十几万小时的本地口音数据,把准确率拉到95%以上,政府直接包了三年的运维,躺着赚钱。
现在太多人挤破头去做通用大模型,拼参数拼算力,烧了几个亿还赚不到一分钱。回头看看,垂直领域的自然语言处理,安安静静赚大钱的人,多了去了。NLP的下一个破局点,在多模态语义理解
NLP的下一个破局点,在多模态语义理解
当然,纯文本的自然语言处理确实快摸到天花板了,未来真正的大机会,肯定在多模态融合这块。
别觉得这是炒概念,我们人理解语言,本来就不是只看文字的。你跟朋友聊天,要听语气,看表情,看周围的场景,才能听懂对方真正的意思。机器为什么不能?之前NLP走了几十年的纯文本路线,本质上是受限于算力和数据,只能先从最简单的情况入手。现在算力够了,多模态数据也多了,自然要往更贴近人类的方向走。
举个最简单的例子:直播带货的内容审核,主播拿着商品说“这个东西效果特别好”,纯文本NLP只能拿到转写出来的文字,根本不知道“这个东西”指的是什么,有没有违规宣传,也就没法审核。可如果把主播画面里的商品信息提取出来,和文本语义融合在一起,一下子就能知道主播在说什么产品,符不符合规范。
再比如,现在很多人做AI家教,要给学生讲题,题目是图片,学生问的问题是语音,AI要先看懂图片里的题目是什么,再听懂学生问的点在哪里,才能给出正确的讲解,这本身就是多模态自然语言处理的活。
我之前看过一篇DeepMind的最新研究,他们做多模态NLP,能直接读懂漫画里的人物对话和表情动作,判断人物的情绪,准确率比纯文本模型高了整整二十八个百分点。看到结果的时候真的挺惊喜,原来我们离机器真的懂人话,又近了一步。
可惜现在国内很多做多模态的,都是炒概念,大部分就是把文本特征和图像特征简单拼一下,就敢叫多模态大模型出来骗融资,真正沉下心做多模态语义融合的,没几个。这块的坑和机会,都大得很。
前几天跟一个做了二十年NLP的老教授喝茶,他说,自然语言处理从出生那天起,目标就是让机器真正懂人话。不是比谁参数大,不是比谁发的顶会多,能解决真实世界里的问题,才不算走错了路。
想想也是,现在这个圈子太浮躁了,大模型的光环太亮,亮到很多人都忘了自然语言处理本来要做什么。说不定再过十年,回头看,那些没去凑大模型热闹,沉在基础技术、垂直领域和多模态融合里的人,才真的把这件事往前推了一大步。你说呢?