隐私计算技术:破解数据流通与隐私保护的死局
上次跟互联网大厂做数据合规的朋友吃饭,他吐槽起前年接的一个项目,差点把头发熬秃。甲方要两家机构拿用户数据联合建模做风控,一边怕数据流出去违反《个人信息保护法》,一边没数据就出不了模型结果,两头掐住,项目差点黄在半路上。
这不是个例。这几年数据合规的网越收越紧,原来那种买卖数据、随便共享原始数据的路子彻底走不通,可跨机构的数据协作需求又摆在那——医疗要联合多家医院做药物试验,金融要跨平台做反欺诈,互联网要投广告算转化,哪一样离得开数据?
隐私计算技术就是这么走到台面上的。别以为这是资本炒出来的新风口,它是真的把困了行业十几年的死结给剪开了一道口子。
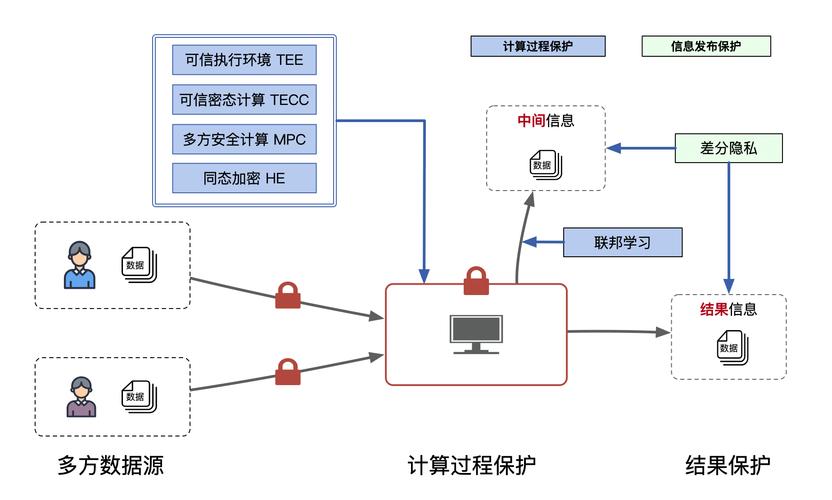 隐私计算数据可用不可见原理示意图
现在行业里主流的技术路线有三个,说出来你也不用记,听懂大概就行:联邦学习就是各家训各家的模型片段,只交换参数不换数据;安全多方计算就是一群机构凑在一起算结果,算完谁也摸不清其他人手里的原始输入;可信执行环境就是直接从硬件层面给数据搞个加密的“黑箱子”,运算完就清空,啥痕迹都不留。
说实话,我最早接触这个技术的时候,也觉得就是实验室里摆着看的花活,撑死了拿点经费搞科研,落地没戏。直到后来听国内某省医保局的朋友说,他们用隐私计算跑了跨地市的医保反欺诈模型,十几个地市的医保数据全留在本地,谁也拿不到别家的原始数据,最后愣是揪出了上千条骗保记录,挽回了好几个亿的损失。
那时候我才反应过来,这东西真不是炒概念,是真能解决问题。
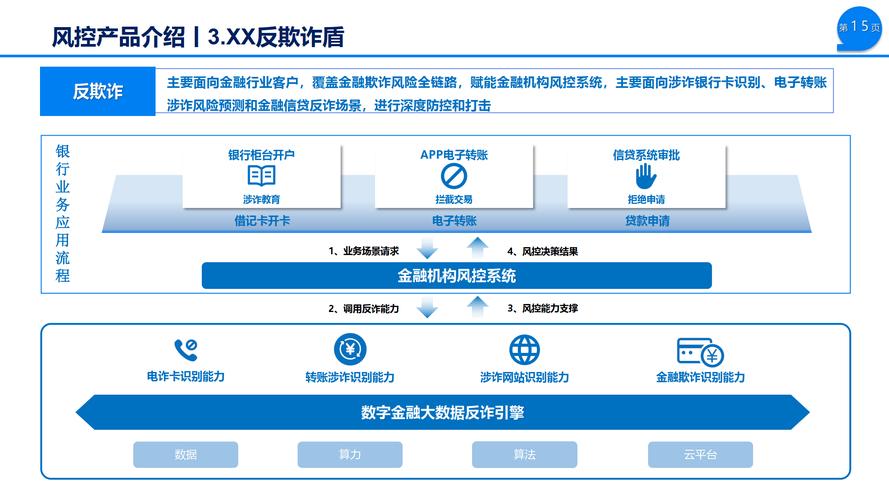 隐私计算金融风控联合建模应用场景图
不过话说回来,现在市场上混水摸鱼的也不少。把普通的数据脱敏包装成隐私计算卖钱的,把端对端加密说成隐私计算割投资人韭菜的,一抓一大把。我去年就见过一个创业项目,吹自己是国内顶尖的隐私计算服务商,结果坐下来聊了半小时,我问他原始数据会不会出域,他说脱敏之后就可以出啊……那叫哪门子隐私计算啊!
真隐私计算的底线就是,原始数据全程不离开数据持有方的可控域,碰都碰不到,这才叫解决了根本问题,否则都是换皮忽悠。
 隐私计算不是银弹,接下来要走的路还很长
说归说夸归夸,我得泼点冷水,隐私计算现在还远没到完美的程度,好多坑还没填上。
第一个就是性能和成本的问题。原来所有数据都放在一起算,现在要跨节点做加密交互,运算量和通信量都比原来大好几倍,原来跑一小时的模型,用隐私计算可能要跑四五个小时,成本翻两三倍都是常事。最近两年大模型火了,大家都想拿大模型做联合训练,可千亿级参数的大模型用现有隐私计算方案跑,成本高到没人用得起,现在行业里也都在攻关这个问题,不少科研团队都出了新的加密协议,能把通信成本降个百分之七八十,已经好很多了,但离随便用还有距离。
第二个就是标准不统一的问题。早几年各家做隐私计算平台,都是自己搞自己的技术框架,你用A家的我用B家的,我俩要合作做项目,光适配接口就要折腾一两个月,折腾完还不一定能跑通。还好去年国内出了第一个隐私计算的国家级技术标准,接下来慢慢统一接口和协议,这个问题慢慢就能解决。
还有就是安全的问题,经常有人问我,隐私计算真的百分百安全吗?说实话,哪有百分百安全的技术啊?前两年也有科研成果说,可以通过模型交互的参数反推部分原始用户信息,虽然这种攻击的成本很高,成功率也低,但确实说明隐私计算的安全防护还要继续补漏洞。最近一年国内高校和大厂研究院的相关成果发了不少,都是在补安全和性能的短板,比如上个月我看到阿里达摩院发的科研成果,把联邦学习的通信开销降了90%以上,还提升了安全性,这就是好事情。
其实我们普通人根本不用懂什么技术原理,你只要知道,现在你接到的垃圾推销短信比几年前少了,你办贷款的时候不用反复给不同机构交你的身份信息,这背后就有隐私计算技术的功劳。它默默帮你把你的数据锁在了该在的地方,还能让数据帮你享受到更好的服务。
上次再跟那个做合规的朋友吃饭,他说现在手里十个数据合作项目,有七八个都会用上隐私计算,原来的死局活了,甲方满意,合规也过了,大家都开心。
技术从来都是这样,能解决真问题,就是好技术。对吧?
别被名字唬住,隐私计算本质是「算」不是「藏」
很多人第一次听这个名字,第一反应是“哦,是不是把数据加密藏起来,谁都看不着那种?”。不对。真不是。 隐私计算的核心,说穿了就是一句话:数据可用不可见。 我给你举个最常见的例子:银行要和电商平台合作给用户做信用评分,银行手里有用户的流水数据,电商手里有用户的消费记录。放在以前,要么银行把流水给电商,要么电商把消费记录给银行,要么两家把数据都交给第三方合在一起算——不管选哪一种,原始数据都要离开自己的地盘,泄露风险拉满,现在合规根本不允许这么玩。 用隐私计算呢?原始数据自始至终都不离开各自的服务器,只把模型训练的中间参数拿出来交互,最后算出来信用分,两边都拿到了想要的结果,可谁也碰不到对方的原始用户数据。 就这么简单。隐私计算数据可用不可见原理示意图
现在行业里主流的技术路线有三个,说出来你也不用记,听懂大概就行:联邦学习就是各家训各家的模型片段,只交换参数不换数据;安全多方计算就是一群机构凑在一起算结果,算完谁也摸不清其他人手里的原始输入;可信执行环境就是直接从硬件层面给数据搞个加密的“黑箱子”,运算完就清空,啥痕迹都不留。
说实话,我最早接触这个技术的时候,也觉得就是实验室里摆着看的花活,撑死了拿点经费搞科研,落地没戏。直到后来听国内某省医保局的朋友说,他们用隐私计算跑了跨地市的医保反欺诈模型,十几个地市的医保数据全留在本地,谁也拿不到别家的原始数据,最后愣是揪出了上千条骗保记录,挽回了好几个亿的损失。
那时候我才反应过来,这东西真不是炒概念,是真能解决问题。
为什么现在突然火了?不是风口,是逼出来的
你有没有好奇,隐私计算这个概念其实上个世纪八十年代就提出来了,为什么偏偏最近三五年才在国内爆火,落地项目越来越多? 哪是什么风口啊,全是被合规逼出来的。 2021年《个人信息保护法》和《数据安全法》正式落地之后,数据共享、数据出境的规则一下子严了起来,原来灰色地带的玩法直接被掐死,可需求还在啊——金融机构要做联合风控降低坏账率,互联网平台要做精准营销不浪费广告预算,药企要做多中心临床试验加快研发速度,所有这些需求都要跨机构用数据,不能拿原始数据,那就只能用隐私计算。 我之前接触过一个做互联网广告归因的团队,原来他们的玩法就是广告平台和应用方互换用户标识,算清楚哪个广告带来了转化,现在根本不敢这么玩了,换成隐私计算的联邦学习框架,两边都不用出原始数据,算出来的转化结果一点不差,还顺顺利利过了合规审查。隐私计算金融风控联合建模应用场景图
不过话说回来,现在市场上混水摸鱼的也不少。把普通的数据脱敏包装成隐私计算卖钱的,把端对端加密说成隐私计算割投资人韭菜的,一抓一大把。我去年就见过一个创业项目,吹自己是国内顶尖的隐私计算服务商,结果坐下来聊了半小时,我问他原始数据会不会出域,他说脱敏之后就可以出啊……那叫哪门子隐私计算啊!
真隐私计算的底线就是,原始数据全程不离开数据持有方的可控域,碰都碰不到,这才叫解决了根本问题,否则都是换皮忽悠。
隐私计算不是银弹,接下来要走的路还很长
隐私计算不是银弹,接下来要走的路还很长
说归说夸归夸,我得泼点冷水,隐私计算现在还远没到完美的程度,好多坑还没填上。
第一个就是性能和成本的问题。原来所有数据都放在一起算,现在要跨节点做加密交互,运算量和通信量都比原来大好几倍,原来跑一小时的模型,用隐私计算可能要跑四五个小时,成本翻两三倍都是常事。最近两年大模型火了,大家都想拿大模型做联合训练,可千亿级参数的大模型用现有隐私计算方案跑,成本高到没人用得起,现在行业里也都在攻关这个问题,不少科研团队都出了新的加密协议,能把通信成本降个百分之七八十,已经好很多了,但离随便用还有距离。
第二个就是标准不统一的问题。早几年各家做隐私计算平台,都是自己搞自己的技术框架,你用A家的我用B家的,我俩要合作做项目,光适配接口就要折腾一两个月,折腾完还不一定能跑通。还好去年国内出了第一个隐私计算的国家级技术标准,接下来慢慢统一接口和协议,这个问题慢慢就能解决。
还有就是安全的问题,经常有人问我,隐私计算真的百分百安全吗?说实话,哪有百分百安全的技术啊?前两年也有科研成果说,可以通过模型交互的参数反推部分原始用户信息,虽然这种攻击的成本很高,成功率也低,但确实说明隐私计算的安全防护还要继续补漏洞。最近一年国内高校和大厂研究院的相关成果发了不少,都是在补安全和性能的短板,比如上个月我看到阿里达摩院发的科研成果,把联邦学习的通信开销降了90%以上,还提升了安全性,这就是好事情。
其实我们普通人根本不用懂什么技术原理,你只要知道,现在你接到的垃圾推销短信比几年前少了,你办贷款的时候不用反复给不同机构交你的身份信息,这背后就有隐私计算技术的功劳。它默默帮你把你的数据锁在了该在的地方,还能让数据帮你享受到更好的服务。
上次再跟那个做合规的朋友吃饭,他说现在手里十个数据合作项目,有七八个都会用上隐私计算,原来的死局活了,甲方满意,合规也过了,大家都开心。
技术从来都是这样,能解决真问题,就是好技术。对吧?